I-cap ang gastos ng isang LLM batch sa Python: isang ledger at isang hard budget
I-log ang tokens at gastos ng bawat API call sa isang JSONL file, ihinto ang batch sa isang budget, at tantiyahin ang bill bago mo ito patakbuhin. Kasama ang Python code.
Sa pahinang ito
Ang iyong script ay umiikot sa 200 prompt, isinasara mo ang takip ng laptop, at sa umaga nalaman mo kung magkano ang ginastos ng gabi. Dalawang maliit na gawi ang nag-aayos niyan. Pagkatapos ng bawat API call, magdagdag ng isang linya na may tokens at gastos sa isang ledger file. Bago ang bawat call, ihambing ang running total sa budget at huminto kung naabot na ito. Wala pang 50 linya ng Python iyon, at ang 5-prompt na trial run ay nagsasabi sa iyo ng bill bago magsimula ang tunay na run.
Ano ang ginagawa ng Clocktower run na maaari mong kopyahin#
Si Dwarkesh Patel, host ng Dwarkesh Podcast, ay nagpatakbo ng 11 modelo laban sa isa't isa sa Blood on the Clocktower, 386 na laro ayon sa README, at inilathala ang code, logs at ratings (github.com/dwarkeshsp/clocktower, sinuri noong 8 Nobyembre 2026). Dalawang detalye mula sa repo ang sulit nakawin. Ang bawat game directory ay may per-call log na may tokens at gastos, at ang gastos ay napupunta sa games/. Ang --budget flag ay naglilimita sa kabuuang gastos; ang default ay $1,000. Ang benchmark site ay nagdadagdag ng ikatlong guard: bawat modelo ay nakakakuha ng parehong 8,000-token na kisame kada turn (clocktowerbench.com).
Kaya: isang kisame sa bawat call, isang log ng bawat call, isang cap sa kabuuan. Kailangan ng isang tournament ang tatlo, at gayundin ang iyong overnight run, mas maliit lang.
Isipin ang ledger bilang receipt roll sa till ng isang tindahan. Bawat benta ay nagpi-print ng isang linya; maaaring pagsamahin ng manager ang roll anumang oras at alam niya kung ubos na ang float ng araw.
Ang ledger: isang file, isang linya kada call#
Narito ang buong bagay. Ginagamit nito ang openai package na nakaturo sa CheapTokens (https:/, tingnan ang docs para sa key at sa mga model id).
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
Ang bawat call ay dumadaan sa parehong apat na hakbang:
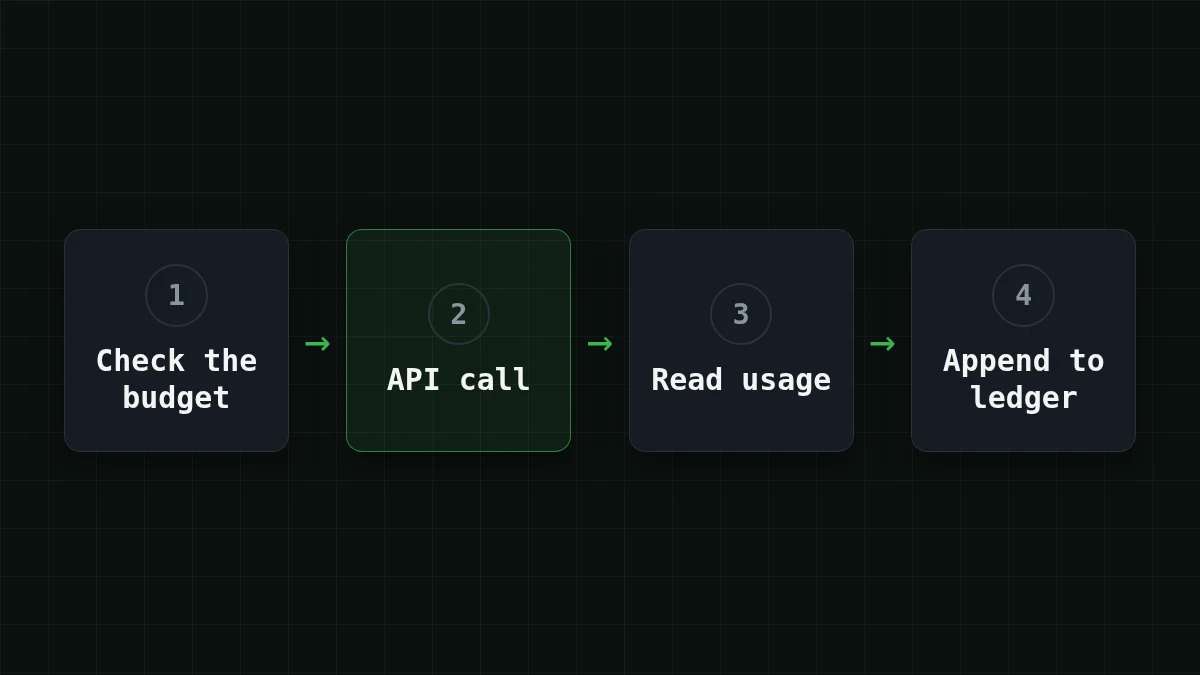
Tatlong pagpipilian doon ang sinadya.
- Isang JSON object kada linya (JSONL), binuksan sa append mode. Kung mag-crash ang script sa call 130, ang calls 1 hanggang 129 ay nasa disk na.
- Ang total ay galing sa file, hindi sa variable. I-restart ang script at hawak pa rin ang cap, dahil natatandaan ng ledger kung magkano ang ginastos ng nakaraang run.
- Ang
finish_reasonay naka-log katabi ng tokens. Ang row na nagsasabinglengthay nangangahulugang naabot ng sagot ang iyongmax_tokensat naputol. Kakailanganin mong malaman iyon mamaya.
Ang dalawang PRICE_ constant ay placeholder. Kunin ang kasalukuyang numero mula sa pricing table. Para sa DeepSeek-V4-Flash sa oras na binabasa mo ito, iyon ay $0.015 kada 1M input tokens at $0.10 kada 1M output tokens. Palitan ang MODEL ng zai- o MiniMaxAI/ at ang dalawang constant, at gumagana ang parehong ledger para sa kanila.
Ang batch loop: laktawan ang tapos na, huminto sa cap#
Maikli ang loop. Sabihin nating ang iyong mga prompt ay nasa dict na naka-key sa unit id, ang pangalan ng isang piraso ng trabaho, tulad ng doc-001:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
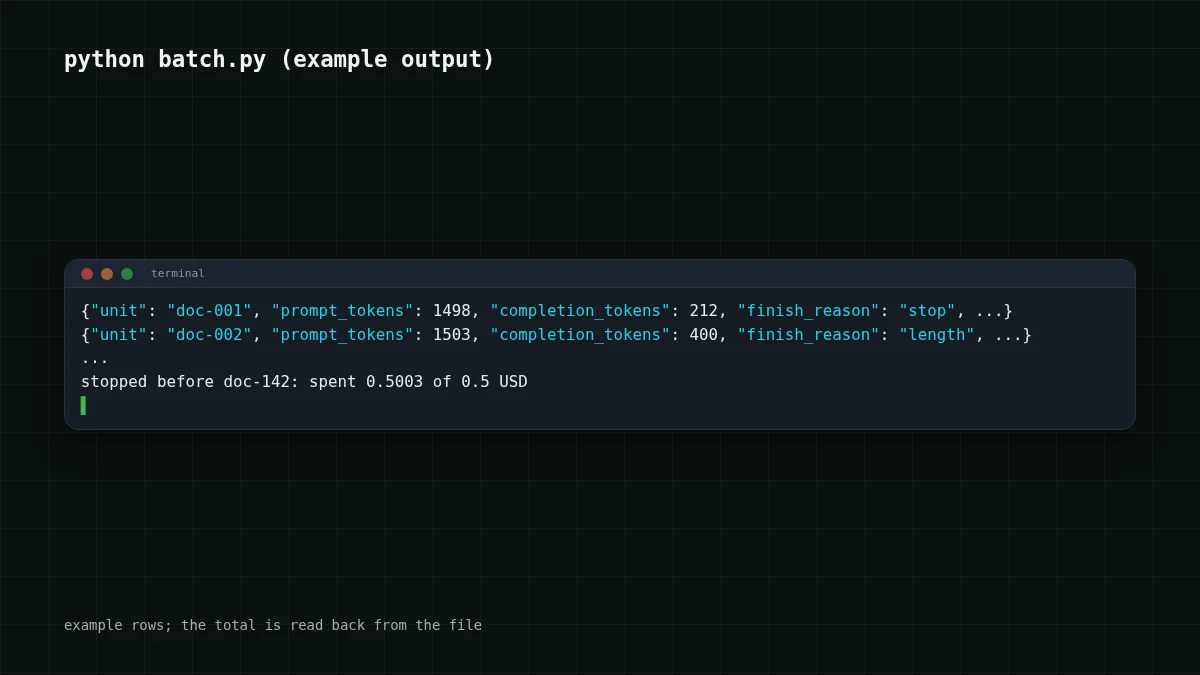
Patakbuhin ito, pindutin ang Ctrl+C sa kalagitnaan, patakbuhin muli: nilalaktawan ang mga tapos nang unit, kaya ang ledger ay nagsisilbing progress file mo rin. Hayaang maubos ang budget at makakakuha ka ng isang linya sa halip na sorpresa, tulad ng stopped before doc-.
Pansinin ang salitang bago. Ang pagsusuri ay nangyayari bago ang bawat call, kaya ang huling call ay maaaring magtulak sa total nang bahagya lampas sa budget. May hangganan kung gaano kalayo: ang isang call ay hindi maaaring gumastos nang higit sa iyong pinakamahabang prompt plus max_tokens. Para sa 1,500-token na prompt at max_tokens=400 iyon ay hindi hihigit sa $0.000063. Kaya bawat call sa wrapper ay may max_tokens: ginagawa nitong numero na maaari mong planuhan ang isang bukas na panganib.
Tantiyahin ang bill bago mo pindutin ang run#
Ngayon ang kabilang kalahati: alam ang gastos bago mag-launch. Patakbuhin ang unang limang prompt sa ask() na may maliit na budget at basahin ang ledger. Sabihin nating ang limang row ay may average na 1,500 input tokens at 400 output tokens. Iyon ang iyong mga numero para sa buong batch.
Para sa 200 prompt iyon ay 200 × 1,500 = 300,000 input tokens at 200 × 400 = 80,000 output tokens. Narito ang workload na iyon sa live na presyo:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 200 mga kahilingan | OpenRouter, 200 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
1,500 input at 400 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
May OpenRouter column din ang table. Kapag pinagsama ang input at output, mas mura ang DeepSeek-V4-Flash kaysa sa OpenRouter para sa load na ito, at ang sum na iyon ang talagang binabayaran ng batch.
Nagkakaiba ang haba ng mga prompt, kaya ang limang sample ay hula, hindi pangako. Gamitin ang pinakamahaba sa lima kapag gusto mo ng safe na upper side, pagkatapos hayaang saluhin ng budget cap ang natitira. Gusto mong ihambing ang dalawang modelo sa parehong 200 prompt? Bigyan ang bawat modelo ng sariling ledger file, halimbawa Ledger(f'ledger-, at magkatabi ang dalawang total pagkatapos.
Subukan ang sarili mong batch dito: itakda ang tokens kada request mula sa iyong sample at kung ilang request ang plano mong gawin.
Calculator ng gastos
Ang iyong batch: tokens mula sa iyong 5-prompt sample
Mga input token bawat kahilingan: 1,500 · Mga output token bawat kahilingan: 400 · Mga kahilingan bawat araw: 200
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
Para sa higit pa sa pagbilang ng tokens bago magpadala, tingnan ang pagbilang ng tokens gamit ang tiktoken.
Kapag mas malaki ang bill kaysa inaasahan: basahin ang ledger#
Ang ikatlong reader scenario ay ang masama. May agent run na nagkamali at nag-loop, at ang dashboard ay nagpapakita lamang ng total. Ipinapakita ng ledger kung saan napunta. Ayusin ang mga row ayon sa gastos:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
Para sa isang agent, pangalanan ang unit ayon sa hakbang (step-17) para makita mo ang hugis ng run. May mga pattern na paulit-ulit na lumalabas; itugma ang bawat isa sa karaniwang dahilan nito:
Itugma ang mga pares
Itugma ang bawat ledger pattern sa karaniwang dahilan nito
I-tap ang isang item sa kaliwa, pagkatapos ang pares nito
- Ang prompt_tokens ay lumalaki nang kaunti sa bawat rowIpinapadala muli ng loop ang buong history sa bawat hakbang
- Ang completion_tokens ay katumbas ng max_tokens at ang finish_reason ay lengthNaputol ang mga sagot sa iyong cap, at binabayaran mo ang naputol na text
- Ang parehong unit ay lumalabas nang maraming beses nang sunod-sunodIsang retry loop, o agent na inuulit ang isang hakbang
- Ang isang row ay gumagastos nang malayo higit sa lahat ng ibaIsang sobrang laking input, tulad ng buong file na na-paste sa prompt
Ang bawat pattern ay nakikita sa ledger matagal bago ang invoice. Ang una ay saklaw sa bakit binabasa muli ng agent ang history nito.
Kung gusto mo rin ng gastos kada project at mga alerto sa labas ng script, ang gabay na ito sa per-project budget alerts ay sumasaklaw sa panig na iyon. Ang ledger dito ay ang bahaging nasa iyong code at makakapagsabi ng stop.
Bago ka mag-launch#
Listahan ng dapat gawin
Bago ang unang tunay na run
Ang context size at answer limit ng DeepSeek-V4-Flash, kapaki-pakinabang kapag pumipili ka ng max_tokens, ay nasa page nito: DeepSeek-V4-Flash sa CheapTokens.


