I-estimate ang API cost ng isang model tournament bago mo ito patakbuhin
Bilangin ang tokens per seat, i-multiply sa mga laro at side swap, at maglagay ng hard cap sa Python: isang worked estimate para sa 6-seat, 60-game na model tournament.
Sa pahinang ito
Maaari mong malaman ang bayarin ng isang model tournament bago ang unang request: bilangin ang mga token na ipinapadala ng isang upuan sa buong laro, i-multiply sa mga upuan at laro, at maglagay ng hard cap sa code. Ang bahaging madalas hindi napapansin ay ang history. Bawat turn ay muling ipinapadala ang lahat ng nasabi na, kaya mas mabilis lumaki ang input kaysa sa bilang ng mga turn.
Ano ang sinasabi at hindi sinasabi ng $20,000 na headline#
Noong 5 Nobyembre 2026, inilathala ng podcaster na si Dwarkesh Patel ang Clocktower Bench, isang benchmark kung saan naglalabanan ang mga modelo sa social-deduction game na Blood on the Clocktower. Sinabi niyang gumastos siya ng humigit-kumulang $20,000 na API credits sa pagbuo ng harness, at malaki ang napunta sa pag-iterate sa disenyo ng environment, higit pa sa mga token na pinlano niya.
Inilalarawan ng README ng proyekto (sinuri noong 8 Nobyembre 2026) ang setup: 11 modelo, 386 laro para sa headline ranking, isang modelo ang naglalaro sa lahat ng good seat at isa pa sa lahat ng evil seat, 10–12 manlalaro, mga larong tumatagal ng ilang oras. Bawat deal ay muling nilalaro nang pinalitan ang panig, kaya walang modelo ang nakakakuha ng mas madaling role. May kasama rin itong libreng dry run (--model random), isinusulat ang gastos sa games/, at may --budget cap na default na $1,000.
Ang hindi nito ibinibigay ay ang tokens per game. Kaya walang makokopya; ikaw mismo ang gagawa ng estimate. Iyon ang ginagawa ng natitirang bahagi ng artikulong ito, gamit ang mga nakasaad na assumption na maaari mong palitan ng sarili mo.
Isang upuan: bakit patuloy na lumalaki ang input#
Sabihin nating magpapatakbo ka ng mas maliit na laro: 6 na upuan, bawat upuan ay isang modelo na may sariling conversation, 20 turn bawat upuan. Ipagpalagay ang 2,000-token system prompt (mga patakaran at role ng upuan), 600 bagong token ng table talk na dumarating bago ang bawat turn, at 300-token na sagot. Walang memory ang API, kaya dala ng bawat request ang buong conversation muli (bakit mas mahal ang mahabang chat).
Ang Turn 1 ay nagpapadala ng 2,000 + 600 = 2,600 token. Ang Turn 20 ay nagpapadala ng 2,000 + 600 × 20 + 300 × 19 = 19,700. Subukan mo mismo ang huling numero:
Hulaan ang numero
Ilang input token ang ipinapadala ng isang upuan sa ika-20 turn nito?
Ang iyong hula
040,000
Ipakita ang sagot
Sagot: 19,700
19,700: ang 2,000-token system prompt, 20 × 600 ng bagong usapan, at 19 na naunang sagot na tig-300. Bumabalik ang bawat lumang sagot at bawat lumang mensahe.
Pagsamahin ang lahat ng 20 turn para sa isang upuan: 2,000 × 20 + 600 × 210 + 300 × 190 = 40,000 + 126,000 + 57,000 = 223,000 input token. Ang output ay 20 × 300 = 6,000 lamang. Kung bibilangin mo ang bawat mensahe nang isang beses, makakakuha ka ng 2,000 + 20 × 600 = 14,000 at malalayo ka nang labing-anim na beses.
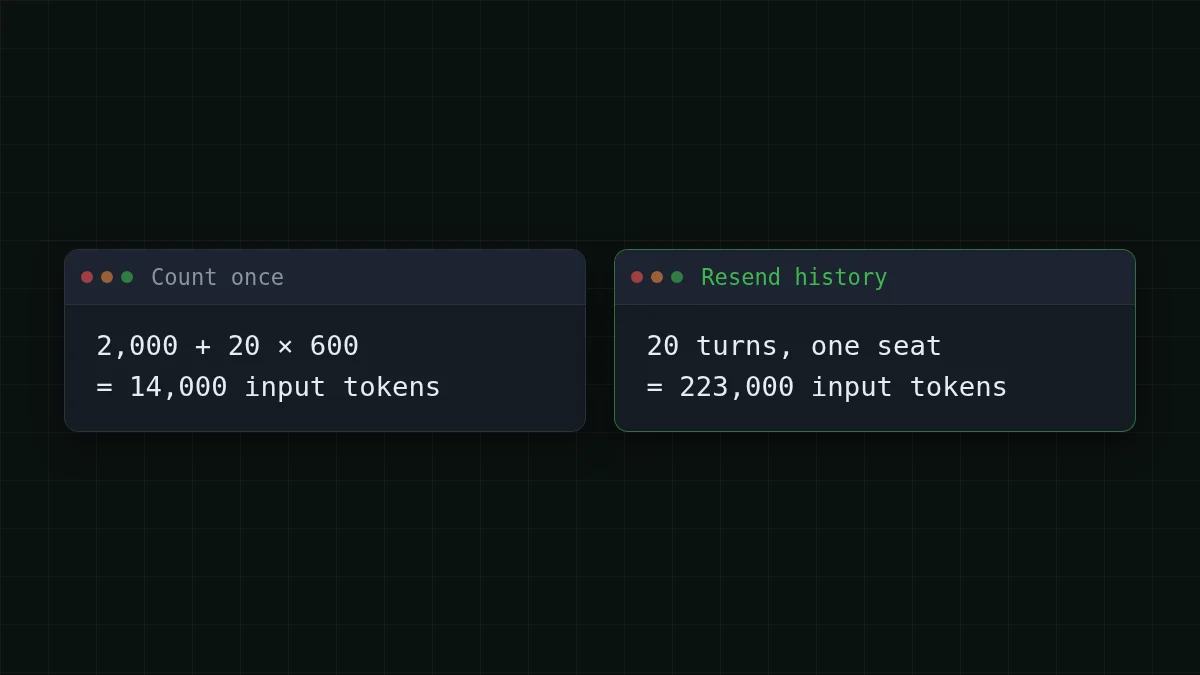
Halos hindi gumagalaw ang output side. Sa input napupunta ang pera, at iyon ang side na lumalala habang humahaba ang mga laro.
Mula sa isang upuan patungo sa buong tournament#
Ngayon i-scale ito gamit ang tatlong multiplier.
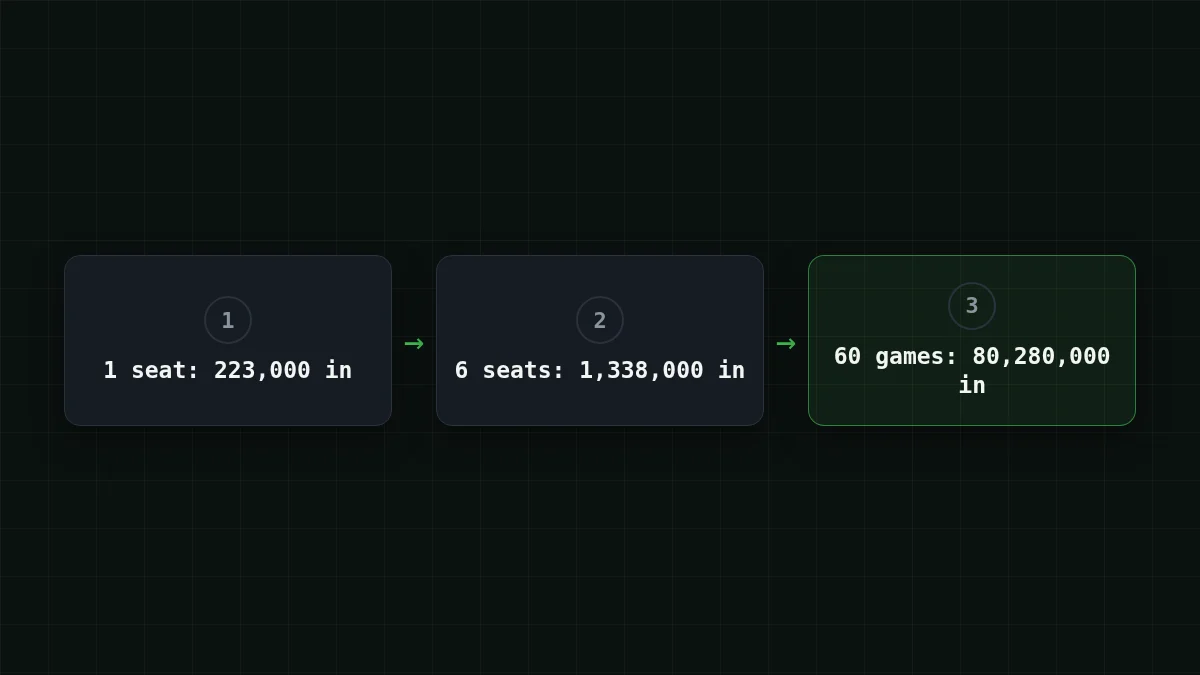
- Mga upuan. 6 na upuan × 223,000 = 1,338,000 input token at 6 × 6,000 = 36,000 output token bawat laro.
- Side swap. Kumuha ng 3 modelo sa round robin: 3 pairing. Maglaro ng 10 deal bawat pairing, bawat isa ay dalawang beses nang pinalitan ang panig: 3 × 10 × 2 = 60 laro.
- Mga laro. 60 × 1,338,000 = 80,280,000 input at 60 × 36,000 = 2,160,000 output token para sa tournament.
Ang isang laro sa DeepSeek-V4-Flash ay umaabot sa $0.0237. Ang talahanayan sa ibaba ay nagpe-presyo sa buong 60-laro na tournament na parang iisang modelo ang naglaro sa lahat ng upuan, para maikumpara mo ang tatlong modelong inaalok ng CheapTokens para sa ganitong uri ng long-conversation na trabaho. Sa kabuuan, kasama ang input at output, mas mura ang bawat isa sa kanila kaysa sa OpenRouter reference sa huling column.
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 60 mga kahilingan | OpenRouter, 60 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
1,338,000 input at 36,000 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Sa usapin ng budget, ito ang buong trick: hindi mo kailangan ng $20,000 na line item para malaman kung alin sa tatlong modelo ang mas mahusay maglaro ng negotiation game. Kailangan mo ang estimate sa itaas, at pagkatapos ay isang tunay na pilot para i-check ito.
Mabilisang pagsusuri
Ang iyong 6-seat na laro ay mula 20 patungong 40 turn bawat upuan. Ano ang nangyayari sa input bill?
Ipakita ang sagot
Sagot: Lumalaki ito nang mga 3.6 beses
Para sa 40 turn, ang parehong formula ay nagbibigay ng 2,000 × 40 + 600 × 820 + 300 × 780 = 806,000 input token, kumpara sa 223,000 para sa 20 turn. Ang history term ay lumalaki nang parisukat ng bilang ng turn.
Dalawang check bago mo paniwalaan ang anumang ganyang numero. Una, dapat kasya ang pinakamalaking request sa window ng modelo. Sa 20 turn, ang pinakamalaking request ay 19,700 token, walang problema. Ang multi-hour na laro na may 200 turn bawat upuan ay umaabot sa 2,000 + 600 × 200 + 300 × 199 = 181,700, mga 182K, kaya basahin ang context size sa page ng modelo bago mo idisenyo ang laro. Ang DeepSeek-V4-Flash ay may 380K na window at hanggang 32,768 output token; tingnan ang page ng modelo. Pangalawa, kung ang isang modelo ay naglalabas ng mahabang reasoning, ang 300 output token mo ay magiging mas marami (thinking tokens sa isang bulk job).
Maglagay ng hard cap sa code#
Ang --budget flag ng README ay tamang ideya, at sampung linya lang para kopyahin sa sarili mong harness. Ang script sa ibaba ay nag-e-estimate bago ito tumakbo, tumatanggi sa pagpapadala ng request na maaaring magtulak sa total na lumampas sa cap, at nagla-log ng bawat call sa isang ledger file. Ang mga presyo dito ay halimbawa lamang: palitan ng mga kasalukuyan mula sa pricing table.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
Ang estimate(6, 20) ay nagpi-print ng (1338000, 36000), ang parehong per-game na numero sa itaas, kaya nagche-check ang code at ang arithmetic sa isa't isa. Ang usage. at usage. ay galing sa response at iyon ang sinisingil sa iyo; ang pre-check ay gumagamit ng pessimistic na character count dahil ang tunay na bilang ay malalaman lamang pagkatapos ng call. Higit pa sa per-project ledgers sa pag-track ng agent token cost sa Python.
Isang ligtas na pagkakasunod-sunod para sa unang run#
Ang sariling sequence ng repo ay magandang modelo: libre muna, mura pangalawa, mahal sa huli. Ilagay ang mga hakbang na ito sa tamang pagkakasunod-sunod:
Ilagay sa tamang pagkakasunod-sunod
Ilagay sa tamang pagkakasunod-sunod ang mga hakbang ng ligtas na unang run
I-drag ang mga item o gamitin ang mga arrow
- Dry run gamit ang random player, walang API calls
- Patakbuhin ang
estimate()at ikumpara ito sa iyong cap - Maglaro ng isang tunay na laro at basahin ang ledger
- Itama ang mga assumption gamit ang tunay na token counts
- Ilunsad ang buong tournament nang naka-on ang cap
Sinasabi ng README na ang demo game sa murang mga modelo ay nagkakahalaga ng mga $2–5. Pahayag iyon ng may-akda at hindi pinangalanan ang mga modelo, kaya ituring itong sanity range, hindi quote para sa iyong setup. Ang sarili mong pilot game ang magbibigay ng numerong mahalaga: kung ang ledger nito ay nagpapakita ng 1,500,000 input token kung saan inassume mo ang 1,338,000, may natutunan ka sa halagang ilang sentimo kaysa sa ika-40 laro.
Para sa mas mahabang eksperimento, ang karaniwang levers ay nasa pag-trim ng chat history: bawasan ang kailangang muling basahin ng bawat upuan, at liliit kasama nito ang quadratic term. Kapag handa ka nang patakbuhin ito, nasa the docs ang endpoint at model ids.


