Оптимізація витратПосібник
Оцініть вартість API турніру моделей до його запуску
Порахуйте токени на місце, помножте на ігри та зміни сторін і задайте жорсткий ліміт у Python: розрахункова оцінка для турніру моделей на 6 місць і 60 ігор.
На цій сторінці
Ви можете дізнатися рахунок за турнір моделей ще до першого запиту: порахуйте токени, які одне місце надсилає за всю гру, помножте на кількість місць і ігор та задайте жорсткий ліміт у коді. Те, що люди часто пропускають, — це історія. Кожен хід повторно надсилає все сказане досі, тож вхідні дані зростають набагато швидше, ніж кількість ходів.
Що говорить і чого не говорить заголовок про $20 000#
5 листопада 2026 року подкастер Дваркеш Патель опублікував Clocktower Bench — бенчмарк, де моделі грають у соціально-дедуктивну гру Blood on the Clocktower одна проти одної. Він каже, що витратив близько $20 000 API-кредитів на створення тестового стенда, і що значна частина пішла на ітерації з дизайну середовища, більше, ніж він планував на токени.
README проєкту (перевірено 8 листопада 2026 року) описує налаштування: 11 моделей, 386 ігор для рейтингу в заголовку, одна модель грає за всі добрі місця, а інша — за всі злі, 10–12 гравців, ігри, що тривають кілька годин. Кожна роздача повторюється зі зміною сторін, тож жодна модель не отримує легшу роль. Також є безкоштовний пробний запуск (--model random), витрати записуються в games/, і є ліміт --budget, який за замовчуванням становить $1 000.
Чого він не дає — це токенів на гру. Тож нема чого копіювати; ви будуєте оцінку самі. Саме це робить решта статті, з явними припущеннями, які ви можете замінити на свої.
Одне місце: чому вхідні дані постійно зростають#
Скажімо, ви запускаєте меншу гру: 6 місць, кожне місце — це модель зі своєю розмовою, 20 ходів на місце. Припустімо, системний промпт на 2 000 токенів (правила та роль місця), 600 нових токенів застільної бесіди, що надходять перед кожним ходом, і відповідь на 300 токенів. API не має пам'яті, тож кожен запит знову несе всю розмову (чому довгий чат коштує дорожче).
Хід 1 надсилає 2 000 + 600 = 2 600 токенів. Хід 20 надсилає 2 000 + 600 × 20 + 300 × 19 = 19 700. Спробуйте останнє число самі:
Вгадайте число
Скільки вхідних токенів надсилає місце на своєму 20-му ході?
Ваше припущення
040 000
Показати відповідь
Відповідь: 19 700
19 700: системний промпт на 2 000 токенів, 20 × 600 нової бесіди та 19 попередніх відповідей по 300 кожна. Кожна стара відповідь і кожне старе повідомлення повертаються назад.
Підсумуйте всі 20 ходів для одного місця: 2 000 × 20 + 600 × 210 + 300 × 190 = 40 000 + 126 000 + 57 000 = 223 000 вхідних токенів. Вихід — лише 20 × 300 = 6 000. Якби ви порахували кожне повідомлення один раз, ви отримали б 2 000 + 20 × 600 = 14 000 і помилилися б у шістнадцять разів.
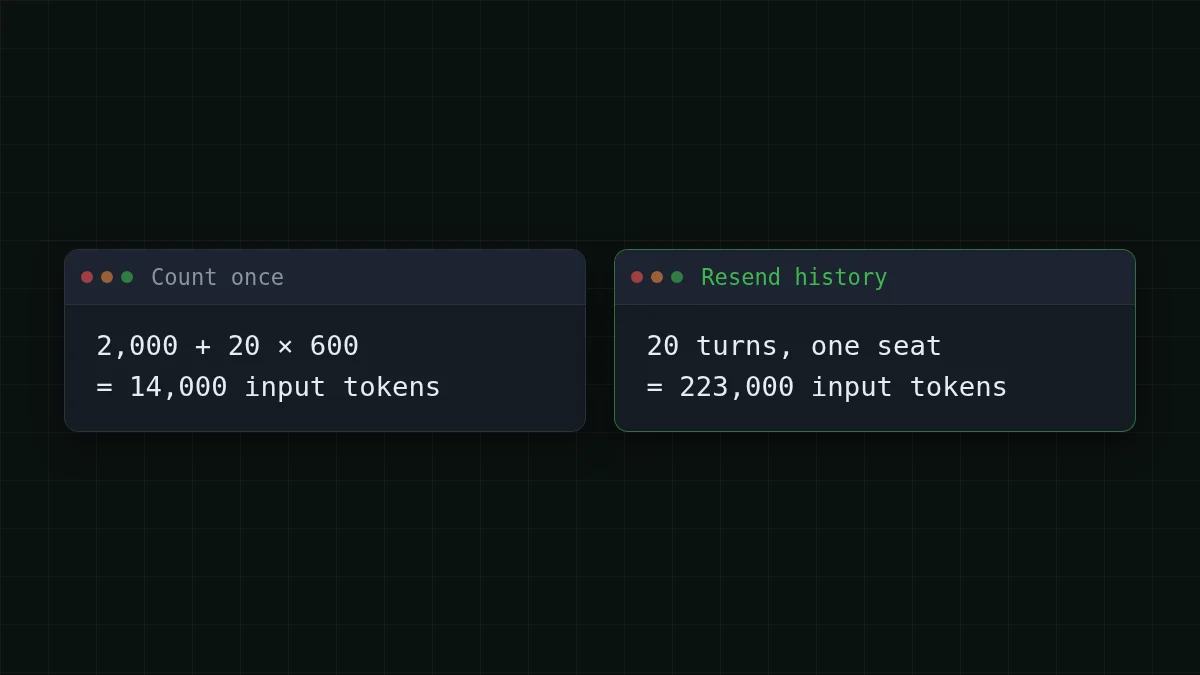
Вихідна сторона майже не змінюється. Гроші йдуть на вхід, і саме ця сторона погіршується з подовженням ігор.
Від одного місця до цілого турніру#
Тепер масштабуйте це трьома множниками.
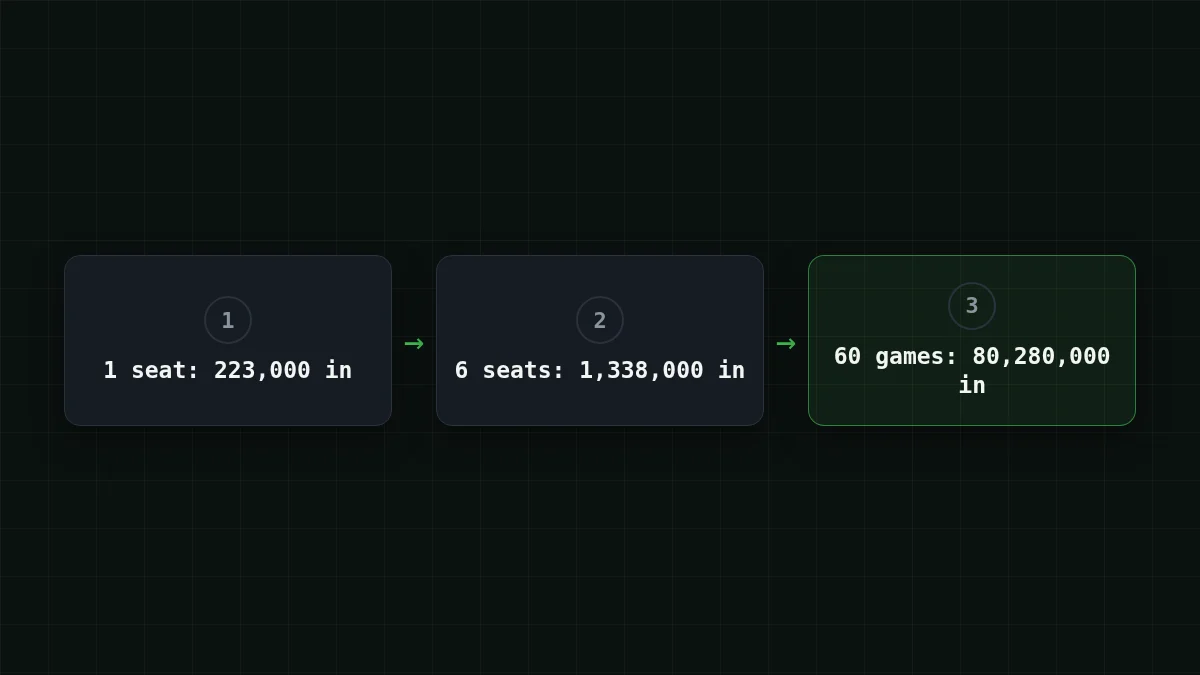
- Місця. 6 місць × 223 000 = 1 338 000 вхідних токенів і 6 × 6 000 = 36 000 вихідних токенів на гру.
- Зміна сторін. Візьміть 3 моделі в круговому турнірі: 3 пари. Зіграйте 10 роздач на пару, кожну двічі зі зміною сторін: 3 × 10 × 2 = 60 ігор.
- Ігри. 60 × 1 338 000 = 80 280 000 вхідних і 60 × 36 000 = 2 160 000 вихідних токенів для турніру.
Одна гра на DeepSeek-V4-Flash коштує $0.0237. Таблиця нижче оцінює весь турнір із 60 ігор так, ніби ця одна модель грала за кожне місце, щоб ви могли порівняти три моделі, які CheapTokens пропонує для такого типу роботи з довгими розмовами. Загалом, з урахуванням вхідних і вихідних даних разом, кожна з них дешевша за референс OpenRouter в останньому стовпці.
| Модель | Вхід $/1М | Вихід $/1М | За запит | 60 запитів | OpenRouter, 60 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
1 338 000 вхідних і 36 000 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
З погляду бюджету це весь трюк: вам не потрібна стаття витрат на $20 000, щоб дізнатися, яка з трьох моделей краще грає в гру-переговори. Вам потрібна оцінка вище, а потім реальний пілотний запуск, щоб її перевірити.
Швидка перевірка
Ваша гра на 6 місць переходить з 20 до 40 ходів на місце. Що станеться з рахунком за вхідні дані?
Показати відповідь
Відповідь: Він зросте приблизно в 3,6 раза
Для 40 ходів та сама формула дає 2 000 × 40 + 600 × 820 + 300 × 780 = 806 000 вхідних токенів проти 223 000 для 20 ходів. Член історії зростає як квадрат кількості ходів.
Дві перевірки, перш ніж довіряти будь-якому такому числу. По-перше, найбільший запит має вміщатися у вікно моделі. На 20 ходах найбільший запит — 19 700 токенів, без проблем. Багатогодинна гра з 200 ходами на місце сягає 2 000 + 600 × 200 + 300 × 199 = 181 700, приблизно 182K, тож прочитайте розмір контексту на сторінці моделі, перш ніж проєктувати гру. DeepSeek-V4-Flash має вікно 380K і до 32 768 вихідних токенів; дивіться сторінку моделі. По-друге, якщо модель генерує довгі міркування, ваші 300 вихідних токенів стають більшими (токени міркувань у масовій задачі).
Задайте жорсткий ліміт у коді#
Прапорець --budget з README — правильна ідея, і його копіювання у ваш власний стенд займе десять рядків. Скрипт нижче оцінює перед запуском, відмовляється надсилати запит, який міг би перевищити ліміт, і записує кожен виклик у файл журналу. Ціни в ньому — приклад: підставте актуальні з таблиці цін.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) виводить (1338000, 36000), ті самі числа на гру, що й вище, тож код і арифметика перевіряють одне одного. usage. і usage. надходять із відповіді й саме за них ви платите; попередня перевірка використовує песимістичний підрахунок символів, бо справжня кількість відома лише після виклику. Більше про журнали на проєкт у відстеженні вартості токенів агента в Python.
Безпечний порядок для першого запуску#
Власна послідовність репозиторію — хороша модель: спочатку безкоштовно, потім дешево, дорого — останнім. Розставте ці кроки по порядку:
Розставте по порядку
Розставте кроки безпечного першого запуску по порядку
Перетягніть елементи або скористайтеся стрілками
- Пробний запуск із випадковим гравцем, без викликів API
- Запустіть
estimate()і порівняйте з вашим лімітом - Зіграйте одну реальну гру та прочитайте журнал
- Виправте припущення реальними підрахунками токенів
- Запустіть повний турнір із увімкненим лімітом
README каже, що демонстраційна гра на дешевих моделях коштує близько $2–5. Це твердження автора, і моделі не названі, тож сприймайте це як орієнтовний діапазон, а не як кошторис для вашого налаштування. Ваша власна пілотна гра дає число, яке має значення: якщо її журнал показує 1 500 000 вхідних токенів там, де ви припускали 1 338 000, ви дізналися дещо за кілька центів, а не на 40-й грі.
Для довших експериментів звичайні важелі описані в обрізанні історії чату: скоротіть те, що кожне місце має перечитувати, і квадратичний член зменшиться разом із ним. Коли будете готові запускати, документація містить endpoint і ідентифікатори моделей.


