Optymalizacja kosztówPrzewodnik
Oszacuj koszt API turnieju modeli, zanim go uruchomisz
Policz tokeny na miejsce, pomnóż przez gry i zamiany stron, i ustaw twardy limit w Pythonie: opracowany szacunek dla 6-miejscowego turnieju modeli z 60 grami.
Na tej stronie
Możesz poznać rachunek za turniej modeli jeszcze przed pierwszym zapytaniem: policz tokeny, które jedno miejsce wysyła przez całą grę, pomnóż przez liczbę miejsc i gier, i ustaw twardy limit w kodzie. To, co ludzie przeoczają, to historia. Każda tura ponownie wysyła wszystko, co powiedziano do tej pory, więc wejście rośnie znacznie szybciej niż liczba tur.
Co mówi, a czego nie mówi nagłówek o 20 000 dolarów#
5 listopada 2026 r. podcaster Dwarkesh Patel opublikował Clocktower Bench, benchmark, w którym modele grają przeciwko sobie w grę dedukcji społecznej Blood on the Clocktower. Twierdzi, że wydał około 20 000 dolarów kredytów API na zbudowanie środowiska testowego i że znaczna część poszła na iterowanie nad projektem środowiska, więcej niż na tokeny, które planował.
README projektu (sprawdzone 8 listopada 2026 r.) opisuje konfigurację: 11 modeli, 386 gier w rankingu głównym, jeden model grający na każdym dobrym miejscu i inny na każdym złym, 10–12 graczy, gry trwające kilka godzin. Każde rozdanie jest rozgrywane ponownie ze zamienionymi stronami, więc żaden model nie dostaje łatwiejszej roli. Zawiera też darmowy przebieg próbny (--model random), zapisuje wydatki do games/ i ma limit --budget domyślnie ustawiony na 1000 dolarów.
Czego nie podaje, to tokenów na grę. Więc nie ma czego kopiować; sam budujesz szacunek. To robi reszta tego artykułu, z podanymi założeniami, które możesz zamienić na własne.
Jedno miejsce: dlaczego wejście wciąż rośnie#
Załóżmy, że prowadzisz mniejszą grę: 6 miejsc, każde miejsce to model z własną rozmową, 20 tur na miejsce. Przyjmij 2000-tokenowy prompt systemowy (zasady i rola miejsca), 600 nowych tokenów rozmowy przy stole przychodzących przed każdą turą i 300-tokenową odpowiedź. API nie ma pamięci, więc każde zapytanie ponownie niesie całą rozmowę (dlaczego długi czat kosztuje więcej).
Tura 1 wysyła 2000 + 600 = 2600 tokenów. Tura 20 wysyła 2000 + 600 × 20 + 300 × 19 = 19 700. Spróbuj sam policzyć ostatnią liczbę:
Zgadnij liczbę
Ile tokenów wejściowych wysyła miejsce w swojej 20. turze?
Twoje przypuszczenie
040 000
Pokaż odpowiedź
Odpowiedź: 19 700
19 700: 2000-tokenowy prompt systemowy, 20 × 600 nowej rozmowy i 19 wcześniejszych odpowiedzi po 300 każda. Każda stara odpowiedź i każda stara wiadomość wraca.
Zsumuj wszystkie 20 tur dla jednego miejsca: 2000 × 20 + 600 × 210 + 300 × 190 = 40 000 + 126 000 + 57 000 = 223 000 tokenów wejściowych. Wyjście to tylko 20 × 300 = 6000. Gdybyś policzył każdą wiadomość raz, dostałbyś 2000 + 20 × 600 = 14 000 i pomyliłbyś się szesnastokrotnie.
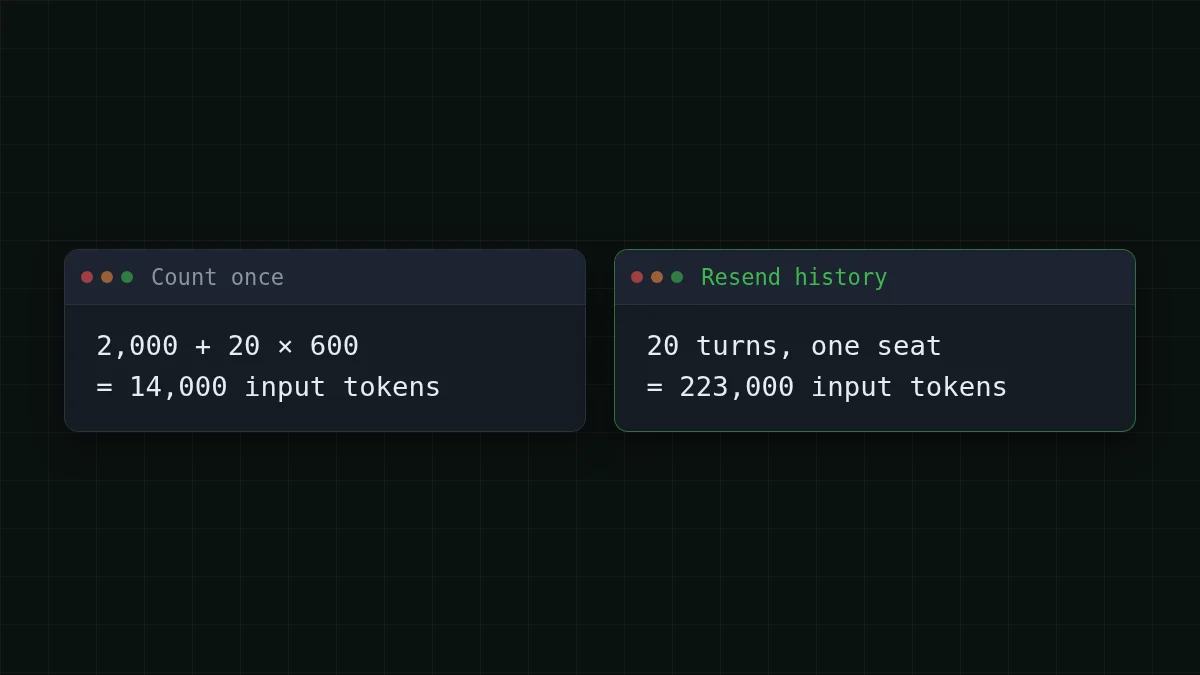
Strona wyjściowa ledwo się zmienia. Wejście to miejsce, w które idą pieniądze, i to strona, która pogarsza się wraz z wydłużaniem gier.
Od jednego miejsca do całego turnieju#
Teraz przeskaluj to trzema mnożnikami.
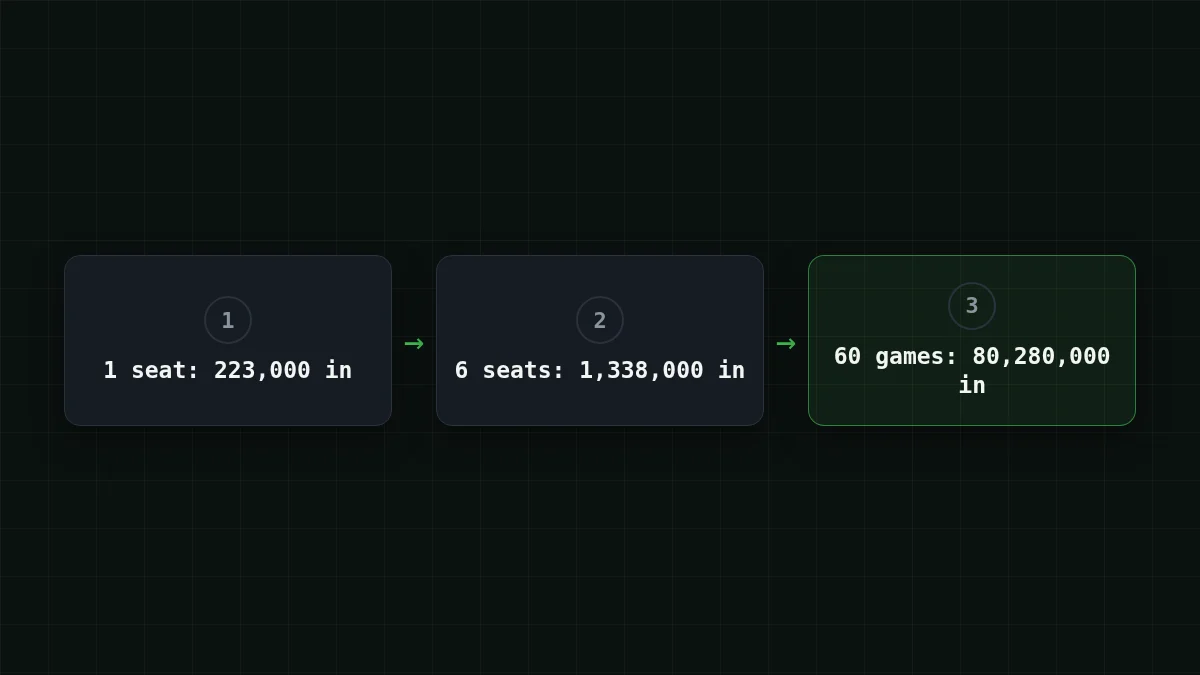
- Miejsca. 6 miejsc × 223 000 = 1 338 000 tokenów wejściowych i 6 × 6000 = 36 000 tokenów wyjściowych na grę.
- Zamiana stron. Weź 3 modele w round robin: 3 pary. Rozegraj 10 rozdań na parę, każde dwa razy ze zamienionymi stronami: 3 × 10 × 2 = 60 gier.
- Gry. 60 × 1 338 000 = 80 280 000 wejściowych i 60 × 36 000 = 2 160 000 wyjściowych tokenów na turniej.
Jedna gra na DeepSeek-V4-Flash kosztuje $0.0237. Poniższa tabela wycenia cały 60-growy turniej tak, jakby ten jeden model grał na każdym miejscu, więc możesz porównać trzy modele oferowane przez CheapTokens do tego rodzaju zadania z długą rozmową. W sumie, licząc wejście i wyjście razem, każdy z nich jest tańszy niż referencja OpenRouter w ostatniej kolumnie.
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 60 żądań | OpenRouter, 60 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
1 338 000 tokenów wejściowych i 36 000 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Budżetowo to cała sztuczka: nie potrzebujesz pozycji o wartości 20 000 dolarów, aby dowiedzieć się, który z trzech modeli lepiej gra w grę negocjacyjną. Potrzebujesz powyższego szacunku, a potem prawdziwego pilotażu, aby go sprawdzić.
Szybkie sprawdzenie
Twoja 6-miejscowa gra przechodzi z 20 na 40 tur na miejsce. Co dzieje się z rachunkiem za wejście?
Pokaż odpowiedź
Odpowiedź: Rośnie około 3,6 razy
Dla 40 tur ten sam wzór daje 2000 × 40 + 600 × 820 + 300 × 780 = 806 000 tokenów wejściowych, w porównaniu do 223 000 dla 20 tur. Człon historii rośnie z kwadratem liczby tur.
Dwa sprawdzenia, zanim zaufasz takiej liczbie. Po pierwsze, największe zapytanie musi mieścić się w oknie modelu. Przy 20 turach największe zapytanie to 19 700 tokenów, bez problemu. Wielogodzinna gra z 200 turami na miejsce osiąga 2000 + 600 × 200 + 300 × 199 = 181 700, około 182K, więc przeczytaj rozmiar kontekstu na stronie modelu, zanim zaprojektujesz grę. DeepSeek-V4-Flash ma okno 380K i do 32 768 tokenów wyjściowych; zobacz stronę modelu. Po drugie, jeśli model generuje długie rozumowanie, twoje 300 tokenów wyjściowych staje się większe (tokeny myślenia w zadaniu wsadowym).
Ustaw twardy limit w kodzie#
Flaga --budget z README to właściwy pomysł, a skopiowanie jej do własnego środowiska testowego zajmuje dziesięć linii. Poniższy skrypt szacuje przed uruchomieniem, odmawia wysłania zapytania, które mogłoby przekroczyć limit, i loguje każde wywołanie do pliku księgi. Ceny w nim są przykładowe: zastąp je aktualnymi z tabeli cen.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) wypisuje (1338000, 36000), te same liczby na grę co powyżej, więc kod i arytmetyka sprawdzają się nawzajem. usage. i usage. pochodzą z odpowiedzi i to za nie płacisz; wstępne sprawdzenie używa pesymistycznego liczenia znaków, ponieważ prawdziwa liczba jest znana dopiero po wywołaniu. Więcej o księgach na projekt w śledzeniu kosztu tokenów agenta w Pythonie.
Bezpieczna kolejność pierwszego uruchomienia#
Własna sekwencja repozytorium to dobry wzorzec: najpierw darmowo, potem tanio, na końcu drogo. Ułóż te kroki w kolejności:
Ustaw w kolejności
Ułóż kroki bezpiecznego pierwszego uruchomienia w kolejności
Przeciągnij elementy lub użyj strzałek
- Przebieg próbny z losowym graczem, bez wywołań API
- Uruchom
estimate()i porównaj z limitem - Rozegraj jedną prawdziwą grę i przeczytaj księgę
- Popraw założenia rzeczywistymi liczbami tokenów
- Uruchom pełny turniej z włączonym limitem
README mówi, że gra demonstracyjna na tanich modelach kosztuje około 2–5 dolarów. To stwierdzenie autora, a modele nie są nazwane, więc traktuj to jako zakres kontrolny, a nie wycenę dla twojej konfiguracji. Twoja własna gra pilotażowa daje liczbę, która ma znaczenie: jeśli jej księga pokazuje 1 500 000 tokenów wejściowych, gdy zakładałeś 1 338 000, nauczyłeś się czegoś za kilka centów, a nie przy grze 40.
W przypadku dłuższych eksperymentów zwykłe dźwignie są w przycinaniu historii czatu: wytnij to, co każde miejsce musi ponownie przeczytać, a człon kwadratowy się zmniejszy. Gdy będziesz gotowy to uruchomić, dokumentacja zawiera endpoint i identyfikatory modeli.


