Tối ưu chi phíHướng dẫn
Ước tính chi phí API của một giải đấu mô hình trước khi chạy
Đếm token mỗi ghế, nhân với số ván và số lần đổi phe, rồi đặt giới hạn cứng bằng Python: một ước tính cụ thể cho giải đấu mô hình 6 ghế, 60 ván.
Trên trang này
Bạn có thể biết trước hóa đơn của một giải đấu mô hình ngay từ trước yêu cầu đầu tiên: đếm số token mà một ghế gửi đi trong cả một ván, nhân với số ghế và số ván, rồi đặt một giới hạn cứng trong mã. Điều mọi người hay bỏ sót là lịch sử. Mỗi lượt đều gửi lại toàn bộ những gì đã nói từ trước, nên đầu vào tăng nhanh hơn nhiều so với số lượt.
Con số $20,000 trên tiêu đề nói và không nói điều gì#
Ngày 5 tháng 11 năm 2026, podcaster Dwarkesh Patel công bố Clocktower Bench, một benchmark trong đó các mô hình chơi trò suy luận xã hội Blood on the Clocktower với nhau. Ông cho biết đã chi khoảng $20,000 tín dụng API để xây dựng harness, và phần lớn số đó dành cho việc lặp đi lặp lại thiết kế môi trường, nhiều hơn số token mà ông đã dự tính.
README của dự án (kiểm tra ngày 8 tháng 11 năm 2026) mô tả cách thiết lập: 11 mô hình, 386 ván cho bảng xếp hạng chính, một mô hình chơi mọi ghế phe thiện và một mô hình khác chơi mọi ghế phe ác, 10–12 người chơi, mỗi ván kéo dài vài giờ. Mỗi ván chia bài được chơi lại với hai phe đổi chỗ, để không mô hình nào nhận vai dễ hơn. Dự án cũng có sẵn một lượt chạy thử miễn phí (--model random), ghi chi phí vào games/, và có giới hạn --budget mặc định là $1,000.
Điều nó không cung cấp là số token mỗi ván. Vậy nên không có gì để sao chép; bạn tự xây dựng ước tính. Đó là việc phần còn lại của bài viết này làm, với các giả định được nêu rõ mà bạn có thể thay bằng giả định của mình.
Một ghế: vì sao đầu vào cứ tăng mãi#
Giả sử bạn chạy một ván nhỏ hơn: 6 ghế, mỗi ghế là một mô hình với cuộc hội thoại riêng, 20 lượt mỗi ghế. Giả định system prompt 2,000 token (luật chơi và vai của ghế), 600 token trò chuyện bàn mới đến trước mỗi lượt, và câu trả lời 300 token. API không có bộ nhớ, nên mỗi yêu cầu đều mang theo toàn bộ cuộc hội thoại một lần nữa (vì sao một cuộc trò chuyện dài tốn hơn).
Lượt 1 gửi 2,000 + 600 = 2,600 token. Lượt 20 gửi 2,000 + 600 × 20 + 300 × 19 = 19,700. Hãy tự thử con số cuối:
Đoán số
Một ghế gửi bao nhiêu token đầu vào ở lượt thứ 20?
Dự đoán của bạn
040.000
Hiện đáp án
Trả lời: 19.700
19,700: system prompt 2,000 token, 20 × 600 trò chuyện mới, và 19 câu trả lời trước đó mỗi câu 300. Mọi câu trả lời cũ và mọi tin nhắn cũ đều được gửi lại.
Cộng tất cả 20 lượt cho một ghế: 2,000 × 20 + 600 × 210 + 300 × 190 = 40,000 + 126,000 + 57,000 = 223,000 token đầu vào. Đầu ra chỉ có 20 × 300 = 6,000. Nếu bạn đếm mỗi tin nhắn một lần, bạn sẽ được 2,000 + 20 × 600 = 14,000 và lệch mười sáu lần.
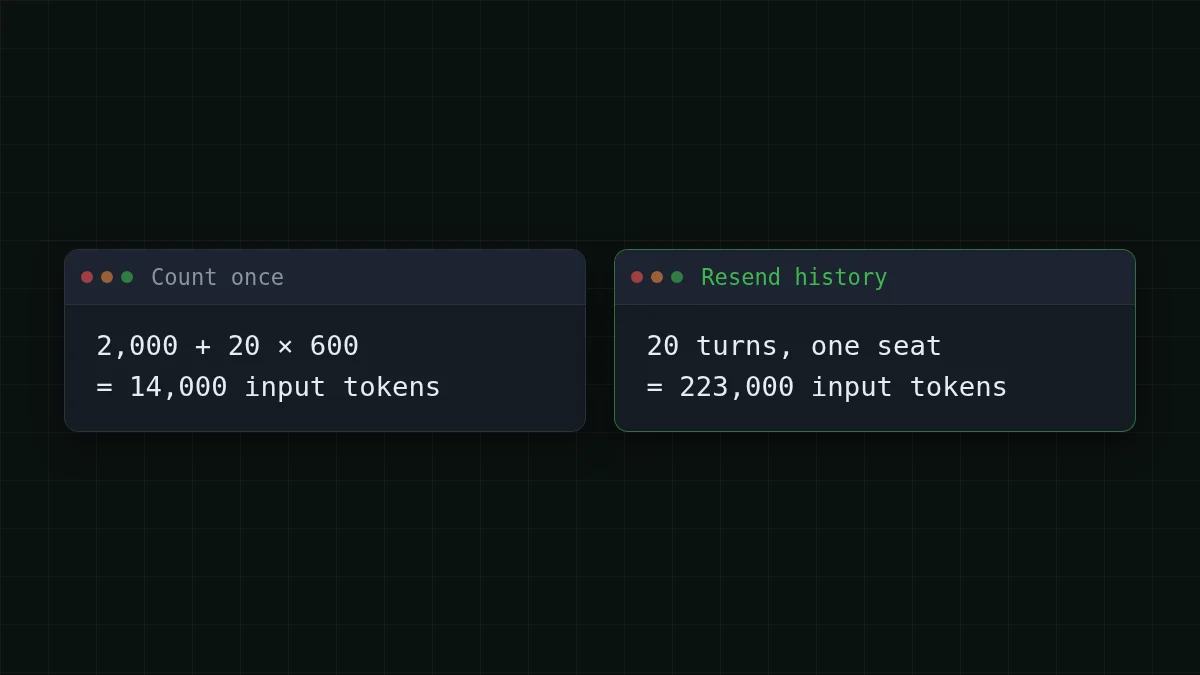
Phía đầu ra hầu như không thay đổi. Đầu vào là nơi tiền chảy đi, và đó là phía trở nên tệ hơn khi ván chơi dài hơn.
Từ một ghế đến cả một giải đấu#
Giờ hãy nhân rộng với ba hệ số.
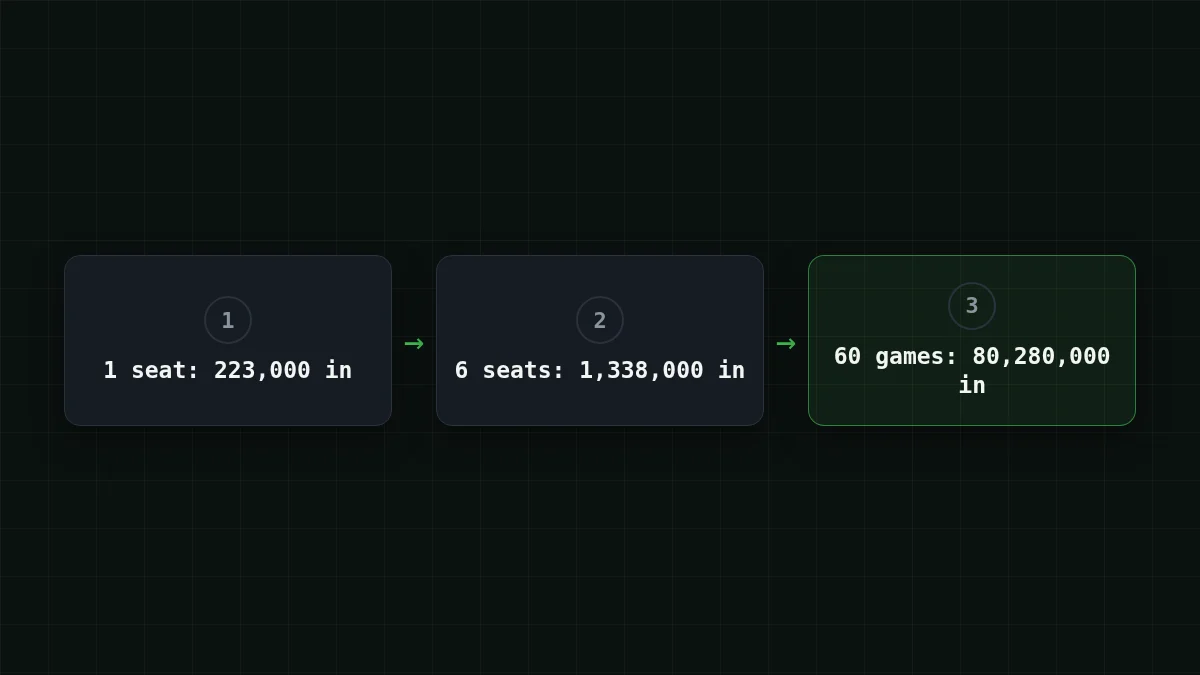
- Số ghế. 6 ghế × 223,000 = 1,338,000 token đầu vào và 6 × 6,000 = 36,000 token đầu ra mỗi ván.
- Đổi phe. Lấy 3 mô hình trong một vòng tròn: 3 cặp đấu. Chơi 10 ván mỗi cặp, mỗi ván hai lần với hai phe đổi chỗ: 3 × 10 × 2 = 60 ván.
- Số ván. 60 × 1,338,000 = 80,280,000 đầu vào và 60 × 36,000 = 2,160,000 token đầu ra cho cả giải đấu.
Một ván trên DeepSeek-V4-Flash tốn $0.0237. Bảng dưới đây tính giá cho cả giải đấu 60 ván như thể mô hình đó chơi mọi ghế, để bạn có thể so sánh ba mô hình mà CheapTokens cung cấp cho loại công việc hội thoại dài này. Tổng cộng, khi tính cả đầu vào và đầu ra, mỗi mô hình trong số đó đều rẻ hơn mức tham chiếu OpenRouter ở cột cuối.
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 60 yêu cầu | OpenRouter, 60 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
1.338.000 token đầu vào và 36.000 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Về ngân sách, đây chính là toàn bộ mẹo: bạn không cần một khoản mục $20,000 để biết mô hình nào trong ba mô hình chơi trò đàm phán giỏi hơn. Bạn cần ước tính ở trên, rồi một lượt chạy thử thực tế để kiểm tra nó.
Kiểm tra nhanh
Ván 6 ghế của bạn tăng từ 20 lên 40 lượt mỗi ghế. Hóa đơn đầu vào thay đổi thế nào?
Hiện đáp án
Trả lời: Tăng khoảng 3.6 lần
Với 40 lượt, cùng công thức cho 2,000 × 40 + 600 × 820 + 300 × 780 = 806,000 token đầu vào, so với 223,000 cho 20 lượt. Số hạng lịch sử tăng theo bình phương số lượt.
Hai kiểm tra trước khi bạn tin bất kỳ con số nào như vậy. Thứ nhất, yêu cầu lớn nhất phải vừa với cửa sổ của mô hình. Ở 20 lượt, yêu cầu lớn nhất là 19,700 token, không vấn đề gì. Một ván kéo dài nhiều giờ với 200 lượt mỗi ghế đạt 2,000 + 600 × 200 + 300 × 199 = 181,700, khoảng 182K, nên hãy đọc kích thước ngữ cảnh trên trang của mô hình trước khi thiết kế ván chơi. DeepSeek-V4-Flash có cửa sổ 380K và tối đa 32,768 token đầu ra; xem trang mô hình. Thứ hai, nếu một mô hình phát ra suy luận dài, 300 token đầu ra của bạn sẽ nhiều hơn (token suy luận trong một công việc hàng loạt).
Đặt một giới hạn cứng trong mã#
Cờ --budget trong README là ý tưởng đúng, và chỉ mất mười dòng để sao chép vào harness của riêng bạn. Đoạn script dưới đây ước tính trước khi chạy, từ chối gửi một yêu cầu có thể đẩy tổng vượt giới hạn, và ghi mọi lệnh gọi vào một tệp sổ cái. Giá trong đó chỉ là ví dụ: hãy thay bằng giá hiện tại từ bảng giá.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) in ra (1338000, 36000), đúng các con số mỗi ván như trên, nên mã và phép tính kiểm tra lẫn nhau. usage. và usage. đến từ phản hồi và là những gì bạn bị tính tiền; bước kiểm tra trước dùng số ký tự bi quan vì số thực chỉ biết được sau lệnh gọi. Thêm về sổ cái theo từng dự án trong theo dõi chi phí token của agent bằng Python.
Một thứ tự an toàn cho lần chạy đầu tiên#
Trình tự của chính repo là một hình mẫu tốt: miễn phí trước, rẻ sau, đắt cuối. Hãy sắp xếp các bước sau theo thứ tự:
Sắp xếp thứ tự
Sắp xếp các bước của một lần chạy đầu tiên an toàn theo thứ tự
Kéo các mục hoặc dùng mũi tên
- Chạy thử với người chơi ngẫu nhiên, không gọi API
- Chạy
estimate()và so sánh với giới hạn của bạn - Chơi một ván thật và đọc sổ cái
- Sửa các giả định bằng số token thực tế
- Khởi chạy toàn bộ giải đấu với giới hạn được bật
README nói một ván demo trên các mô hình rẻ tốn khoảng $2–5. Đó là phát biểu của tác giả và các mô hình không được nêu tên, nên hãy coi đó là một khoảng hợp lý để kiểm tra, không phải báo giá cho thiết lập của bạn. Ván chạy thử của riêng bạn cho con số quan trọng: nếu sổ cái của nó cho thấy 1,500,000 token đầu vào trong khi bạn giả định 1,338,000, bạn đã học được điều gì đó với vài xu thay vì ở ván thứ 40.
Với các thử nghiệm dài hơn, những đòn bẩy thông thường nằm trong cắt bớt lịch sử trò chuyện: cắt bớt những gì mỗi ghế phải đọc lại, và số hạng bậc hai sẽ co lại theo. Khi bạn sẵn sàng chạy, tài liệu có endpoint và các id mô hình.


