Estima el coste de API de un torneo de modelos antes de ejecutarlo
Cuenta tokens por asiento, multiplica por partidas e intercambios de bandos, y pon un límite duro en Python: una estimación resuelta para un torneo de modelos de 6 asientos y 60 partidas.
En esta página
Puedes conocer la factura de un torneo de modelos antes de la primera petición: cuenta los tokens que envía un asiento a lo largo de una partida completa, multiplica por asientos y partidas, y pon un límite duro en el código. Lo que la gente pasa por alto es el historial. Cada turno reenvía todo lo dicho hasta el momento, así que la entrada crece mucho más rápido que el número de turnos.
Qué te dice y qué no te dice un titular de $20,000#
El 5 de noviembre de 2026 el podcaster Dwarkesh Patel publicó Clocktower Bench, un benchmark en el que los modelos juegan al juego de deducción social Blood on the Clocktower entre ellos. Dice que gastó unos $20,000 en créditos de API construyendo el harness, y que buena parte se fue en iterar sobre el diseño del entorno, más que en los tokens que había previsto.
El README del proyecto (consultado el 8 de noviembre de 2026) describe la configuración: 11 modelos, 386 partidas para la clasificación principal, un modelo ocupando todos los asientos buenos y otro todos los malos, 10–12 jugadores, partidas que duran varias horas. Cada reparto se repite con los bandos intercambiados, para que ningún modelo tenga el rol más fácil. También incluye una ejecución en seco gratuita (--model random), escribe el gasto en games/ y tiene un límite --budget que por defecto es $1,000.
Lo que no da es tokens por partida. Así que no hay nada que copiar; construyes la estimación tú mismo. Eso es lo que hace el resto de este artículo, con supuestos declarados que puedes sustituir por los tuyos.
Un asiento: por qué la entrada no deja de crecer#
Supón que ejecutas una partida más pequeña: 6 asientos, cada asiento es un modelo con su propia conversación, 20 turnos por asiento. Asume un prompt de sistema de 2,000 tokens (reglas y el rol del asiento), 600 tokens nuevos de conversación de mesa que llegan antes de cada turno, y una respuesta de 300 tokens. La API no tiene memoria, así que cada petición lleva de nuevo toda la conversación (por qué un chat largo cuesta más).
El turno 1 envía 2,000 + 600 = 2,600 tokens. El turno 20 envía 2,000 + 600 × 20 + 300 × 19 = 19,700. Prueba el último número tú mismo:
Adivina el número
¿Cuántos tokens de entrada envía un asiento en su turno 20?
Tu respuesta
040.000
Mostrar respuesta
Respuesta: 19.700
19,700: el prompt de sistema de 2,000 tokens, 20 × 600 de conversación nueva, y 19 respuestas anteriores de 300 cada una. Cada respuesta antigua y cada mensaje antiguo vuelven a entrar.
Suma los 20 turnos de un asiento: 2,000 × 20 + 600 × 210 + 300 × 190 = 40,000 + 126,000 + 57,000 = 223,000 tokens de entrada. La salida es solo 20 × 300 = 6,000. Si contaras cada mensaje una vez, obtendrías 2,000 + 20 × 600 = 14,000 y te desviarías por un factor de dieciséis.
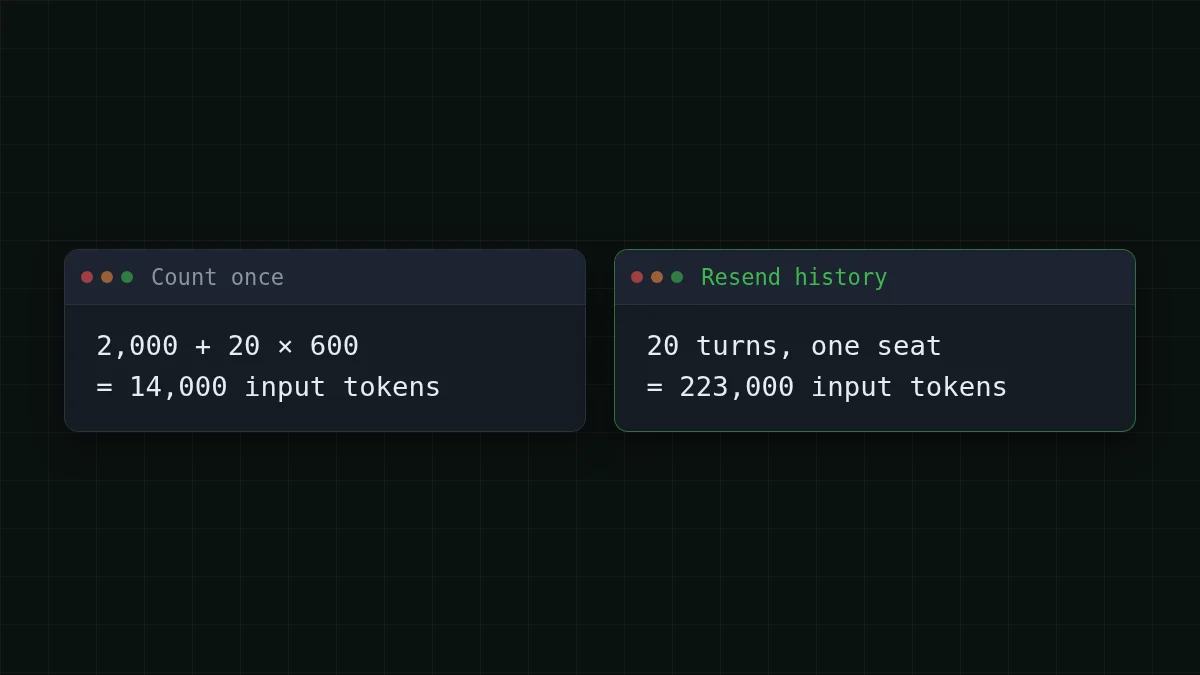
El lado de la salida apenas se mueve. La entrada es donde va el dinero, y es el lado que empeora a medida que las partidas se alargan.
De un asiento a un torneo completo#
Ahora escálalo con tres multiplicadores.
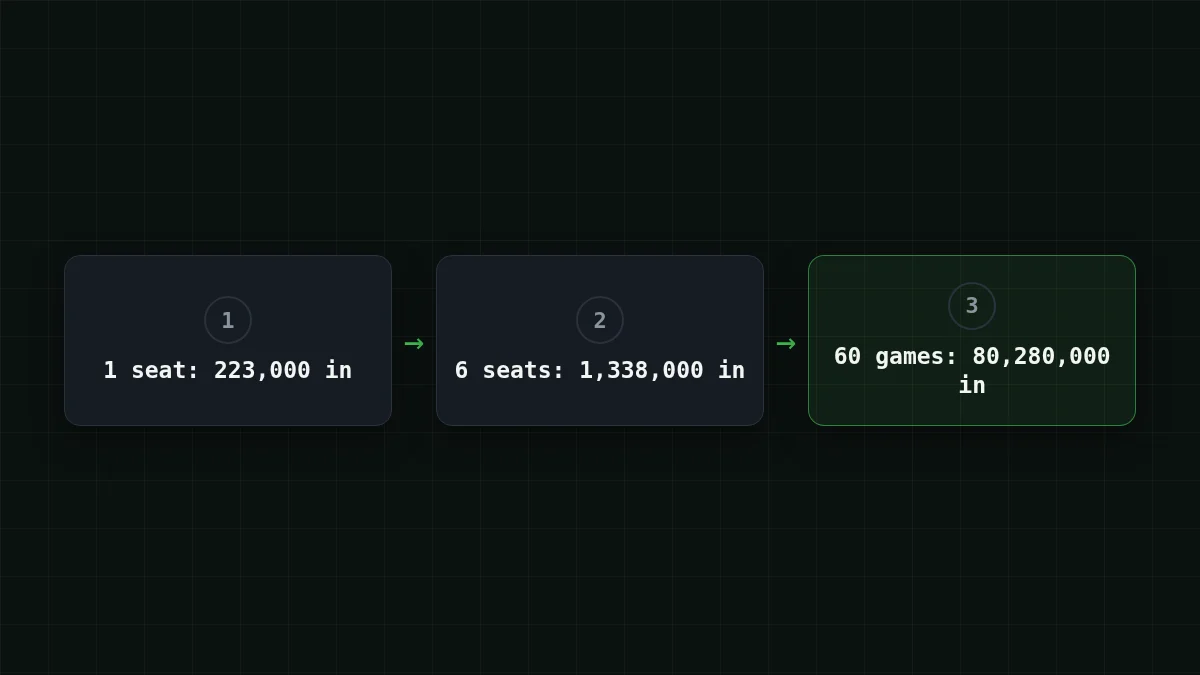
- Asientos. 6 asientos × 223,000 = 1,338,000 tokens de entrada y 6 × 6,000 = 36,000 tokens de salida por partida.
- Intercambio de bandos. Toma 3 modelos en un round robin: 3 emparejamientos. Juega 10 repartos por emparejamiento, cada uno dos veces con los bandos intercambiados: 3 × 10 × 2 = 60 partidas.
- Partidas. 60 × 1,338,000 = 80,280,000 de entrada y 60 × 36,000 = 2,160,000 tokens de salida para el torneo.
Una partida con DeepSeek-V4-Flash sale por $0.0237. La tabla de abajo pone precio al torneo completo de 60 partidas como si ese único modelo ocupara todos los asientos, para que puedas comparar los tres modelos que CheapTokens ofrece para este tipo de trabajo de conversación larga. En total, contando entrada y salida juntas, cada uno de ellos es más barato que la referencia de OpenRouter de la última columna.
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 60 solicitudes | OpenRouter, 60 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
1.338.000 tokens de entrada y 36.000 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En cuanto a presupuesto, este es todo el truco: no necesitas una partida de $20,000 para saber cuál de tres modelos juega mejor a un juego de negociación. Necesitas la estimación de arriba, y luego un piloto real para comprobarla.
Verificación rápida
Tu partida de 6 asientos pasa de 20 a 40 turnos por asiento. ¿Qué le ocurre a la factura de entrada?
Mostrar respuesta
Respuesta: Crece unas 3.6 veces
Para 40 turnos la misma fórmula da 2,000 × 40 + 600 × 820 + 300 × 780 = 806,000 tokens de entrada, frente a 223,000 para 20 turnos. El término del historial crece con el cuadrado del número de turnos.
Dos comprobaciones antes de fiarte de cualquier número así. Primero, la petición más grande debe caber en la ventana del modelo. A 20 turnos la petición más grande es de 19,700 tokens, sin problema. Una partida de varias horas con 200 turnos por asiento llega a 2,000 + 600 × 200 + 300 × 199 = 181,700, unos 182K, así que lee el tamaño de contexto en la página del modelo antes de diseñar la partida. DeepSeek-V4-Flash tiene una ventana de 380K y hasta 32,768 tokens de salida; consulta la página del modelo. Segundo, si un modelo emite razonamiento largo, tus 300 tokens de salida se convierten en más (tokens de pensamiento en un trabajo masivo).
Pon un límite duro en el código#
El flag --budget del README es la idea correcta, y copiarlo a tu propio harness lleva diez líneas. El script de abajo estima antes de ejecutar, se niega a enviar una petición que podría empujar el total por encima del límite, y registra cada llamada en un archivo de libro mayor. Los precios que contiene son un ejemplo: sustituye los actuales de la tabla de precios.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) imprime (1338000, 36000), los mismos números por partida que arriba, así que el código y la aritmética se comprueban mutuamente. usage. y usage. vienen de la respuesta y son por lo que se te factura; la comprobación previa usa un recuento de caracteres pesimista porque el recuento real solo se conoce después de la llamada. Más sobre libros mayores por proyecto en seguimiento del coste de tokens de agentes en Python.
Un orden seguro para la primera ejecución#
La secuencia del propio repo es un buen modelo: primero gratis, después barato, por último caro. Pon estos pasos en orden:
Poner en orden
Pon en orden los pasos de una primera ejecución segura
Arrastra los elementos o usa las flechas
- Ejecución en seco con un jugador aleatorio, sin llamadas a la API
- Ejecuta
estimate()y compáralo con tu límite - Juega una partida real y lee el libro mayor
- Corrige los supuestos con los recuentos reales de tokens
- Lanza el torneo completo con el límite activado
El README dice que una partida de demostración con modelos baratos cuesta unos $2–5. Es una afirmación del autor y los modelos no se nombran, así que trátalo como un rango de cordura, no como un presupuesto para tu configuración. Tu propia partida piloto da el número que importa: si su libro mayor muestra 1,500,000 tokens de entrada donde asumiste 1,338,000, has aprendido algo por unos céntimos en lugar de en la partida 40.
Para experimentos más largos, las palancas habituales están en recortar el historial de chat: recorta lo que cada asiento tiene que releer, y el término cuadrático se reduce con ello. Cuando estés listo para ejecutarlo, la documentación tiene el endpoint y los ids de modelo.


