Limita el coste de un lote de LLM en Python: un registro y un presupuesto estricto
Registra los tokens y el coste de cada llamada a la API en un archivo JSONL, detén el lote en un presupuesto y estima la factura antes de ejecutarlo. Código Python incluido.
En esta página
Tu script recorre 200 prompts, cierras la tapa del portátil y por la mañana descubres lo que costó la noche. Dos pequeños hábitos lo solucionan. Después de cada llamada a la API, añade una línea con los tokens y el coste a un archivo de registro. Antes de cada llamada, compara el total acumulado con un presupuesto y detente si se ha alcanzado. Son menos de 50 líneas de Python, y una prueba de 5 prompts te dice la factura antes de que empiece la ejecución real.
Qué hace la ejecución de Clocktower que puedes copiar#
Dwarkesh Patel, presentador del Dwarkesh Podcast, enfrentó 11 modelos entre sí en Blood on the Clocktower, 386 partidas según el README, y publicó el código, los registros y las clasificaciones (github.com/dwarkeshsp/clocktower, consultado el 8 de noviembre de 2026). Dos detalles del repositorio merecen ser copiados. Cada directorio de partida guarda un registro por llamada con tokens y coste, y el gasto va a games/. Un flag --budget limita el gasto total; el valor por defecto es $1,000. El sitio del benchmark añade una tercera protección: cada modelo recibe el mismo techo de 8.000 tokens por turno (clocktowerbench.com).
Así que: un techo en cada llamada, un registro de cada llamada, un límite en el total. Un torneo necesita los tres, y tu ejecución nocturna también, solo que más pequeña.
Piensa en el registro como el rollo de recibos de la caja de una tienda. Cada venta imprime una línea; el gerente puede sumar el rollo en cualquier momento y sabe cuándo se ha agotado el fondo del día.
El registro: un archivo, una línea por llamada#
Aquí está todo. Usa el paquete openai apuntando a CheapTokens (https:/, consulta la documentación para la clave y los ids de modelo).
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
Cada llamada pasa por los mismos cuatro pasos:
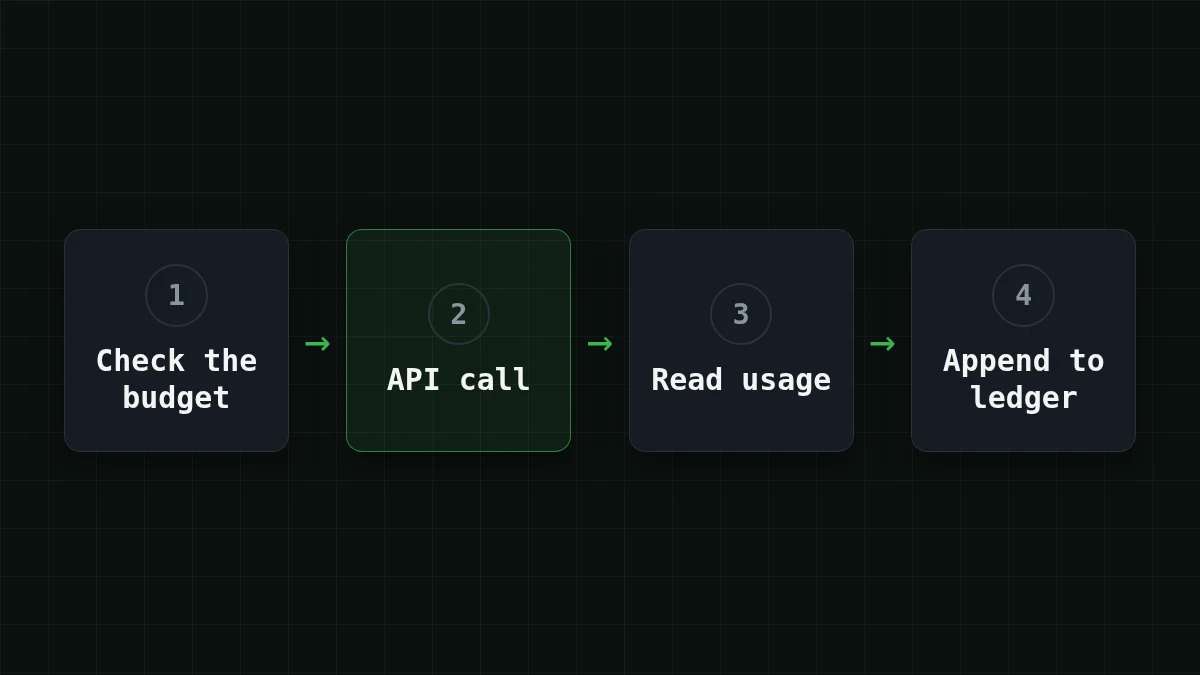
Tres decisiones ahí son deliberadas.
- Un objeto JSON por línea (JSONL), abierto en modo append. Si el script falla en la llamada 130, las llamadas 1 a 129 ya están en disco.
- El total viene del archivo, no de una variable. Reinicia el script y el límite sigue vigente, porque el registro recuerda lo que gastó la ejecución anterior.
finish_reasonse registra junto a los tokens. Una fila que dicelengthsignifica que la respuesta alcanzó tumax_tokensy se cortó. Querrás saberlo después.
Las dos constantes PRICE_ son marcadores de posición. Toma los números actuales de la tabla de precios. Para DeepSeek-V4-Flash en el momento en que leas esto, son $0.015 por 1M de tokens de entrada y $0.10 por 1M de tokens de salida. Cambia MODEL por zai- o MiniMaxAI/ y las dos constantes, y el mismo registro funciona para ellos.
El bucle por lotes: omite lo hecho, detente en el límite#
El bucle es corto. Digamos que tus prompts están en un dict indexado por un id de unidad, el nombre de una pieza de trabajo, como doc-001:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
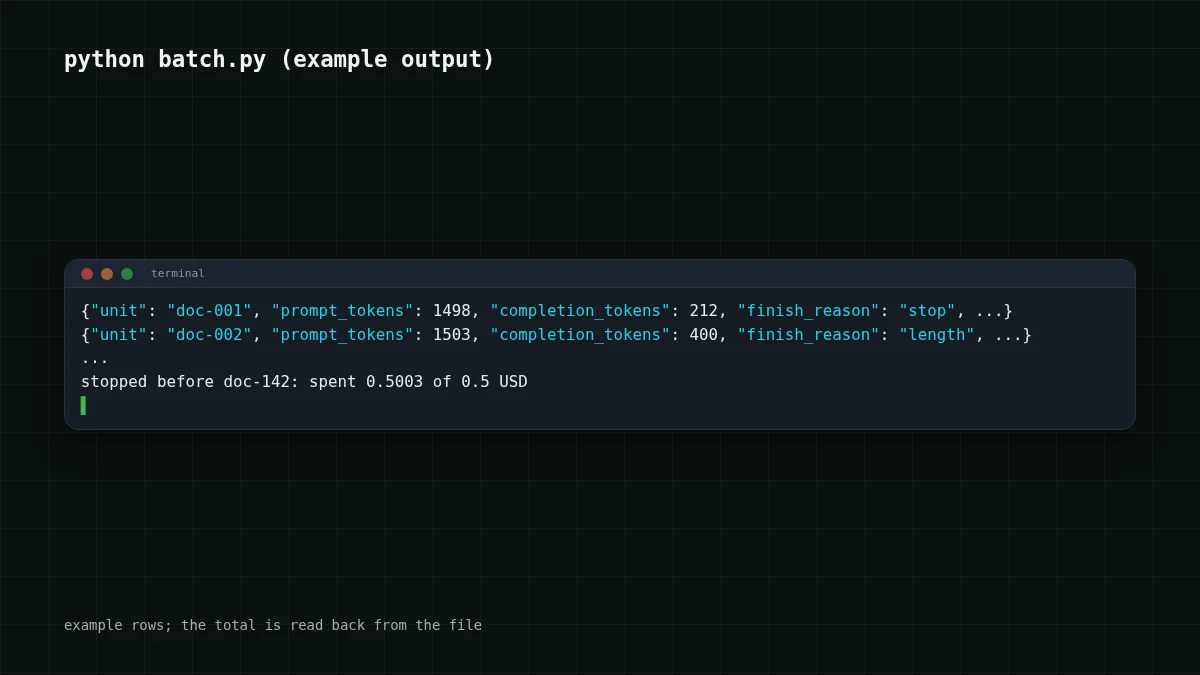
Ejecútalo, pulsa Ctrl+C a mitad, ejecútalo de nuevo: las unidades terminadas se omiten, así que el registro sirve también como archivo de progreso. Deja que el presupuesto se agote y obtendrás una línea en lugar de una sorpresa, algo como stopped before doc-.
Fíjate en la palabra antes. La comprobación ocurre antes de cada llamada, así que la última llamada puede empujar el total ligeramente por encima del presupuesto. Cuánto de más está acotado: una llamada no puede costar más que tu prompt más largo más max_tokens. Para un prompt de 1.500 tokens y max_tokens=400 eso es como máximo $0.000063. Por eso cada llamada en el wrapper tiene un max_tokens: convierte un riesgo abierto en un número con el que puedes planificar.
Estima la factura antes de pulsar ejecutar#
Ahora la otra mitad: conocer el coste antes del lanzamiento. Pasa los primeros cinco prompts por ask() con un presupuesto pequeño y lee el registro. Digamos que las cinco filas promedian 1.500 tokens de entrada y 400 de salida. Esos son tus números para todo el lote.
Para 200 prompts eso es 200 × 1.500 = 300.000 tokens de entrada y 200 × 400 = 80.000 tokens de salida. Aquí está esa carga de trabajo con precios en vivo:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 200 solicitudes | OpenRouter, 200 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
1500 tokens de entrada y 400 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
La tabla tiene también una columna de OpenRouter. Contando entrada y salida juntas, DeepSeek-V4-Flash sale más barato que OpenRouter para esta carga, y esa suma es lo que el lote paga realmente.
Los prompts varían en longitud, así que cinco muestras son una conjetura, no una promesa. Usa el más largo de los cinco cuando quieras un lado superior seguro, y deja que el límite de presupuesto atrape el resto. ¿Quieres comparar dos modelos con los mismos 200 prompts? Da a cada modelo su propio archivo de registro, por ejemplo Ledger(f'ledger-, y los dos totales quedan uno al lado del otro después.
Prueba tu propio lote aquí: establece los tokens por petición a partir de tu muestra y cuántas peticiones planeas.
Calculadora de costos
Tu lote: tokens de tu muestra de 5 prompts
Tokens de entrada por solicitud: 1500 · Tokens de salida por solicitud: 400 · Solicitudes por día: 200
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
Para más información sobre cómo contar tokens antes de enviar, consulta contar tokens con tiktoken.
Cuando la factura es mayor de lo esperado: lee el registro#
El tercer escenario del lector es el desagradable. Una ejecución de agente sale mal y entra en bucle, y el panel solo muestra un total. El registro muestra dónde se fue. Ordena las filas por coste:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
Para un agente, nombra la unidad según el paso (step-17) para que puedas ver la forma de la ejecución. Algunos patrones aparecen una y otra vez; asocia cada uno con su causa habitual:
Emparejar los pares
Asocia cada patrón del registro con su causa habitual
Toca un elemento de la izquierda, luego su par
- prompt_tokens crece un poco en cada filaEl bucle reenvía todo el historial en cada paso
- completion_tokens es igual a max_tokens y finish_reason es lengthLas respuestas se cortan en tu límite, y pagas por el texto cortado
- La misma unidad aparece muchas veces seguidasUn bucle de reintentos, o un agente repitiendo un paso
- Una fila cuesta mucho más que todas las demásUna entrada sobredimensionada, como un archivo entero pegado en el prompt
Cada patrón es visible en el registro mucho antes que en la factura. El primero se trata en por qué un agente relee su historial.
Si también quieres gasto por proyecto y alertas fuera del script, esta guía sobre alertas de presupuesto por proyecto cubre esa parte. El registro de aquí es la parte que vive en tu código y puede decir basta.
Antes de lanzar#
Lista de verificación
Antes de la primera ejecución real
El tamaño de contexto y el límite de respuesta de DeepSeek-V4-Flash, útiles cuando eliges max_tokens, están en su página: DeepSeek-V4-Flash en CheapTokens.


