AI สำหรับผู้เริ่มต้นคู่มือ
จำกัดค่าใช้จ่ายของแบตช์ LLM ใน Python: ledger และงบประมาณแบบแข็ง
บันทึกโทเคนและค่าใช้จ่ายของทุกการเรียก API ลงไฟล์ JSONL หยุดแบตช์ที่งบประมาณ และประเมินบิลก่อนรัน รวมโค้ด Python
ในหน้านี้
สคริปต์ของคุณวนลูปผ่าน 200 พรอมต์ คุณปิดฝาแล็ปท็อป และตอนเช้าคุณก็รู้ว่าคืนนั้นใช้เงินไปเท่าไร นิสัยเล็ก ๆ สองอย่างแก้ปัญหานี้ได้ หลังทุกการเรียก API ให้ต่อท้ายหนึ่งบรรทัดที่มีโทเคนและค่าใช้จ่ายลงในไฟล์ ledger ก่อนทุกการเรียก ให้เทียบยอดรวมที่สะสมกับงบประมาณและหยุดถ้าถึงแล้ว นั่นคือโค้ด Python ไม่ถึง 50 บรรทัด และการทดลองรัน 5 พรอมต์จะบอกบิลให้คุณรู้ก่อนการรันจริงจะเริ่ม
สิ่งที่การรัน Clocktower ทำซึ่งคุณลอกได้#
Dwarkesh Patel ผู้ดำเนินรายการ Dwarkesh Podcast รัน 11 โมเดลแข่งกันใน Blood on the Clocktower จำนวน 386 เกมตาม README และเผยแพร่โค้ด บันทึก และคะแนน (github.com/dwarkeshsp/clocktower ตรวจสอบเมื่อ 8 พฤศจิกายน 2026) มีสองรายละเอียดจาก repo ที่น่าลอกมาใช้ แต่ละไดเรกทอรีเกมเก็บ log ต่อการเรียกที่มีโทเคนและค่าใช้จ่าย และค่าใช้จ่ายจะถูกบันทึกไปที่ games/ แฟล็ก --budget จำกัดค่าใช้จ่ายรวม โดยค่าเริ่มต้นคือ $1,000 เว็บไซต์ benchmark เพิ่มการป้องกันที่สาม: ทุกโมเดลได้เพดาน 8,000 โทเคนต่อเทิร์นเท่ากัน (clocktowerbench.com)
ดังนั้น: เพดานต่อการเรียก, log ของแต่ละการเรียก, การจำกัดยอดรวม การแข่งขันต้องมีทั้งสามอย่าง และการรันข้ามคืนของคุณก็เช่นกัน แค่เล็กกว่า
คิดว่า ledger คือม้วนใบเสร็จในลิ้นชักเก็บเงินของร้าน ทุกการขายพิมพ์หนึ่งบรรทัด ผู้จัดการสามารถรวมม้วนได้ทุกเมื่อและรู้ว่าเงินทอนประจำวันหมดเมื่อไร
Ledger: ไฟล์เดียว หนึ่งบรรทัดต่อการเรียก#
นี่คือทั้งหมด ใช้แพ็กเกจ openai ชี้ไปที่ CheapTokens (https:/ ดู docs สำหรับคีย์และ model id)
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
ทุกการเรียกผ่านสี่ขั้นตอนเดียวกัน:
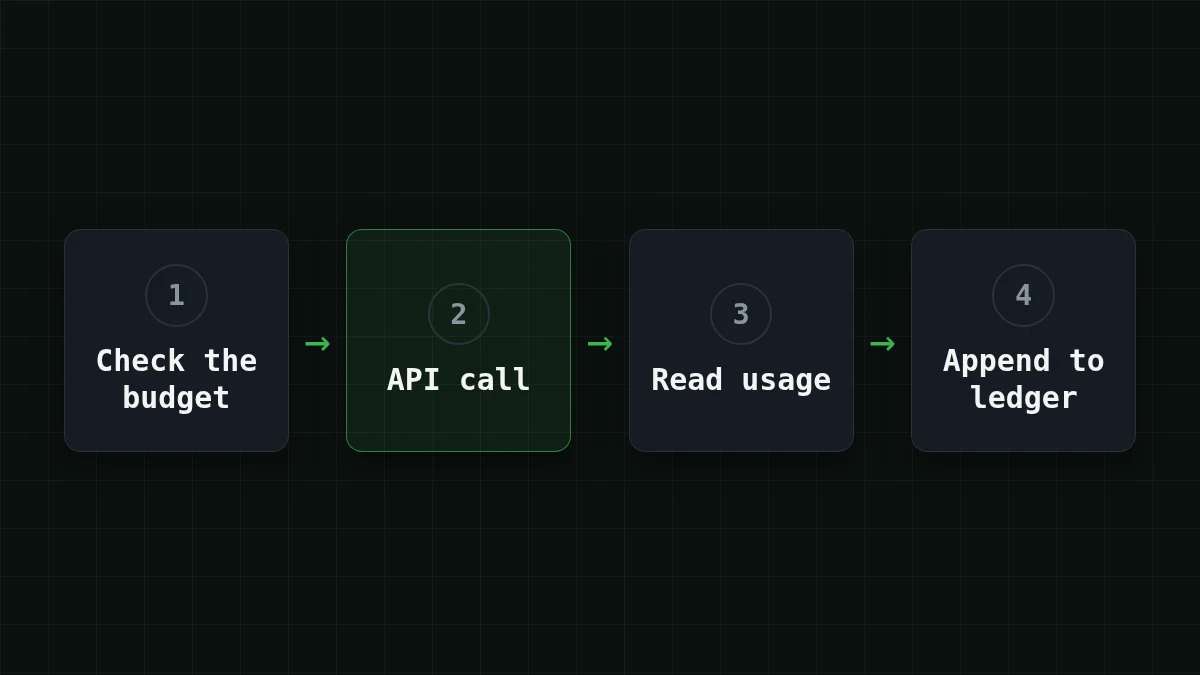
มีสามทางเลือกที่ตั้งใจไว้
- หนึ่ง JSON object ต่อบรรทัด (JSONL) เปิดในโหมด append ถ้าสคริปต์พังที่การเรียกครั้งที่ 130 การเรียกครั้งที่ 1 ถึง 129 ถูกเขียนลงดิสก์แล้ว
- ยอดรวมมาจากไฟล์ ไม่ใช่จากตัวแปร รีสตาร์ทสคริปต์แล้วเพดานยังคงอยู่ เพราะ ledger จำได้ว่าการรันก่อนหน้าใช้ไปเท่าไร
finish_reasonถูกบันทึกข้างโทเคน แถวที่บอกlengthหมายความว่าคำตอบชนmax_tokensและถูกตัด คุณจะอยากรู้เรื่องนั้นภายหลัง
ค่าคงที่ PRICE_ สองตัวเป็นตัวแทน เอาเลขปัจจุบันจาก ตารางราคา สำหรับ DeepSeek-V4-Flash ณ เวลาที่คุณอ่านนี้ คือ $0.015 ต่อ 1M input tokens และ $0.10 ต่อ 1M output tokens เปลี่ยน MODEL เป็น zai- หรือ MiniMaxAI/ พร้อมค่าคงที่สองตัว และ ledger เดียวกันก็ใช้ได้กับโมเดลเหล่านั้น
ลูปแบตช์: ข้ามสิ่งที่ทำแล้ว หยุดที่เพดาน#
ลูปสั้น สมมติว่าพรอมต์ของคุณอยู่ใน dict ที่มีคีย์เป็น unit id ชื่อของงานหนึ่งชิ้น เช่น doc-001:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
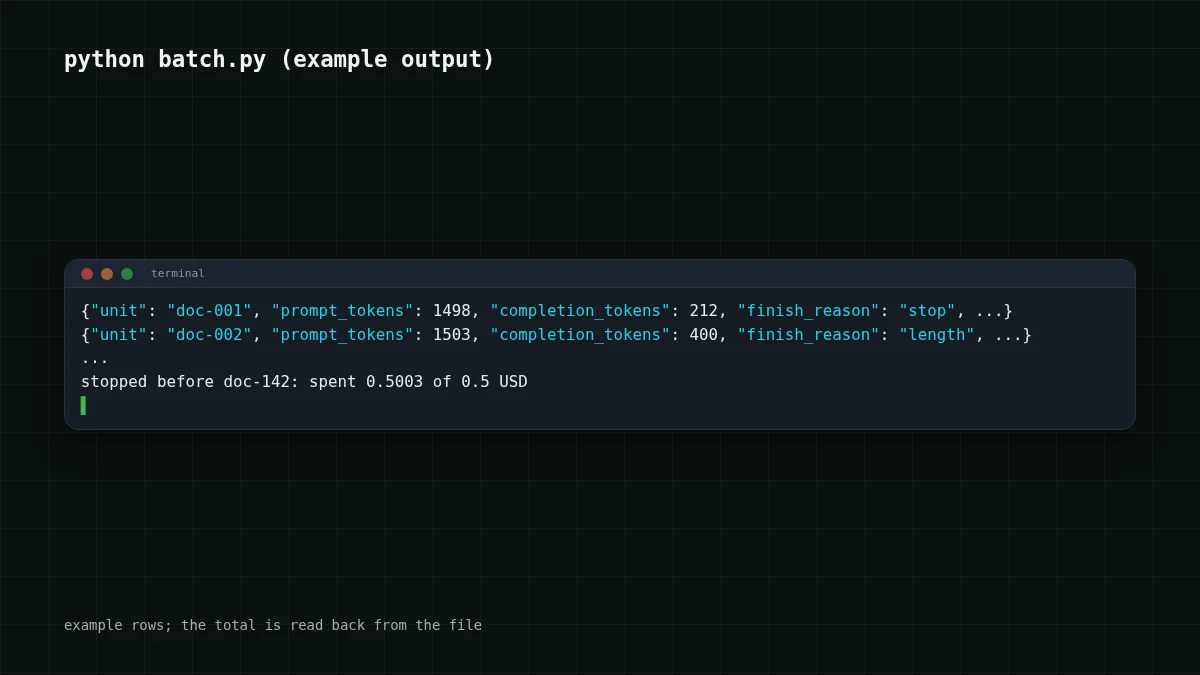
รัน กด Ctrl+C กลางทาง รันอีกครั้ง: unit ที่เสร็จแล้วจะถูกข้าม ดังนั้น ledger จึงทำหน้าที่เป็นไฟล์ความคืบหน้าของคุณด้วย ปล่อยให้งบประมาณหมดแล้วคุณจะได้หนึ่งบรรทัดแทนความประหลาดใจ ประมาณว่า stopped before doc-
สังเกตคำว่า ก่อน การตรวจเกิดขึ้นก่อนทุกการเรียก ดังนั้นการเรียกสุดท้ายอาจดันยอดรวมเกินงบประมาณเล็กน้อย เกินได้แค่ไหนมีขอบเขต: การเรียกหนึ่งครั้งมีค่าใช้จ่ายไม่เกินพรอมต์ที่ยาวที่สุดของคุณบวก max_tokens สำหรับพรอมต์ 1,500 โทเคนและ max_tokens=400 นั่นคืออย่างมาก $0.000063 นั่นคือเหตุผลที่ทุกการเรียกใน wrapper มี max_tokens: มันเปลี่ยนความเสี่ยงแบบเปิดกว้างให้เป็นตัวเลขที่คุณวางแผนได้
ประเมินบิลก่อนกดรัน#
ตอนนี้อีกครึ่ง: รู้ค่าใช้จ่ายก่อนเริ่ม รัน 5 พรอมต์แรกผ่าน ask() ด้วยงบประมาณเล็ก ๆ แล้วอ่าน ledger สมมติว่า 5 แถวเฉลี่ย 1,500 input tokens และ 400 output tokens นั่นคือตัวเลขของคุณสำหรับทั้งแบตช์
สำหรับ 200 พรอมต์ นั่นคือ 200 × 1,500 = 300,000 input tokens และ 200 × 400 = 80,000 output tokens นี่คือภาระงานนั้นบนราคาจริง:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 200 คำขอ | OpenRouter, 200 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
1,500 โทเค็นอินพุตและ 400 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ตารางมีคอลัมน์ OpenRouter ด้วย เมื่อนับ input และ output รวมกัน DeepSeek-V4-Flash ออกมา cheaper กว่า OpenRouter สำหรับภาระนี้ และผลรวมนั้นคือสิ่งที่แบตช์จ่ายจริง
พรอมต์มีความยาวต่างกัน ดังนั้นห้าตัวอย่างคือการเดา ไม่ใช่คำสัญญา ใช้ตัวที่ยาวที่สุดในห้าเมื่อคุณต้องการด้านบนที่ปลอดภัย แล้วให้เพดานงบประมาณจับส่วนที่เหลือ อยากเทียบสองโมเดลบน 200 พรอมต์เดียวกัน? ให้แต่ละโมเดลมีไฟล์ ledger ของตัวเอง เช่น Ledger(f'ledger- แล้วยอดรวมสองอันจะวางเทียบกันได้ภายหลัง
ลองแบตช์ของคุณเองที่นี่: ตั้งโทเคนต่อคำขอจากตัวอย่างของคุณและจำนวนคำขอที่คุณวางแผน
เครื่องคำนวณค่าใช้จ่าย
แบตช์ของคุณ: โทเคนจากตัวอย่าง 5 พรอมต์ของคุณ
โทเค็นอินพุตต่อคำขอ: 1,500 · โทเค็นเอาต์พุตต่อคำขอ: 400 · คำขอต่อวัน: 200
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
สำหรับข้อมูลเพิ่มเติมเกี่ยวกับการนับโทเคนก่อนส่ง ดู การนับโทเคนด้วย tiktoken
เมื่อบิลใหญ่กว่าที่คาด: อ่าน ledger#
สถานการณ์ผู้อ่านที่สามคืออันที่แย่ การรัน agent ผิดพลาดและวนลูป และแดชบอร์ดแสดงแค่ยอดรวม ledger แสดงว่ามันไปที่ไหน เรียงแถวตามค่าใช้จ่าย:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
สำหรับ agent ตั้งชื่อ unit ตามขั้นตอน (step-17) เพื่อให้เห็นรูปร่างของการรัน มีรูปแบบไม่กี่อย่างที่โผล่ซ้ำ ๆ จับคู่แต่ละอันกับสาเหตุปกติ:
จับคู่
จับคู่แต่ละรูปแบบ ledger กับสาเหตุปกติ
แตะรายการทางซ้าย แล้วแตะคู่ของมัน
- prompt_tokens โตขึ้นเล็กน้อยทุกแถวลูปส่งประวัติทั้งหมดซ้ำในทุกขั้นตอน
- completion_tokens เท่ากับ max_tokens และ finish_reason เป็น lengthคำตอบถูกตัดที่เพดานของคุณ และคุณจ่ายสำหรับข้อความที่ถูกตัด
- unit เดียวกันปรากฏหลายครั้งติดกันลูป retry หรือ agent ทำขั้นตอนหนึ่งซ้ำ
- แถวหนึ่งมีค่าใช้จ่ายมากกว่าแถวอื่นทั้งหมดมากอินพุตขนาดใหญ่เกินหนึ่งรายการ เช่นไฟล์ทั้งไฟล์ที่วางในพรอมต์
แต่ละรูปแบบมองเห็นได้ใน ledger นานก่อนใบแจ้งหนี้ อันแรกครอบคลุมใน ทำไม agent อ่านประวัติซ้ำ
ถ้าคุณต้องการค่าใช้จ่ายต่อโปรเจกต์และการแจ้งเตือนนอกสคริปต์ด้วย คู่มือการแจ้งเตือนงบประมาณต่อโปรเจกต์นี้ ครอบคลุมด้านนั้น ledger ที่นี่คือส่วนที่อยู่ในโค้ดของคุณและบอกหยุดได้
ก่อนเปิดตัว#
เช็กลิสต์
ก่อนการรันจริงครั้งแรก
ขนาด context และขีดจำกัดคำตอบของ DeepSeek-V4-Flash มีประโยชน์เมื่อคุณเลือก max_tokens อยู่บนหน้านั้น: DeepSeek-V4-Flash บน CheapTokens


