Python में LLM बैच की लागत पर कैप लगाएँ: एक लेजर और एक सख्त बजट
हर API कॉल के टोकन और लागत को JSONL फ़ाइल में लॉग करें, बजट पर बैच रोकें, और चलाने से पहले बिल का अनुमान लगाएँ। Python कोड शामिल है।
इस पृष्ठ पर
आपकी स्क्रिप्ट 200 प्रॉम्प्ट्स पर लूप करती है, आप लैपटॉप का ढक्कन बंद करते हैं, और सुबह पता चलता है कि रात में कितना खर्च हुआ। दो छोटी आदतें इसे ठीक कर देती हैं। हर API कॉल के बाद, टोकन और लागत के साथ एक लाइन एक लेजर फ़ाइल में जोड़ें। हर कॉल से पहले, चालू कुल की तुलना बजट से करें और अगर वह पहुँच गया हो तो रुक जाएँ। यह 50 लाइन से कम Python है, और 5-प्रॉम्प्ट का ट्रायल रन असली रन शुरू होने से पहले आपको बिल बता देता है।
Clocktower रन क्या करता है जिसे आप कॉपी कर सकते हैं#
Dwarkesh Podcast के होस्ट Dwarkesh Patel ने Blood on the Clocktower में 11 मॉडल्स को एक-दूसरे के खिलाफ चलाया, README के अनुसार 386 गेम, और कोड, लॉग और रेटिंग्स प्रकाशित कीं (github.com/dwarkeshsp/clocktower, 8 नवंबर 2026 को जाँचा गया)। रेपो से दो बातें चुराने लायक हैं। हर गेम डायरेक्टरी प्रति-कॉल लॉग रखती है जिसमें टोकन और लागत होती है, और खर्च games/ में जाता है। एक --budget फ़्लैग कुल खर्च पर सीमा लगाता है; डिफ़ॉल्ट $1,000 है। बेंचमार्क साइट एक तीसरा गार्ड जोड़ती है: हर मॉडल को प्रति टर्न समान 8,000-टोकन की सीमा मिलती है (clocktowerbench.com)।
तो: हर कॉल पर एक सीमा, हर कॉल का एक लॉग, कुल पर एक कैप। एक टूर्नामेंट को तीनों चाहिए, और आपके ओवरनाइट रन को भी, बस छोटे पैमाने पर।
लेजर को दुकान के कैश रजिस्टर में रसीद रोल की तरह सोचें। हर बिक्री एक लाइन प्रिंट करती है; मैनेजर किसी भी पल रोल जोड़ सकता है और जानता है कि दिन का फ़्लोट कब खत्म हुआ।
लेजर: एक फ़ाइल, प्रति कॉल एक लाइन#
यहाँ पूरी चीज़ है। यह openai पैकेज का उपयोग करती है जो CheapTokens की ओर इंगित है (https:/, key और model ids के लिए docs देखें)।
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
हर कॉल इन्हीं चार चरणों से गुज़रती है:
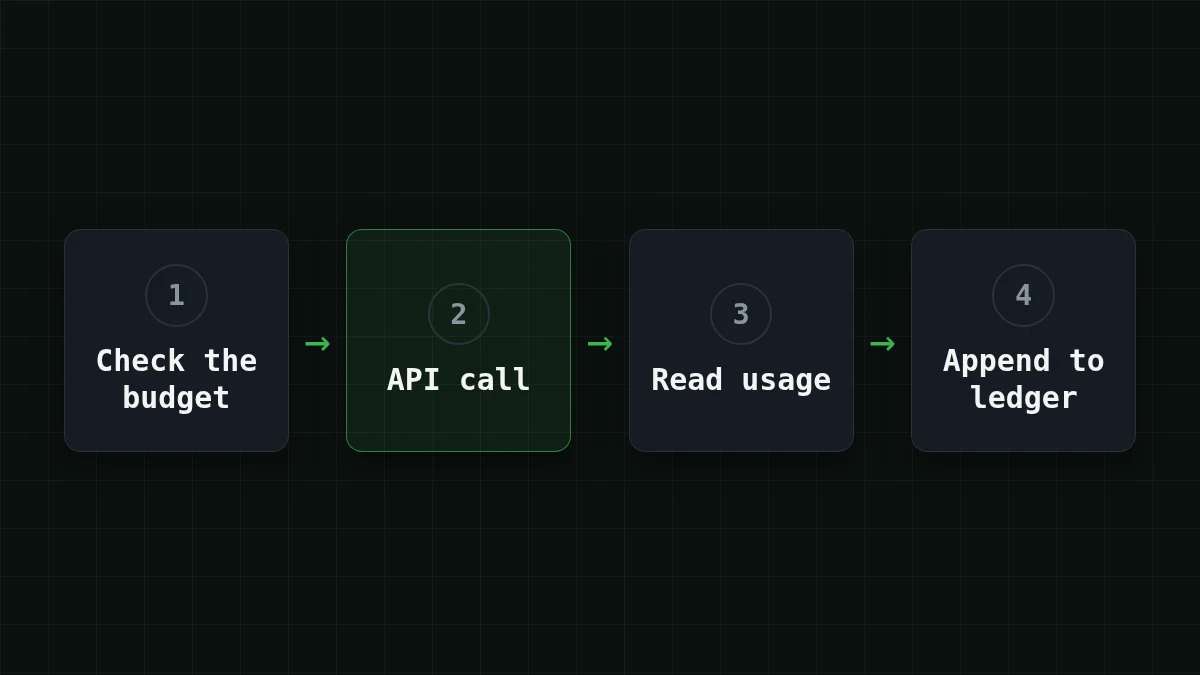
इसमें तीन चुनाव जानबूझकर किए गए हैं।
- प्रति लाइन एक JSON ऑब्जेक्ट (JSONL), append मोड में खोला गया। अगर स्क्रिप्ट कॉल 130 पर क्रैश हो जाए, तो कॉल 1 से 129 पहले से डिस्क पर हैं।
- कुल फ़ाइल से आता है, किसी वेरिएबल से नहीं। स्क्रिप्ट रीस्टार्ट करें और कैप अभी भी लागू रहता है, क्योंकि लेजर को याद है कि पिछले रन में कितना खर्च हुआ।
finish_reasonटोकन के बगल में लॉग होता है। एक पंक्ति जोlengthकहती है, मतलब जवाब आपकेmax_tokensपर पहुँचकर कट गया। आपको यह बाद में जानना होगा।
दो PRICE_ कॉन्स्टेंट्स प्लेसहोल्डर हैं। मौजूदा संख्याएँ pricing table से लें। जिस समय आप यह पढ़ रहे हैं उस समय DeepSeek-V4-Flash के लिए, यह $0.015 प्रति 1M input tokens और $0.10 प्रति 1M output tokens है। MODEL को zai- या MiniMaxAI/ में बदलें और दोनों कॉन्स्टेंट्स, और वही लेजर उनके लिए भी काम करता है।
बैच लूप: जो हो चुका उसे छोड़ें, कैप पर रुकें#
लूप छोटा है। मान लें आपके प्रॉम्प्ट्स एक dict में हैं जिसकी key एक unit id है, यानी काम के एक टुकड़े का नाम, जैसे doc-001:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
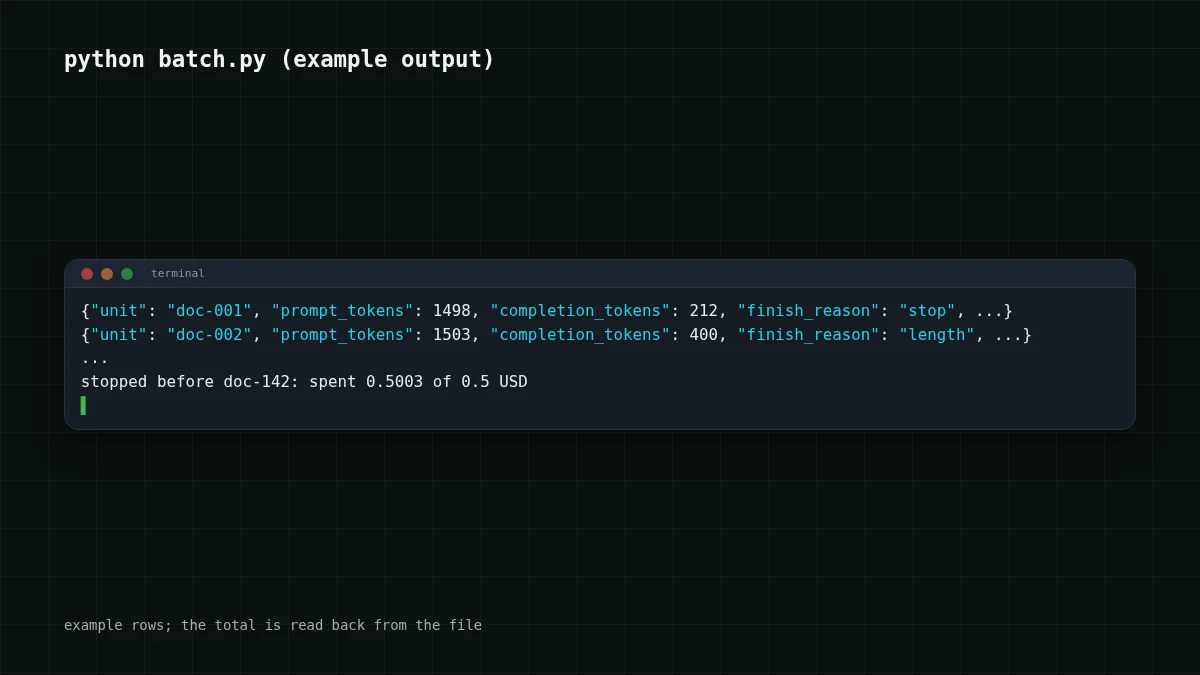
इसे चलाएँ, बीच में Ctrl+C दबाएँ, फिर से चलाएँ: पूरे हो चुके units छोड़ दिए जाते हैं, इसलिए लेजर आपकी प्रगति फ़ाइल का भी काम करता है। बजट खत्म होने दें और आपको आश्चर्य के बजाय एक लाइन मिलती है, कुछ ऐसी stopped before doc-।
पहले शब्द पर ध्यान दें। जाँच हर कॉल से पहले होती है, इसलिए अंतिम कॉल कुल को बजट से थोड़ा ऊपर धकेल सकती है। कितना ऊपर, यह सीमित है: एक कॉल आपके सबसे लंबे प्रॉम्प्ट प्लस max_tokens से ज़्यादा महँगी नहीं हो सकती। 1,500-टोकन प्रॉम्प्ट और max_tokens=400 के लिए यह अधिकतम $0.000063 है। इसीलिए wrapper में हर कॉल पर max_tokens है: यह एक खुली-अनंत जोखिम को ऐसी संख्या में बदल देता है जिसकी आप योजना बना सकें।
रन दबाने से पहले बिल का अनुमान लगाएँ#
अब दूसरा हिस्सा: लॉन्च से पहले लागत जानना। पहले पाँच प्रॉम्प्ट्स को छोटे बजट के साथ ask() से चलाएँ और लेजर पढ़ें। मान लें पाँच पंक्तियों का औसत 1,500 input tokens और 400 output tokens है। ये पूरे बैच के लिए आपकी संख्याएँ हैं।
200 प्रॉम्प्ट्स के लिए यह 200 × 1,500 = 300,000 input tokens और 200 × 400 = 80,000 output tokens है। यहाँ वह workload लाइव कीमतों पर है:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 200 अनुरोध | OpenRouter, 200 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
प्रति अनुरोध 1,500 इनपुट और 400 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
तालिका में एक OpenRouter कॉलम भी है। input और output को एक साथ गिनने पर, इस लोड के लिए DeepSeek-V4-Flash OpenRouter से सस्ता पड़ता है, और बैच वास्तव में यही योग चुकाता है।
प्रॉम्प्ट्स की लंबाई अलग-अलग होती है, इसलिए पाँच नमूने एक अनुमान हैं, वादा नहीं। जब आप सुरक्षित ऊपरी सीमा चाहते हैं तो पाँचों में से सबसे लंबा लें, फिर बाकी को बजट कैप पकड़ लेगा। एक ही 200 प्रॉम्प्ट्स पर दो मॉडल्स की तुलना करनी है? हर मॉडल को अपनी लेजर फ़ाइल दें, उदाहरण के लिए Ledger(f'ledger-, और बाद में दोनों कुल साथ-साथ रहते हैं।
अपना बैच यहाँ आज़माएँ: अपने नमूने से प्रति request टोकन और आप कितने requests की योजना बना रहे हैं, सेट करें।
लागत कैलकुलेटर
आपका बैच: आपके 5-प्रॉम्प्ट नमूने से टोकन
प्रति अनुरोध इनपुट टोकन: 1,500 · प्रति अनुरोध आउटपुट टोकन: 400 · प्रति दिन अनुरोध: 200
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
भेजने से पहले टोकन गिनने के बारे में अधिक जानकारी के लिए, counting tokens with tiktoken देखें।
जब बिल अपेक्षा से बड़ा हो: लेजर पढ़ें#
तीसरा पाठक परिदृश्य गंदा है। एक agent रन गलत हो जाता है और लूप करता है, और डैशबोर्ड सिर्फ एक कुल दिखाता है। लेजर दिखाता है कि कहाँ गया। पंक्तियों को लागत के अनुसार क्रमबद्ध करें:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
एक agent के लिए, unit का नाम चरण के अनुसार रखें (step-17) ताकि आप रन का आकार देख सकें। कुछ पैटर्न बार-बार दिखते हैं; हर एक को उसके सामान्य कारण से मिलाएँ:
जोड़े मिलाएँ
हर लेजर पैटर्न को उसके सामान्य कारण से मिलाएँ
बाईं ओर एक आइटम पर टैप करें, फिर उसका जोड़ा
- prompt_tokens हर पंक्ति पर थोड़ा बढ़ता हैलूप हर चरण पर पूरा इतिहास फिर से भेजता है
- completion_tokens, max_tokens के बराबर है और finish_reason length हैजवाब आपके कैप पर कट जाते हैं, और आप कटे टेक्स्ट के लिए भुगतान करते हैं
- वही unit कई बार लगातार दिखता हैएक retry लूप, या एक agent जो एक चरण दोहरा रहा है
- एक पंक्ति की लागत बाकी सभी से बहुत ज़्यादा हैएक अत्यधिक बड़ा input, जैसे पूरी फ़ाइल प्रॉम्प्ट में पेस्ट की गई
हर पैटर्न इनवॉइस से बहुत पहले लेजर में दिखता है। पहला पैटर्न why an agent re-reads its history में शामिल है।
अगर आप स्क्रिप्ट के बाहर प्रति प्रोजेक्ट खर्च और अलर्ट भी चाहते हैं, तो this guide to per-project budget alerts उस पक्ष को कवर करता है। यहाँ का लेजर वह हिस्सा है जो आपके कोड में रहता है और "रुको" कह सकता है।
लॉन्च से पहले#
चेकलिस्ट
पहले असली रन से पहले
DeepSeek-V4-Flash का context size और answer limit, जो max_tokens चुनते समय काम आते हैं, उसके पेज पर हैं: DeepSeek-V4-Flash on CheapTokens।


