コスト最適化ガイド
モデル大会のAPIコストを実行前に見積もる
席あたりのトークンを数え、ゲーム数と陣営の入れ替えを掛け、Pythonでハードキャップを設定する:6席・60ゲームのモデル大会の実例見積もり。
最初のリクエストの前に、モデル大会の請求額を知ることができます。1つの席がゲーム全体で送るトークンを数え、席数とゲーム数を掛け、コードにハードキャップを設定します。見落とされがちなのは履歴です。毎ターン、それまでに交わされたすべてを再送するため、入力はターン数よりもはるかに速く増えます。
$20,000という見出しが教えてくれること、教えてくれないこと#
2026年11月5日、ポッドキャスターのDwarkesh PatelはClocktower Benchを公開しました。これはモデル同士が社会推論ゲームBlood on the Clocktowerをプレイするベンチマークです。彼はハーネスの構築に約$20,000のAPIクレジットを使い、その多くは予定していたトークンよりも環境設計の反復に費やされたと述べています。
プロジェクトのREADME(2026年11月8日確認)にはセットアップが説明されています。11モデル、見出しランキング用に386ゲーム、1つのモデルがすべての善の席を、別のモデルがすべての悪の席を担当、10〜12プレイヤー、数時間続くゲーム。各ディールは陣営を入れ替えて再生されるため、どちらのモデルも簡単な役割を得ません。また、無料のドライラン(--model random)を同梱し、支出をgames/に書き込み、デフォルトで$1,000の--budgetキャップを持っています。
与えられていないのは、ゲームあたりのトークン数です。つまりコピーできるものは何もなく、推定値は自分で構築します。この記事の残りでは、自分の前提に差し替えられる明示的な仮定とともに、それを示します。
1つの席:入力が増え続ける理由#
より小さなゲームを実行するとします。6席、各席は独自の会話を持つモデル、1席あたり20ターン。2,000トークンのシステムプロンプト(ルールとその席の役割)、各ターンの前に届く600トークンの新しいテーブルトーク、300トークンの返信を仮定します。APIにはメモリがないため、各リクエストは会話全体を再び運びます(長いチャットがより高くつく理由)。
ターン1は2,000 + 600 = 2,600トークンを送ります。ターン20は2,000 + 600 × 20 + 300 × 19 = 19,700を送ります。最後の数字を自分で試してみてください:
数字を当てる
1つの席は20ターン目に何個の入力トークンを送るか?
あなたの予想
040,000
答えを表示
答え: 19,700
19,700:2,000トークンのシステムプロンプト、20 × 600の新しい会話、そしてそれぞれ300の19個の以前の返信。すべての古い返信とすべての古いメッセージが再び入ります。
1つの席の20ターンすべてを合計します:2,000 × 20 + 600 × 210 + 300 × 190 = 40,000 + 126,000 + 57,000 = 223,000入力トークン。出力はわずか20 × 300 = 6,000です。各メッセージを1回だけ数えると、2,000 + 20 × 600 = 14,000となり、16倍の誤差になります。
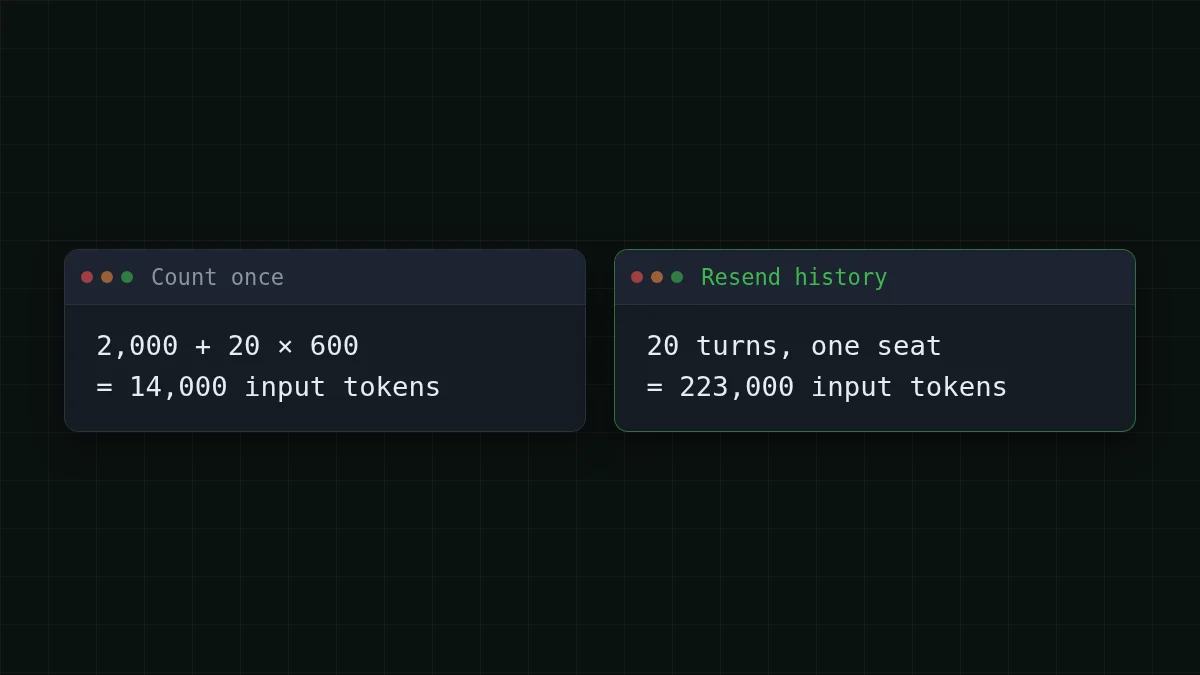
出力側はほとんど動きません。お金がかかるのは入力側であり、ゲームが長くなるほど悪化するのもその側です。
1つの席から大会全体へ#
次に3つの乗数でスケールします。
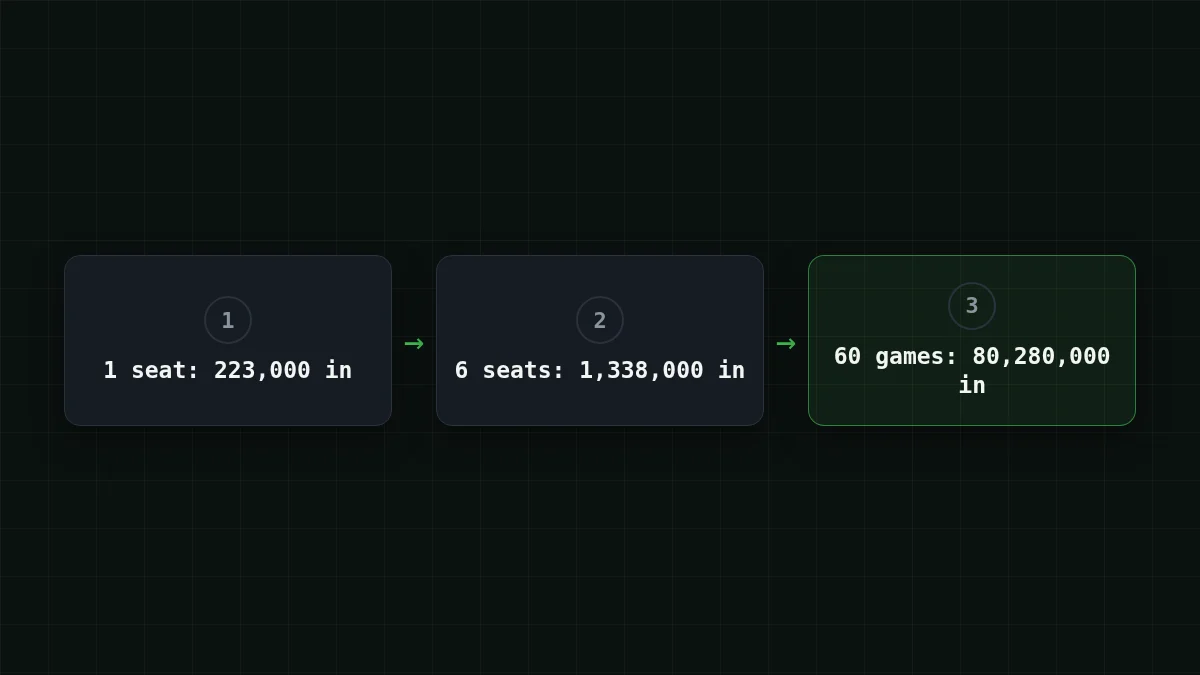
- 席。 6席 × 223,000 = 1,338,000入力トークン、6 × 6,000 = 36,000出力トークン(1ゲームあたり)。
- 陣営の入れ替え。 ラウンドロビンで3モデル:3組の対戦。各組で10ディールを、それぞれ陣営を入れ替えて2回プレイ:3 × 10 × 2 = 60ゲーム。
- ゲーム。 60 × 1,338,000 = 80,280,000入力、60 × 36,000 = 2,160,000出力トークン(大会全体)。
DeepSeek-V4-Flashでの1ゲームは$0.0237になります。下の表は、その1つのモデルがすべての席をプレイしたものとして60ゲームの大会全体を価格設定しているため、この種の長い会話の作業に対してCheapTokensが提供する3つのモデルを比較できます。合計で、入力と出力を合わせて数えると、いずれも最後の列のOpenRouterの参照価格より安くなります。
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 60 リクエスト | OpenRouter、60 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
リクエストあたり 1,338,000 入力トークンと 36,000 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
予算の面ではこれがすべてのコツです。3つのモデルのうちどれが交渉ゲームをより上手くプレイするかを知るために、$20,000の予算項目は必要ありません。必要なのは上記の推定値と、それを確認するための実際のパイロットです。
クイックチェック
6席のゲームが1席あたり20ターンから40ターンになるとします。入力の請求額はどうなるか?
答えを表示
答え: 約3.6倍になる
40ターンの場合、同じ式で2,000 × 40 + 600 × 820 + 300 × 780 = 806,000入力トークンとなり、20ターンの223,000と対比されます。履歴の項はターン数の2乗で増えます。
このような数値を信頼する前に2つの確認をしてください。第一に、最大のリクエストがモデルのウィンドウに収まる必要があります。20ターンでは最大リクエストは19,700トークンで問題ありません。1席あたり200ターンの数時間のゲームでは2,000 + 600 × 200 + 300 × 199 = 181,700、約182Kに達するので、ゲームを設計する前にモデルのページでコンテキストサイズを確認してください。DeepSeek-V4-Flashは380Kのウィンドウと最大32,768出力トークンを持ちます。モデルページを参照してください。第二に、モデルが長い推論を出力する場合、300出力トークンはもっと増えます(バルクジョブでの思考トークン)。
コードにハードキャップを設定する#
READMEの--budgetフラグは正しい考え方で、自分のハーネスにコピーするのに10行しかかかりません。以下のスクリプトは実行前に推定し、合計をキャップ超過させる可能性のあるリクエストの送信を拒否し、すべての呼び出しを台帳ファイルに記録します。中の価格は例です:価格表から現在のものに置き換えてください。
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20)は(1338000, 36000)を出力し、上記と同じゲームあたりの数値になるため、コードと計算が互いに検証し合います。usage.とusage.はレスポンスから得られ、請求対象となるものです。事前チェックは悲観的な文字数カウントを使用します。実際のカウントは呼び出し後にしか分からないためです。プロジェクトごとの台帳についてはPythonでのエージェントトークンコストの追跡に詳しくあります。
初回実行の安全な順序#
リポジトリ自身の順序は良いモデルです:まず無料、次に安価、最後に高価。これらのステップを順序付けしてください:
順番に並べる
安全な初回実行のステップを順序付けする
項目をドラッグするか矢印を使う
- ランダムプレイヤーでドライラン、API呼び出しなし
estimate()を実行し、キャップと比較する- 実際のゲームを1回プレイし、台帳を読む
- 実際のトークン数で仮定を修正する
- キャップを有効にして大会全体を開始する
READMEには、安価なモデルでのデモゲームは約$2〜5かかると書かれています。これは著者の発言であり、モデル名は明記されていないため、あなたのセットアップへの見積もりではなく、妥当性の範囲として扱ってください。自分のパイロットゲームが重要な数値を与えます:台帳が仮定した1,338,000ではなく1,500,000入力トークンを示したなら、ゲーム40回目ではなく数セントで何かを学んだことになります。
より長い実験では、通常のレバーはチャット履歴の削減にあります:各席が再読しなければならないものを削り、二次の項もそれに伴って縮みます。実行する準備ができたら、ドキュメントにエンドポイントとモデルIDがあります。


