はじめにガイド
requests を使った Python での CheapTokens への最初のリクエスト、SDK なし
requests だけを使った 20 行の Python スクリプト: 1 回のチャット補完、タイムアウト、HTTP エラー処理、そして回答、finish_reason、使用量を出力します。
OpenAI 互換 API と通信するのに openai パッケージは必要ありません。requests.post 呼び出し 1 回、Bearer キー、JSON ボディがあれば十分で、実際に何が送られるかを正確に確認できます。このガイドでは CheapTokens (https:/) 用にそのスクリプトを構築し、最後には回答、finish_reason、トークン使用量を出力します。
requests しかインストールされていないロックダウンされたマシンを使っている場合、小さな cron ジョブで SDK を引き込みたくない場合、あるいは SDK が何をしてくれているのか単純に理解したい場合に適しています。最初のリクエストガイド では SDK、curl、Node のルートを扱っていますが、これは素の Python のルートです。
スクリプト全体#
まずキーを環境変数に入れ(API キーを安全に保存する方法 を参照)、これを ask.py として保存します:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
python ask.py を実行します。モデル ID は完全なゲートウェイ ID、deepseek- です。何を入れるか不明な場合は、GET /v1/models でモデルを一覧表示 してください。別のモデルを試すには、zai- に差し替えるだけで他は何も変更しません。1 つの残高で全モデルをカバーします。
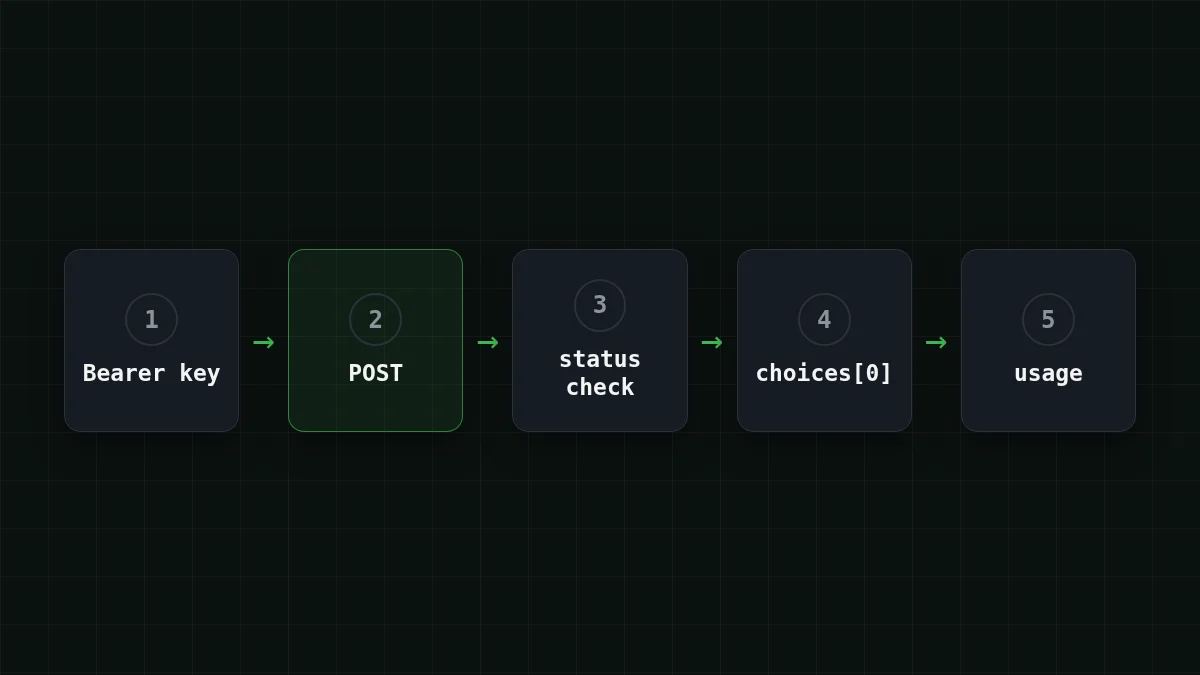
各行が何をしているか#
スクリプトが依存している 5 つの考え方を示します。requests クイックスタート(生きたドキュメント、2026 年 11 月 2 日確認)がそのほとんどを説明しており、OpenAI の Chat Completions リファレンスが返信内のフィールドを定義しています。
フラッシュカード
スクリプト内の 5 つのポイント
カードをタップしてめくる
3 番目のポイントが人々が飛ばしがちなものです。cron ジョブで永遠にハングするスクリプトは、30 秒後に大きな音を立てて失敗するスクリプトよりはるかに悪いです。
返信を読む#
成功したレスポンスは JSON です。Chat Completions リファレンスによると、気にする部分は次のとおりです:
choices[0].はテキストです。message. content nullになる可能性があるので、盲目的に文字列メソッドを呼ばないでください。choices[0].はモデルが停止した理由を示します:finish_ reason stop(完了)、length(max_tokens制限で打ち切られた)、tool_calls、content_filter。usage.、prompt_ tokens usage.、completion_ tokens usage.は課金対象です: 入力、出力、およびその合計。total_ tokens
返信はこの形をしています(数値はプレースホルダーです):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}自分で試す試してみましょう: max_tokens を 5 に設定してスクリプトを再実行します。finish_reason は何と言っていますか?答えを表示
length と表示されます: モデルは max_tokens 制限で停止したため、回答は文の途中で終わります。制限を上げると再び stop になります。詳細は AI の回答が途中で切れた? finish_reason "length" を修正 にあります。
うまくいかないとき#
スクリプトはほとんどの失敗を 1 行の出力に変換します。それぞれが通常何を意味するかは次のとおりです:
ペアを合わせる
各メッセージを通常の原因と照合する
左の項目をタップしてから、そのペアをタップ
- HTTP 401キーが欠落している、誤入力されている、または送信するつもりのキーではない
- HTTP 404URL パスまたはモデル ID が間違っている
- requests.exceptions.Timeoutタイムアウト内にバイトが到着しなかった
- KeyError: 'CHEAPTOKENS_API_KEY'このターミナルで環境変数が設定されていない
実際のエラーボディと、キー、ベース URL、モデル ID の段階的な確認については、API 401 または 404 エラー: 間違ったキー、ベース URL、モデル ID を参照してください。2 つの小さな落とし穴: KeyError: 'choices' が表示された場合、エラーボディを成功としてパースしており、raise_ がスキップされたことを意味します。また、マシンに ~/.netrc ファイルがある場合、requests は設定した Authorization ヘッダーの代わりにその認証情報を使用することがあります。
1 回の呼び出しのコスト#
上記の返信のプレースホルダー数値(入力約 18 トークン、出力 52 トークン)では、DeepSeek-V4-Flash への 1 回の呼び出しは $0.0000055 です。これは実感できない数値なので、スケールアップしてみましょう。スクリプトが 1 日 1,000 件のサポートチケットを要約し、各チケットが約 800 トークン入力、300 トークン出力だとします:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
リクエストあたり 800 入力トークンと 300 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
価格はモデルごとに固定で、ピーク時間はないため、同じスクリプトは午前 3 時でも正午でも同じコストです。現在のモデルごとの価格は価格ページにあり、ドキュメントにエンドポイントが記載されています。
ここから先へ#
これが動いたら、通常の次のステップは多数の入力に対するループ、429 でのリトライ(429 Too Many Requests: バックオフ付きリトライ を参照)、または同じ呼び出しのストリーミングです。HTTP を自分で管理したくない場合は、SDK ルートは base_url の変更 1 つで済みます。


