شروعاتگائیڈ
requests کے ساتھ پائتھون میں CheapTokens کو پہلی درخواست، بغیر SDK
صرف requests کے ساتھ 20 لائنوں کا پائتھون اسکرپٹ: ایک چیٹ کمپلیشن، ٹائم آؤٹ، HTTP ایرر ہینڈلنگ، اور جواب، finish_reason اور usage پرنٹ۔
اس صفحہ پر
آپ کو OpenAI-مطابق API سے بات کرنے کے لیے openai پیکیج کی ضرورت نہیں ہے۔ ایک requests.post کال، ایک Bearer کلید اور ایک JSON باڈی کافی ہے، اور آپ کو بالکل نظر آتا ہے کہ کیا کچھ وائر پر جاتا ہے۔ یہ گائیڈ CheapTokens (https:/) کے لیے وہ اسکرپٹ بناتی ہے اور اس کے آخر میں یہ جواب، finish_reason اور ٹوکن استعمال پرنٹ کرتا ہے۔
یہ اس وقت موزوں ہے جب آپ کسی لاک ڈاؤن مشین پر ہوں جہاں صرف requests انسٹال ہے، جب کوئی چھوٹا کرون جاب SDK نہیں لانا چاہیے، یا جب آپ صرف یہ سمجھنا چاہیں کہ SDK آپ کے لیے کیا کرتا ہے۔ پہلی درخواست گائیڈ SDK، curl اور Node کے راستے بتاتی ہے؛ یہ سادہ پائتھون والا ہے۔
پورا اسکرپٹ#
پہلے اپنی کلید ایک ماحول متغیر میں رکھیں (دیکھیں API کلید محفوظ طریقے سے کیسے اسٹور کریں)، پھر اسے ask.py کے طور پر محفوظ کریں:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
python ask.py چلائیں۔ ماڈل آئی ڈی مکمل گیٹ وے آئی ڈی ہے، deepseek-؛ اگر آپ کو یقین نہیں کہ وہاں کیا رکھنا ہے، تو GET /v1/models کے ساتھ ماڈلز کی فہرست بنائیں۔ کوئی اور ماڈل آزمانے کے لیے، zai- رکھیں اور کچھ اور نہ بدلیں: ایک بیلنس تمام ماڈلز کے لیے کافی ہے۔
ہر لائن کیا کر رہی ہے#
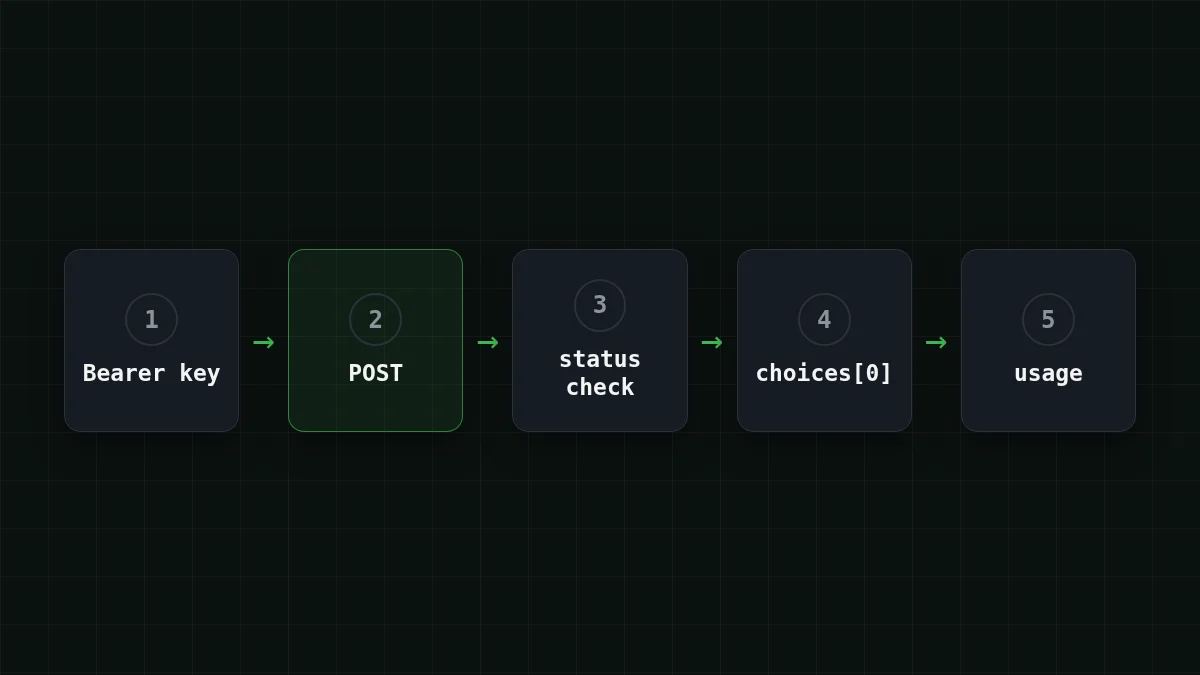
یہاں پانچ تصورات ہیں جن پر اسکرپٹ ٹیک لگاتا ہے۔ requests کوئیک اسٹارٹ (زندہ دستاویزات، 2 نومبر 2026 کو چیک کیا گیا) ان میں سے زیادہ تر کی وضاحت کرتا ہے، اور OpenAI کا Chat Completions حوالہ جواب میں موجود فیلڈز کی تعریف کرتا ہے۔
فلیش کارڈز
اسکرپٹ میں پانچ چیزیں
پلٹنے کے لیے کارڈ پر ٹیپ کریں
تیسری شق وہ ہے جسے لوگ چھوڑ دیتے ہیں۔ کرون جاب میں ہمیشہ کے لیے لٹکا ہوا اسکرپٹ 30 سیکنڈ کے بعد بلند آواز میں ناکام ہونے والے سے کہیں زیادہ خراب ہے۔
جواب پڑھیں#
کامیاب جواب JSON ہے۔ آپ کو جن حصوں کی پرواہ ہے، Chat Completions حوالے کے مطابق:
choices[0].متن ہے۔ یہmessage. content nullہو سکتا ہے، لہٰذا اس پر آنکھ بند کر کے سٹرنگ میتھڈز نہ کالیں۔choices[0].بتاتا ہے کہ ماڈل کیوں رکا:finish_ reason stop(یہ مکمل ہوا)،length(max_tokensحد نے اسے کاٹ دیا)،tool_calls،content_filter۔usage.،prompt_ tokens usage.اورcompletion_ tokens usage.وہ ہیں جن کی آپ کو بلنگ ہوتی ہے: ان پٹ، آؤٹ پٹ، اور ان کا مجموعہ۔total_ tokens
جواب کی یہ شکل ہے (اعداد پلیس ہولڈر ہیں):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}
خود آزمائیںآزمائیں: max_tokens کو 5 پر سیٹ کریں اور اسکرپٹ دوبارہ چلائیں۔ finish_reason کیا کہتا ہے؟جواب دکھائیں
یہ length کہتا ہے: ماڈل آپ کی max_tokens حد کی وجہ سے رکا، لہٰذا جواب درمیان جملے میں ختم ہوتا ہے۔ حد بڑھائیں اور آپ کو دوبارہ stop ملے گا۔ پوری کہانی AI جواب کٹ گیا؟ finish_reason "length" ٹھیک کریں میں ہے۔
جب یہ کام نہ کرے#
اسکرپٹ زیادہ تر ناکامیوں کو آؤٹ پٹ کی ایک لائن میں بدل دیتا ہے۔ یہاں ہر ایک کا عام مطلب ہے:
جوڑے ملائیں
ہر پیغام کو اس کی عام وجہ سے ملائیں
بائیں طرف کسی آئٹم پر ٹیپ کریں، پھر اس کا جوڑا
- HTTP 401کلید غائب ہے، غلط ٹائپ ہے یا وہ نہیں جو آپ بھیجنا چاہتے تھے
- HTTP 404URL پاتھ یا ماڈل آئی ڈی غلط ہے
- requests.exceptions.Timeoutٹائم آؤٹ کے اندر کوئی بائٹ نہیں آیا
- KeyError: 'CHEAPTOKENS_API_KEY'ماحول متغیر اس ٹرمینل میں سیٹ نہیں ہے
اصل ایرر باڈیز اور کلید، بیس URL اور ماڈل آئی ڈی کی مرحلہ وار جانچ کے لیے، API 401 یا 404 ایرر: غلط کلید، بیس URL یا ماڈل آئی ڈی استعمال کریں۔ دو چھوٹی پکڑیں: اگر آپ KeyError: 'choices' دیکھیں، تو آپ نے ایرر باڈی کو کامیابی کے طور پر پارس کیا، جس کا مطلب ہے کہ raise_ چھوڑ دیا گیا۔ اور اگر آپ کی مشین میں ~/.netrc فائل ہے، تو requests آپ کے سیٹ کردہ Authorization ہیڈر کے بجائے اس کی اسناد استعمال کر سکتا ہے۔
ایک کال کی لاگت#
اوپر جواب کے پلیس ہولڈر اعداد کے ساتھ (تقریباً 18 ٹوکن ان، 52 آؤٹ)، DeepSeek-V4-Flash کو ایک کال $0.0000055 کی لاگت آتی ہے۔ یہ ایسا عدد ہے جسے آپ محسوس نہیں کر سکتے، تو اسے بڑھا دیں۔ فرض کریں آپ کا اسکرپٹ روزانہ 1,000 سپورٹ ٹکٹس کا خلاصہ کرتا ہے، ہر ایک میں تقریباً 800 ٹوکن ان اور 300 آؤٹ:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 1,000 درخواستیں | OpenRouter، 1,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
فی درخواست 800 ان پٹ اور 300 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
قیمتیں فی ماڈل مقرر ہیں، کوئی پیک آورز نہیں، لہٰذا وہی اسکرپٹ رات 3 بجے اور دوپہر میں یکساں لاگت کا ہوتا ہے۔ موجودہ فی ماڈل قیمتیں قیمتوں کے صفحے پر ہیں، اور دستاویزات اینڈ پوائنٹس کی فہرست دیتی ہیں۔
یہاں سے کہاں جائیں#
ایک بار یہ کام کر جائے، تو عام اگلے قدم بہت سے ان پٹس پر لوپ، 429 پر دوبارہ کوشش (دیکھیں 429 Too Many Requests: بیک آف کے ساتھ دوبارہ کوششیں)، یا اسٹریمنگ کے ساتھ وہی کال ہے۔ اگر آپ خود HTTP کا انتظام نہیں کرنا چاہتے، تو SDK کا راستہ ایک base_url تبدیلی کی دوری پر ہے۔


