快速开始指南
用 requests 在 Python 中向 CheapTokens 发送首次请求,无需 SDK
一个仅使用 requests 的 20 行 Python 脚本:一次聊天补全、超时、HTTP 错误处理,并打印答案、finish_reason 和用量。
你不需要 openai 包就能与 OpenAI 兼容的 API 对话。一次 requests.post 调用、一个 Bearer 密钥和一个 JSON 请求体就足够了,而且你能确切看到线上传输的内容。本指南为 CheapTokens(https:/)构建该脚本,最终它会打印出答案、finish_reason 和 token 用量。
如果你在只有 requests 的受限机器上,或者一个小型 cron 任务不应引入 SDK,又或者你只是想了解 SDK 为你做了什么,这都很合适。首次请求指南 涵盖了 SDK、curl 和 Node 路线;本文是纯 Python 路线。
完整脚本#
先把密钥放入环境变量(参见如何安全存储 API 密钥),然后将其保存为 ask.py:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
运行 python ask.py。模型 id 是完整的网关 id,即 deepseek-;如果不确定该填什么,用 GET /v1/models 列出模型。要尝试其他模型,换成 zai- 即可,其他什么都不用改:一个余额覆盖所有模型。
每一行在做什么#
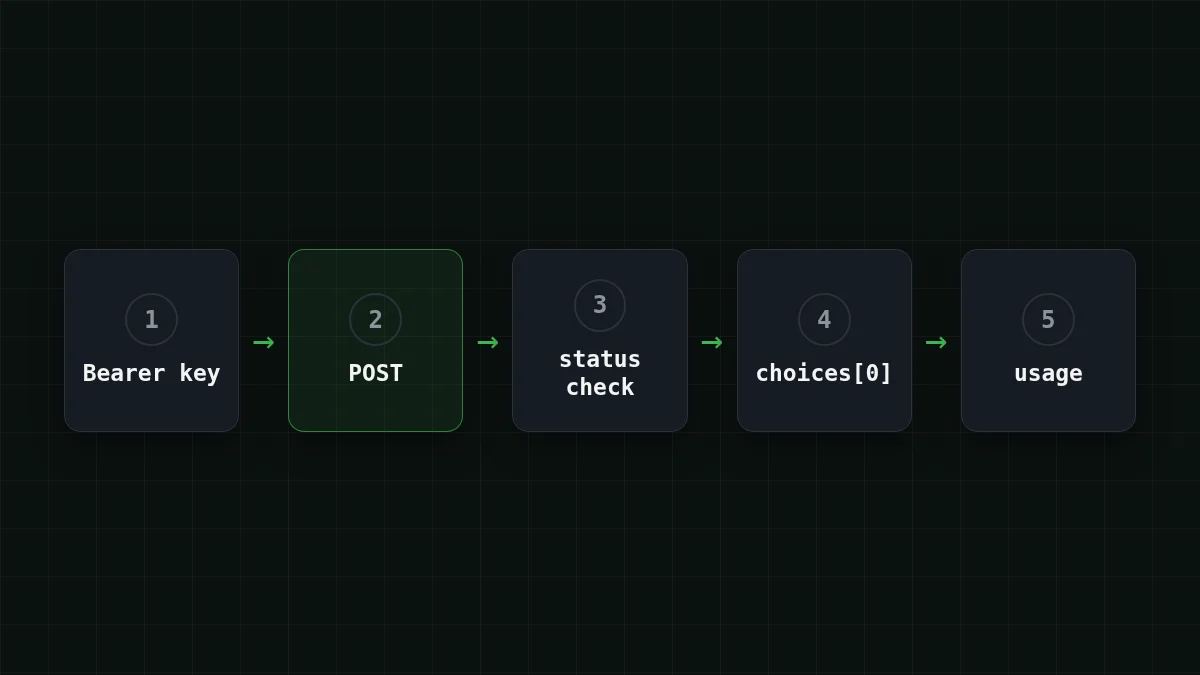
以下是脚本依赖的五个要点。requests 快速入门(动态文档,2026 年 11 月 2 日检查)解释了其中大部分内容,OpenAI 的 Chat Completions 参考定义了回复中的字段。
闪卡
脚本中的五件事
点击卡片翻转
第三个要点是人们常忽略的。在 cron 任务中永远挂起的脚本,比在 30 秒后大声失败的脚本要糟糕得多。
读取回复#
成功的响应是 JSON。根据 Chat Completions 参考,你关心的部分如下:
choices[0].是文本。它可能是message. content null,所以不要盲目对其调用字符串方法。choices[0].说明模型为何停止:finish_ reason stop(已完成)、length(被max_tokens限制截断)、tool_calls、content_filter。usage.、prompt_ tokens usage.和completion_ tokens usage.是你计费的部分:输入、输出及其总和。total_ tokens
回复具有以下结构(数字为占位符):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}自己试试试一试:将 max_tokens 设为 5 并再次运行脚本。finish_reason 会说什么?显示答案
它会说 length:模型被你的 max_tokens 限制停止,因此答案在句子中间结束。提高限制后,你会再次得到 stop。完整故事见 AI 答案被截断?修复 finish_reason "length"。
当它不工作时#
脚本将大多数失败转换为一行输出。以下是每种情况通常的含义:
配对
将每条消息与其常见原因匹配
点击左侧项目,然后点击其配对项
- HTTP 401密钥缺失、拼写错误或不是你打算发送的那个
- HTTP 404URL 路径或模型 id 错误
- requests.exceptions.Timeout在超时时间内没有收到任何字节
- KeyError: 'CHEAPTOKENS_API_KEY'此终端中未设置环境变量
有关实际的错误响应体以及密钥、基础 URL 和模型 id 的分步检查,请使用 API 401 或 404 错误:错误的密钥、基础 URL 或模型 id。两个较小的陷阱:如果你看到 KeyError: 'choices',说明你将错误响应体解析为成功,这意味着 raise_ 被跳过了。如果你的机器上有 ~/.netrc 文件,requests 可能会使用其凭据而不是你设置的 Authorization 头。
一次调用的成本#
使用上面回复中的占位数字(约 18 个输入 token,52 个输出 token),一次对 DeepSeek-V4-Flash 的调用花费 $0.0000055。这是一个你感觉不到的数字,所以放大来看。假设你的脚本每天总结 1,000 个支持工单,每个大约 800 个输入 token 和 300 个输出 token:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
每次请求 800 个输入 token 和 300 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
价格按模型固定,没有高峰时段,因此同一脚本在凌晨 3 点和中午的成本相同。当前各模型价格见定价页面,文档列出了端点。
从这里去哪里#
一旦这能工作,通常的下一步是循环处理多个输入、在 429 时重试(参见429 Too Many Requests:带退避的重试),或者使用流式进行相同的调用。如果你不想自己管理 HTTP,SDK 路线只需更改一个 base_url。


