MemulaiPanduan
Permintaan pertama ke CheapTokens di Python dengan requests, tanpa SDK
Skrip Python 20 baris hanya dengan requests: satu chat completion, timeout, penanganan error HTTP, dan jawaban, finish_reason serta usage yang dicetak.
Di halaman ini
Anda tidak perlu paket openai untuk berbicara dengan API yang kompatibel dengan OpenAI. Satu panggilan requests.post, kunci Bearer, dan body JSON sudah cukup, dan Anda bisa melihat persis apa yang dikirim melalui jaringan. Panduan ini membangun skrip tersebut untuk CheapTokens (https:/) dan diakhiri dengan mencetak jawaban, finish_reason, dan penggunaan token.
Ini cocok jika Anda berada di mesin yang terkunci di mana hanya requests yang terpasang, jika cron job kecil tidak boleh menarik SDK, atau jika Anda hanya ingin memahami apa yang dilakukan SDK untuk Anda. Panduan permintaan pertama mencakup SDK, curl, dan Node; ini adalah versi Python murni.
Seluruh skrip#
Simpan kunci Anda di variabel lingkungan terlebih dahulu (lihat cara menyimpan kunci API dengan aman), lalu simpan ini sebagai ask.py:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
Jalankan python ask.py. Id model adalah id gateway lengkap, deepseek-; jika Anda tidak yakin apa yang harus diisi, daftar model dengan GET /v1/models. Untuk mencoba model lain, ganti dengan zai- dan jangan ubah apa pun: satu saldo mencakup semua model.
Apa yang dilakukan setiap baris#
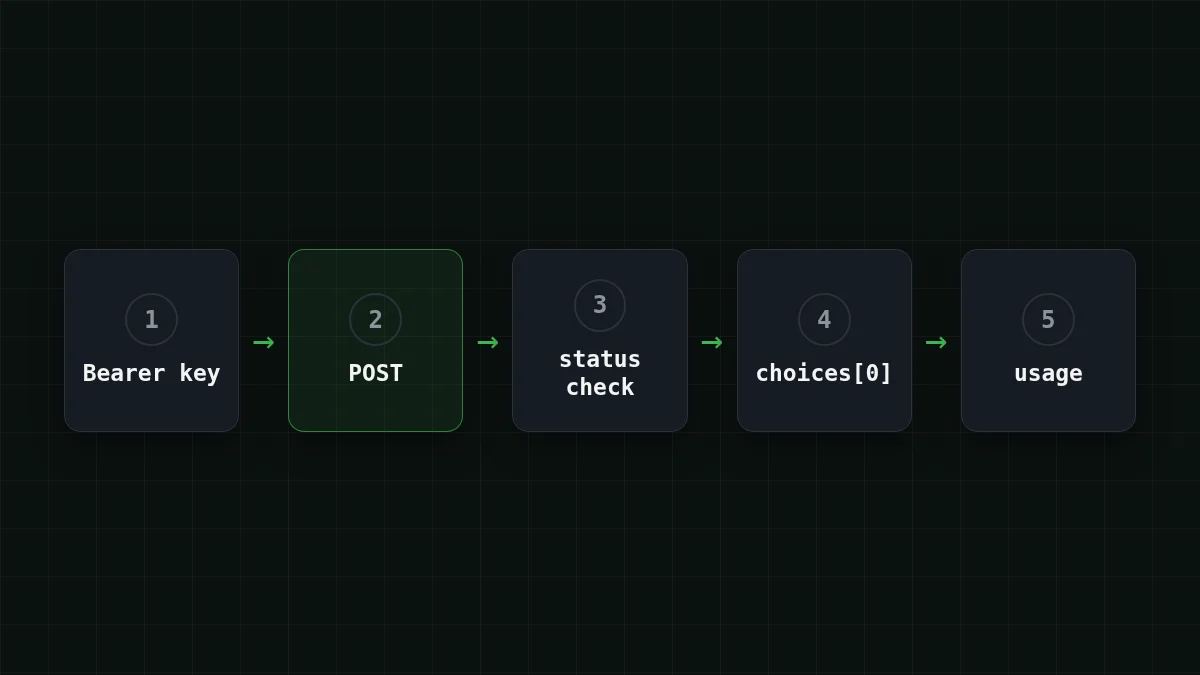
Berikut lima ide yang menjadi dasar skrip. Quickstart requests (dokumen hidup, diperiksa 2 November 2026) menjelaskan sebagian besarnya, dan referensi Chat Completions dari OpenAI mendefinisikan field dalam balasan.
Kartu kilat
Lima hal dalam skrip
Ketuk kartu untuk membaliknya
Poin ketiga adalah yang sering dilewatkan orang. Skrip yang menggantung selamanya di cron job jauh lebih buruk daripada skrip yang gagal dengan jelas setelah 30 detik.
Membaca balasan#
Respons yang berhasil adalah JSON. Bagian yang Anda pedulikan, menurut referensi Chat Completions:
choices[0].adalah teksnya. Nilainya bisamessage. content null, jadi jangan memanggil metode string padanya secara sembarangan.choices[0].menyatakan mengapa model berhenti:finish_ reason stop(selesai),length(dipotong oleh batasmax_tokens),tool_calls,content_filter.usage.,prompt_ tokens usage.dancompletion_ tokens usage.adalah yang Anda bayar: input, output, dan jumlahnya.total_ tokens
Balasan memiliki bentuk ini (angkanya adalah placeholder):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}
Coba sendiriCoba: setel max_tokens ke 5 dan jalankan skrip lagi. Apa yang dikatakan finish_reason?Tampilkan jawaban
Nilainya length: model dihentikan oleh batas max_tokens Anda, sehingga jawaban berakhir di tengah kalimat. Naikkan batasnya dan Anda mendapatkan stop lagi. Cerita lengkapnya ada di Jawaban AI terpotong? Perbaiki finish_reason "length".
Saat tidak berhasil#
Skrip mengubah sebagian besar kegagalan menjadi satu baris output. Berikut arti umum masing-masing:
Cocokkan pasangan
Cocokkan setiap pesan dengan penyebab biasanya
Ketuk item di kiri, lalu pasangannya
- HTTP 401Kunci hilang, salah ketik, atau bukan kunci yang ingin Anda kirim
- HTTP 404Path URL atau id model salah
- requests.exceptions.TimeoutTidak ada byte yang tiba dalam batas waktu
- KeyError: 'CHEAPTOKENS_API_KEY'Variabel lingkungan tidak disetel di terminal ini
Untuk body error yang sebenarnya dan pemeriksaan langkah demi langkah kunci, base URL, dan id model, gunakan Error API 401 atau 404: kunci, base URL, atau id model salah. Dua jebakan kecil: jika Anda melihat KeyError: 'choices', Anda mem-parse body error sebagai keberhasilan, yang berarti raise_ dilewati. Dan jika mesin Anda memiliki file ~/.netrc, requests dapat menggunakan kredensialnya alih-alih header Authorization yang Anda setel.
Berapa biaya satu panggilan#
Dengan angka placeholder dari balasan di atas (sekitar 18 token masuk, 52 keluar), satu panggilan ke DeepSeek-V4-Flash berbiaya $0.0000055. Itu angka yang tidak bisa Anda rasakan, jadi skalakan. Katakanlah skrip Anda merangkum 1.000 tiket dukungan per hari, kira-kira 800 token masuk dan 300 keluar masing-masing:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 token input dan 300 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Harga tetap per model, tanpa jam sibuk, jadi skrip yang sama berbiaya sama pada pukul 3 pagi dan siang. Harga per model saat ini ada di halaman harga, dan dokumen mencantumkan endpoint-nya.
Langkah selanjutnya#
Setelah ini berhasil, langkah berikutnya yang biasa adalah loop atas banyak input, retry pada 429 (lihat 429 Too Many Requests: retry dengan backoff), atau panggilan yang sama dengan streaming. Jika Anda lebih suka tidak mengelola HTTP sendiri, jalur SDK hanya berjarak satu perubahan base_url.


