Premiers pasGuide
Première requête vers CheapTokens en Python avec requests, sans SDK
Un script Python de 20 lignes avec seulement requests : un chat completion, un timeout, la gestion des erreurs HTTP, et l'affichage de la réponse, de finish_reason et de l'usage.
Sur cette page
Vous n'avez pas besoin du paquet openai pour dialoguer avec une API compatible OpenAI. Un seul appel requests.post, une clé Bearer et un corps JSON suffisent, et vous voyez exactement ce qui passe sur le réseau. Ce guide construit ce script pour CheapTokens (https:/) et se termine par l'affichage de la réponse, de finish_reason et de l'usage des tokens.
C'est un bon choix si vous êtes sur une machine verrouillée où seul requests est installé, si une petite tâche cron ne doit pas embarquer un SDK, ou si vous voulez simplement comprendre ce que le SDK fait pour vous. Le guide de la première requête couvre le SDK, curl et Node ; ici, c'est la version Python pur.
Le script complet#
Placez d'abord votre clé dans une variable d'environnement (voir comment stocker une clé API en sécurité), puis enregistrez ceci sous ask.py :
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
Lancez python ask.py. L'identifiant du modèle est l'identifiant complet de la passerelle, deepseek- ; si vous ne savez pas quoi mettre, listez les modèles avec GET /v1/models. Pour essayer un autre modèle, remplacez par zai- et ne changez rien d'autre : un seul solde couvre tous les modèles.
Ce que fait chaque ligne#
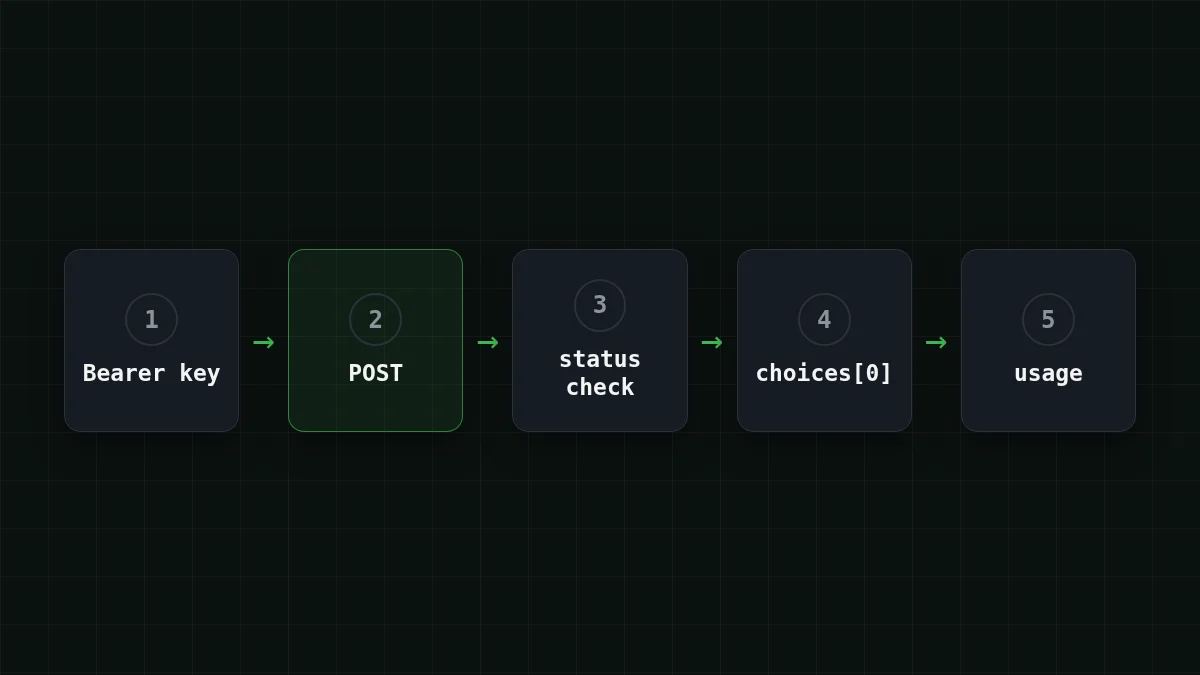
Voici les cinq idées sur lesquelles repose le script. Le Quickstart requests (docs vivantes, vérifiées le 2 novembre 2026) en explique la plupart, et la référence Chat Completions d'OpenAI définit les champs de la réponse.
Cartes mémo
Cinq choses dans le script
Touchez une carte pour la retourner
C'est la troisième puce que les gens oublient. Un script qui se bloque indéfiniment dans une tâche cron est bien pire qu'un script qui échoue bruyamment au bout de 30 secondes.
Lire la réponse#
Une réponse réussie est du JSON. Les parties qui vous intéressent, selon la référence Chat Completions :
choices[0].est le texte. Il peut valoirmessage. content null, donc n'appelez pas de méthodes de chaîne dessus à l'aveugle.choices[0].indique pourquoi le modèle s'est arrêté :finish_ reason stop(il a terminé),length(la limitemax_tokensl'a coupé),tool_calls,content_filter.usage.,prompt_ tokens usage.etcompletion_ tokens usage.sont ce qui vous est facturé : entrée, sortie et leur somme.total_ tokens
La réponse a cette forme (les nombres sont des exemples) :
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}
Essayez vous-mêmeEssayez : mettez max_tokens à 5 et relancez le script. Que dit finish_reason ?Afficher la réponse
Il dit length : le modèle a été arrêté par votre limite max_tokens, donc la réponse s'arrête en milieu de phrase. Augmentez la limite et vous obtenez de nouveau stop. Toute l'histoire est dans Réponse IA coupée ? Corriger finish_reason "length".
Quand ça ne marche pas#
Le script transforme la plupart des échecs en une ligne de sortie. Voici ce que chacun signifie généralement :
Associer les paires
Associez chaque message à sa cause habituelle
Touchez un élément à gauche, puis sa paire
- HTTP 401La clé est absente, mal saisie ou n'est pas celle que vous vouliez envoyer
- HTTP 404Le chemin de l'URL ou l'identifiant du modèle est faux
- requests.exceptions.TimeoutAucun octet reçu dans le délai imparti
- KeyError: 'CHEAPTOKENS_API_KEY'La variable d'environnement n'est pas définie dans ce terminal
Pour les corps d'erreur réels et une vérification pas à pas de la clé, de l'URL de base et de l'identifiant du modèle, consultez Erreur API 401 ou 404 : mauvaise clé, URL de base ou identifiant de modèle. Deux pièges plus discrets : si vous voyez KeyError: 'choices', vous avez analysé un corps d'erreur comme un succès, ce qui signifie que raise_ a été ignoré. Et si votre machine a un fichier ~/.netrc, requests peut utiliser ses identifiants au lieu de l'en-tête Authorization que vous avez défini.
Combien coûte un appel#
Avec les nombres d'exemple de la réponse ci-dessus (environ 18 tokens en entrée, 52 en sortie), un appel à DeepSeek-V4-Flash coûte $0.0000055. C'est un montant imperceptible, alors changez d'échelle. Disons que votre script résume 1 000 tickets de support par jour, environ 800 tokens en entrée et 300 en sortie chacun :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 tokens d'entrée et 300 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Les prix sont fixes par modèle, sans heures de pointe, donc le même script coûte la même chose à 3 h du matin et à midi. Les prix actuels par modèle sont sur la page de tarifs, et la doc liste les endpoints.
Et ensuite#
Une fois que ça marche, les étapes suivantes habituelles sont une boucle sur de nombreuses entrées, une nouvelle tentative sur 429 (voir 429 Too Many Requests : réessais avec backoff), ou le même appel en streaming. Si vous préférez ne pas gérer HTTP vous-même, la voie du SDK n'est qu'à un changement de base_url.


