Primeiros passosGuia
Primeira requisição ao CheapTokens em Python com requests, sem SDK
Um script Python de 20 linhas só com requests: um chat completion, um timeout, tratamento de erros HTTP, e a resposta, finish_reason e usage impressos.
Nesta página
Você não precisa do pacote openai para conversar com uma API compatível com OpenAI. Uma chamada requests.post, uma chave Bearer e um corpo JSON bastam, e você vê exatamente o que trafega pela rede. Este guia constrói esse script para o CheapTokens (https:/) e termina com ele imprimindo a resposta, finish_reason e o uso de tokens.
É uma boa opção se você está em uma máquina restrita onde só o requests está instalado, se um pequeno cron job não deveria puxar um SDK, ou se você simplesmente quer entender o que o SDK faz por você. O guia da primeira requisição cobre o SDK, curl e Node; este é o da Python pura.
O script inteiro#
Coloque sua chave em uma variável de ambiente primeiro (veja como armazenar uma chave de API com segurança), depois salve isto como ask.py:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
Execute python ask.py. O id do modelo é o id completo do gateway, deepseek-; se você não tem certeza do que colocar ali, liste os modelos com GET /v1/models. Para testar outro modelo, troque por zai- e não mude mais nada: um saldo cobre todos os modelos.
O que cada linha está fazendo#
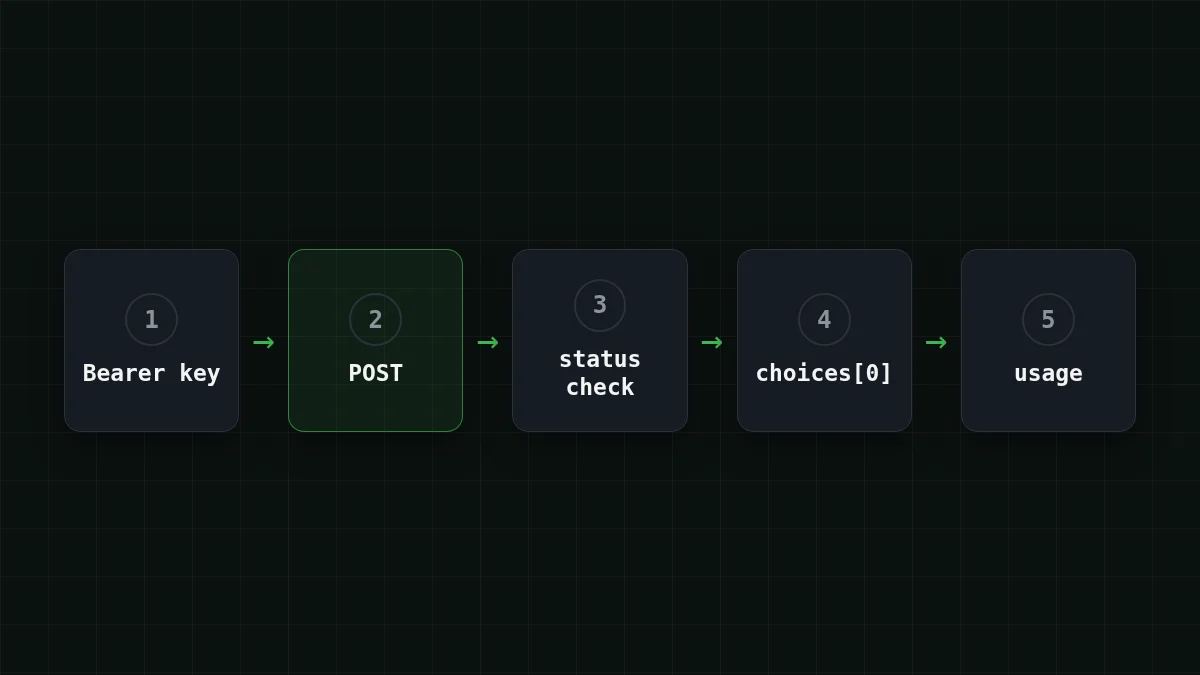
Aqui estão as cinco ideias nas quais o script se apoia. O Quickstart do requests (documentação viva, verificada em 2 de novembro de 2026) explica a maioria delas, e a referência de Chat Completions da OpenAI define os campos da resposta.
Flashcards
Cinco coisas no script
Toque num cartão para virar
O terceiro item é o que as pessoas pulam. Um script que trava para sempre em um cron job é muito pior do que um que falha ruidosamente após 30 segundos.
Leia a resposta#
Uma resposta bem-sucedida é JSON. As partes que importam, segundo a referência de Chat Completions:
choices[0].é o texto. Pode sermessage. content null, então não chame métodos de string nele às cegas.choices[0].diz por que o modelo parou:finish_ reason stop(terminou),length(o limite demax_tokenso cortou),tool_calls,content_filter.usage.,prompt_ tokens usage.ecompletion_ tokens usage.são o que você paga: entrada, saída e a soma delas.total_ tokens
A resposta tem este formato (os números são placeholders):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}
Experimente você mesmoExperimente: defina max_tokens como 5 e execute o script de novo. O que finish_reason diz?Mostrar resposta
Ele diz length: o modelo foi interrompido pelo seu limite de max_tokens, então a resposta termina no meio da frase. Aumente o limite e você recebe stop de novo. A história completa está em Resposta de IA cortada? Corrija finish_reason "length".
Quando não funciona#
O script transforma a maioria das falhas em uma linha de saída. Aqui está o que cada uma costuma significar:
Emparelhar os pares
Relacione cada mensagem à sua causa habitual
Toque num item à esquerda, depois no seu par
- HTTP 401A chave está ausente, digitada errado ou não é a que você pretendia enviar
- HTTP 404O caminho da URL ou o id do modelo está errado
- requests.exceptions.TimeoutNenhum byte chegou dentro do timeout
- KeyError: 'CHEAPTOKENS_API_KEY'A variável de ambiente não está definida neste terminal
Para os corpos de erro reais e uma verificação passo a passo de chave, URL base e id do modelo, use Erro 401 ou 404 da API: chave, URL base ou id do modelo errado. Duas pegadinhas menores: se você vir KeyError: 'choices', você analisou um corpo de erro como sucesso, o que significa que raise_ foi pulado. E se sua máquina tiver um arquivo ~/.netrc, o requests pode usar as credenciais dele em vez do header Authorization que você definiu.
Quanto custa uma chamada#
Com os números placeholder da resposta acima (cerca de 18 tokens de entrada, 52 de saída), uma chamada ao DeepSeek-V4-Flash custa $0.0000055. É um número que você não sente, então amplie. Digamos que seu script resuma 1.000 tickets de suporte por dia, aproximadamente 800 tokens de entrada e 300 de saída cada:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 tokens de entrada e 300 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Os preços são fixos por modelo, sem horários de pico, então o mesmo script custa o mesmo às 3 da manhã e ao meio-dia. Os preços atuais por modelo estão na página de preços, e a documentação lista os endpoints.
Para onde ir daqui#
Depois que isso funcionar, os próximos passos habituais são um loop sobre muitas entradas, uma nova tentativa em 429 (veja 429 Too Many Requests: retries com backoff), ou a mesma chamada com streaming. Se você prefere não gerenciar HTTP por conta própria, a rota do SDK está a uma mudança de base_url de distância.


