API e SDKGuia
Gere uma ferramenta HTML a partir de um prompt com uma API (Python)
Um script Python que transforma um prompt em um tool.html funcional, detecta uma resposta cortada via finish_reason e imprime tokens e custo.
Nesta página
Você consegue obter uma ferramenta funcional de arquivo único a partir de uma única chamada de API: envie um prompt bem estruturado, garanta que max_tokens seja grande o suficiente para uma página inteira, verifique se finish_reason é stop e salve a resposta como tool.html. Abaixo está o script que faz exatamente isso, e um template de prompt que você pode remodelar para a sua própria ferramenta.
A ideia é simples, e a DeepSeek acabou de mostrar isso. Ela publicou uma coleção de sete prompts de demonstração para o Creator Mode no DeepSeek Harness (a página, verificada em 3 de novembro de 2026): uma galeria de marcos 3D, uma bancada de pôsteres, uma bancada de edição de vídeo, um leitor de artigos, um painel de estatísticas de conversa e mais alguns. O Creator Mode fica dentro do app Harness. Se você quer o mesmo fluxo de "prompt entra, ferramenta sai" no seu próprio script e com a sua própria chave, uma chat completion comum basta para o caso de arquivo único. Se você usar o Harness em si, conectá-lo ao CheapTokens é um guia curto à parte.
O que um prompt de "construa uma ferramenta para mim" precisa#
Leia alguns desses prompts de demonstração e um padrão aparece. Cada um diz o que é a ferramenta, o que está na tela, o que os controles fazem, qual é o estado inicial e o que ela não deve fazer. Pule um desses e o modelo preenche a lacuna com o próprio palpite, que geralmente não é o seu.
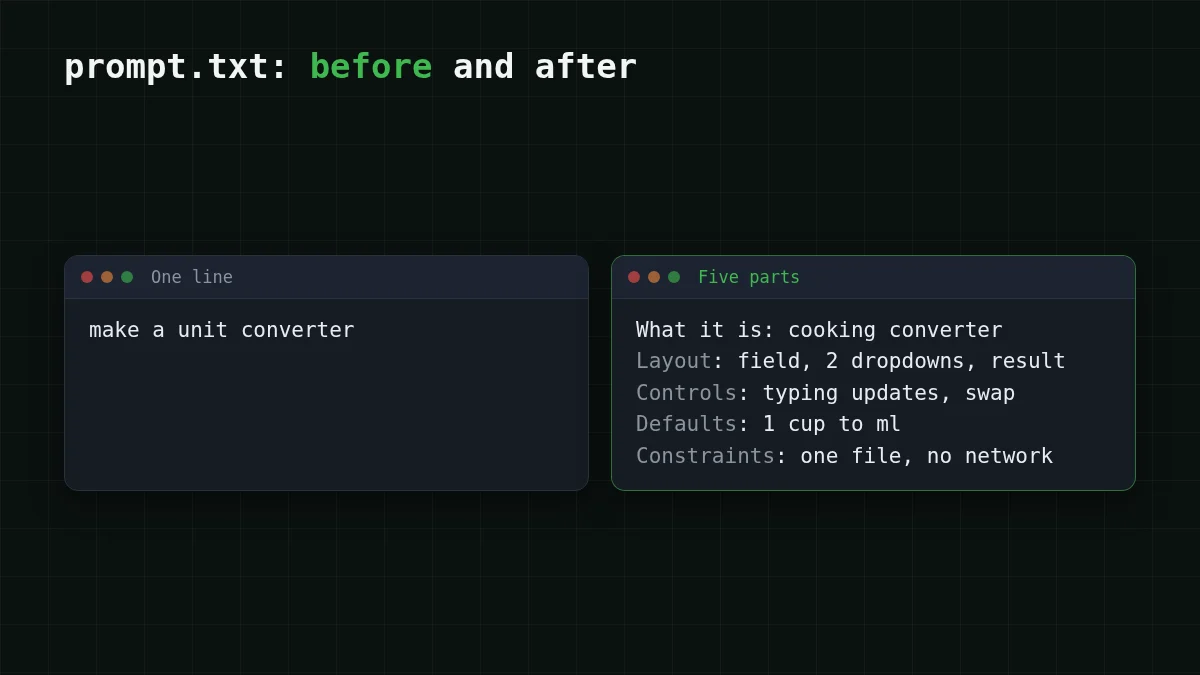
Aqui está o template, em cinco partes:
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
E uma versão preenchida. Digamos que você vive convertendo medidas de cozinha e está cansado de procurar um conversor:
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.
Salve isso como prompt.txt ao lado do script. A linha "Constraints" carrega a maior parte do peso: sem "no external requests" o modelo gosta de puxar uma biblioteca de CDN, e a página então quebra offline.
O script: requisitar, verificar, salvar#
A API do CheapTokens é compatível com OpenAI Chat Completions em https:/, então o pacote openai funciona com duas mudanças: a base URL e a chave. Para uma página inteira usamos deepseek-: ele permite até 32.768 tokens de saída por resposta e tem uma janela de contexto de 380K. Os detalhes completos da API estão na documentação do CheapTokens.
Instale o pacote, coloque sua chave em uma variável de ambiente e defina os dois preços da tabela de preços (o script os usa para imprimir o custo):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"
Depois make_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
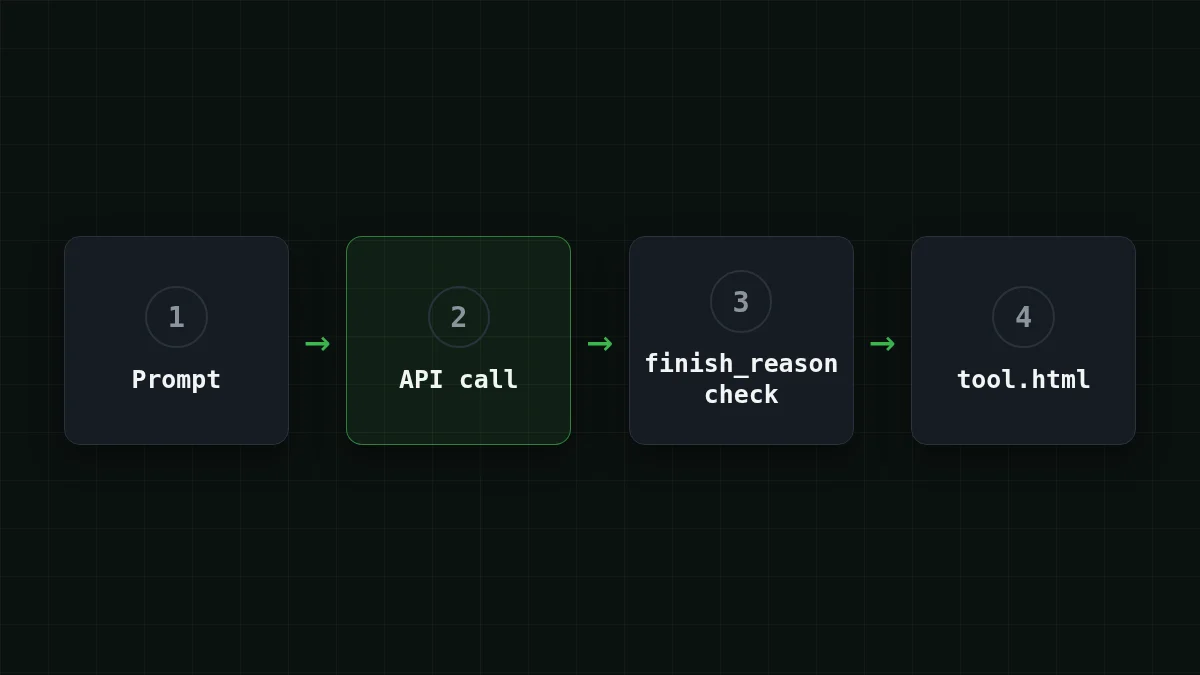
A ordem das etapas importa, e é fácil errar:
Colocar em ordem
Coloque as etapas do script na ordem em que ele as executa
Arraste os itens ou use as setas
- Envie o prompt com um max_tokens generoso
- Verifique finish_reason antes de tocar no texto
- Extraia o HTML do bloco de código, se houver
- Confirme que o </html> de fechamento está lá
- Salve tool.html e imprima o uso
Por que max_tokens decide se a página funciona#
Uma página interativa completa é uma resposta longa. HTML, CSS e JavaScript somam rápido, e o modelo os escreve nessa ordem: se a resposta for cortada, você perde o final do script primeiro, que é exatamente a parte que faz os botões funcionarem. O navegador pode até abrir a página. Ela simplesmente não faz nada.
É por isso que o script verifica finish_reason antes de olhar o texto. stop significa que o modelo terminou por conta própria. length significa que ele atingiu o teto de max_tokens no meio do arquivo. A versão geral desse problema está coberta em Resposta da IA cortada? Corrija finish_reason length; aqui a regra é curta: nunca salve uma página cujo finish_reason seja length.
Se você vir isso:
- aumente
max_tokens(o DeepSeek-V4-Flash permite até 32.768 por resposta); - ou peça menos: menos controles, uma tela, sem animações;
- no GLM-5.3-Flash (
zai-) o teto é de 8.192 tokens de saída, então esse modelo serve para ferramentas pequenas, como o conversor acima.org/ GLM- 5. 3- Flash
A segunda verificação, </html> no texto, pega a falha mais silenciosa em que um modelo encerra a resposta educadamente sem terminar o arquivo. Definir max_tokens também não faz o modelo escrever mais: é apenas um teto, e você paga pelos tokens realmente produzidos (mais sobre isso em Cortar tokens de saída).
Verificação rápida
O script imprimiu finish_reason = length. O que você faz?
Mostrar resposta
Resposta: Não salvar; aumentar max_tokens ou reduzir o pedido
length significa que a resposta foi cortada no teto, então o final do script está faltando. Um teto menor faz o corte chegar mais cedo.
Abra e olhe a página#
Abra tool.html com um duplo clique, ou pelo terminal: open tool.html no macOS, xdg- no Linux, start tool.html no Windows.
Este é um código que um modelo escreveu para você, então gaste um minuto antes de confiar nele. Abra as ferramentas de desenvolvedor do navegador (F12), olhe a aba Network e recarregue: com a restrição "no external requests" ela deve ficar vazia. Depois clique uma vez em cada controle da parte "Controls" do seu prompt.
Se algo estiver errado, não regenere do zero. Adicione uma frase ao prompt sobre a coisa específica ("o botão de troca também deve trocar os dois valores") e rode de novo. A própria página da DeepSeek observa que algumas de suas demos foram refinadas ao longo de várias rodadas de conversa, então uma segunda passada é normal.
Experimente você mesmoExperimente: o que você espera ver na aba Network para o conversor?Mostrar resposta
Nada: a página é um arquivo único com CSS e JavaScript inline, então após o primeiro carregamento não há mais requisições. Se você vir uma requisição para um CDN, o modelo ignorou a restrição; adicione-a ao prompt em maiúsculas e rode de novo.
Quanto custa uma geração#
Digamos que o prompt tenha cerca de 600 tokens de entrada e a página final tenha em torno de 6.000 tokens de saída (uma suposição para uma ferramenta de porte médio; a sua própria linha usage mostrará os números reais). Uma execução no DeepSeek-V4-Flash é $0.00061, e no GLM-5.3-Flash $0.00025. Ambos são números ao vivo da lista de preços atual, e no total, com entrada e saída contadas juntas, ambos são mais baratos que o OpenRouter.
| Modelo | Entrada $/1M | Saída $/1M | Custo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
600 tokens de entrada e 6.000 tokens de saída no total. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Na prática você não vai acertar a ferramenta na primeira tentativa, então pense em iterações: dez ajustes no prompt são dez vezes essa linha, ainda uma soma pequena para uma ferramenta que você escreveria à mão de outra forma. Quase tudo é o lado da saída, a própria página, e é por isso que reduzir o pedido (menos controles) encurta a resposta e a conta.
Se não funcionar#
Role a tabela para a direita →
| O que você vê | Causa provável | O que fazer |
|---|---|---|
401 ou 404 da API |
chave, base URL ou id de modelo errados | verifique os três, veja Erro 401 ou 404 da API |
Cut off at max_ |
página maior que o teto | aumente max_tokens ou peça menos |
The reply has no closing </ |
o modelo parou cedo ou adicionou texto | rode de novo; adicione "end with </html>" ao prompt |
| A página abre mas os botões não fazem nada | erro de JavaScript | abra o console (F12), cole o erro em vermelho em um prompt de acompanhamento |
Se você quer a resposta do modelo interpretada como dados em vez de uma página, o truque de extração é o mesmo de json.JSONDecodeError em uma resposta de LLM. Novo na API? Comece com sua primeira requisição à API.


