API & SDKHướng dẫn
Tạo một công cụ HTML từ một prompt bằng API (Python)
Một script Python biến một prompt thành tool.html hoạt động được, bắt câu trả lời bị cắt qua finish_reason, và in số token cùng chi phí.
Trên trang này
Bạn có thể nhận được một công cụ một tệp hoạt động chỉ từ một lệnh gọi API: gửi một prompt có cấu trúc tốt, đảm bảo max_tokens đủ lớn cho cả một trang, kiểm tra rằng finish_reason là stop, và lưu phản hồi thành tool.html. Dưới đây là script làm đúng việc đó, cùng một mẫu prompt bạn có thể chỉnh lại cho công cụ của riêng mình.
Ý tưởng rất đơn giản, và DeepSeek vừa chứng minh điều đó. Họ đã công bố một bộ bảy prompt demo cho Creator Mode trong DeepSeek Harness (trang này, kiểm tra ngày 3 tháng 11 năm 2026): một thư viện địa danh 3D, một bàn làm việc poster, một bàn làm việc chỉnh sửa video, một trình đọc bài báo, một bảng thống kê hội thoại và vài thứ khác. Creator Mode nằm trong ứng dụng Harness. Nếu bạn muốn có cùng luồng "đưa prompt vào, nhận công cụ ra" trong script của riêng mình và với key của riêng mình, một chat completion thông thường là đủ cho trường hợp một tệp. Nếu bạn dùng chính Harness, kết nối nó với CheapTokens là một hướng dẫn ngắn riêng.
Một prompt "tạo cho tôi một công cụ" cần gì#
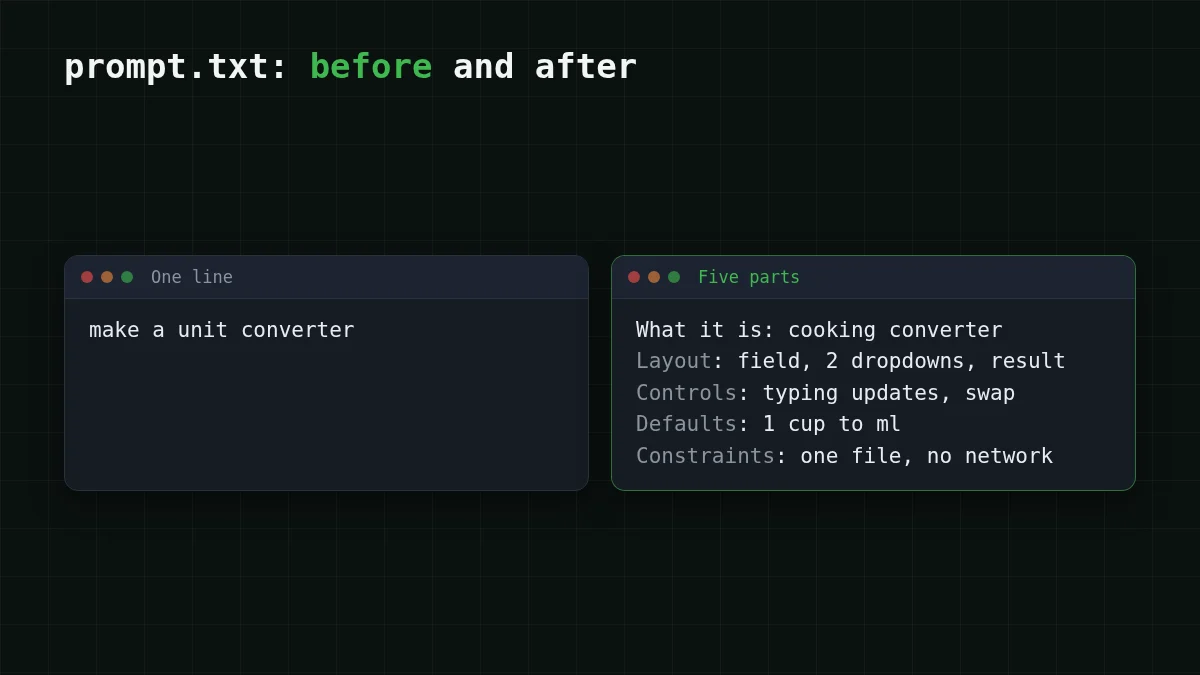
Đọc vài prompt demo đó và một khuôn mẫu hiện ra. Mỗi prompt nói rõ công cụ là gì, trên màn hình có gì, các điều khiển làm gì, trạng thái khởi đầu là gì, và nó không được làm gì. Bỏ qua một trong những phần đó và model sẽ tự đoán lấp vào chỗ trống, mà thường không giống ý bạn.
Đây là mẫu, gồm năm phần:
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
Và một phiên bản đã điền đầy đủ. Giả sử bạn hay phải đổi đơn vị đo nấu ăn và mệt vì phải tìm công cụ chuyển đổi:
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.
Lưu nó thành prompt.txt cạnh script. Dòng "Constraints" gánh phần lớn trọng lượng: nếu không có "no external requests" thì model thường kéo một thư viện từ CDN, và trang sau đó sẽ hỏng khi offline.
Script: gửi yêu cầu, kiểm tra, lưu#
API CheapTokens tương thích với OpenAI Chat Completions tại https:/, nên gói openai hoạt động với hai thay đổi: base URL và key. Với cả một trang, chúng ta dùng deepseek-: nó cho phép tối đa 32.768 token đầu ra mỗi câu trả lời và có cửa sổ ngữ cảnh 380K. Chi tiết đầy đủ về API có trong tài liệu CheapTokens.
Cài gói, đặt key vào một biến môi trường, và đặt hai mức giá từ bảng giá (script dùng chúng để in chi phí):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"
Sau đó make_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
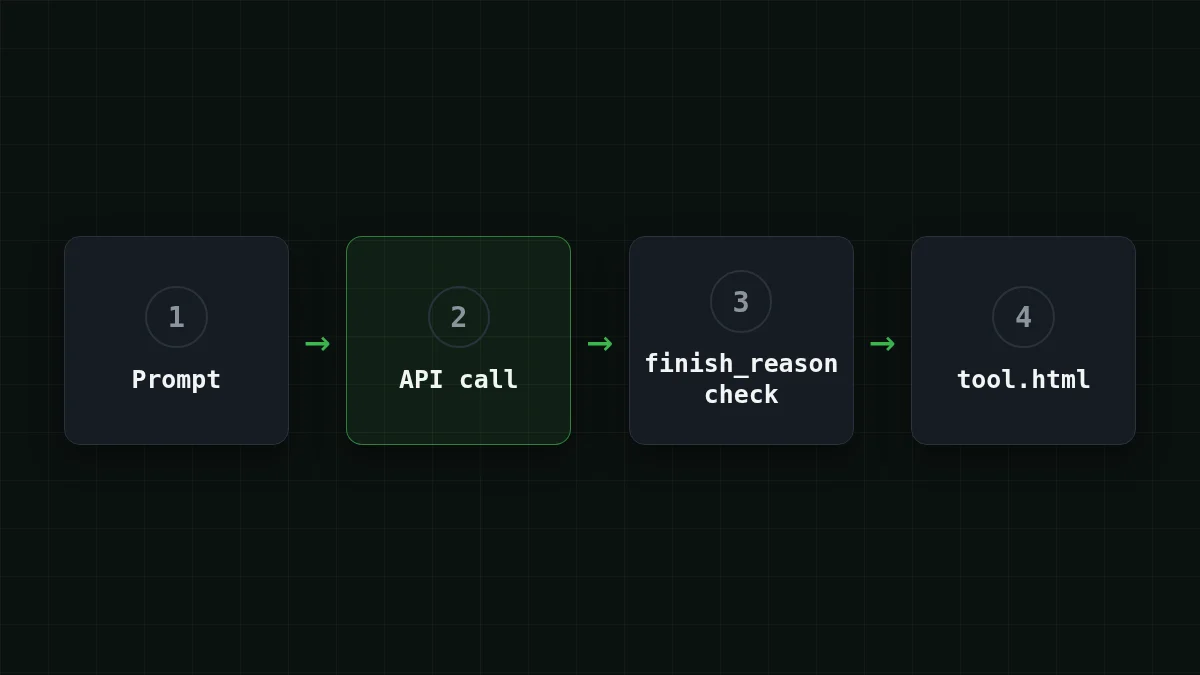
Thứ tự các bước rất quan trọng, và rất dễ làm sai:
Sắp xếp thứ tự
Sắp xếp các bước của script theo đúng thứ tự nó chạy
Kéo các mục hoặc dùng mũi tên
- Gửi prompt với max_tokens rộng rãi
- Kiểm tra finish_reason trước khi chạm vào văn bản
- Lấy HTML ra khỏi code fence, nếu có
- Xác nhận có thẻ đóng </html>
- Lưu tool.html và in thông tin sử dụng
Vì sao max_tokens quyết định trang có hoạt động hay không#
Một trang tương tác đầy đủ là một câu trả lời dài. HTML, CSS và JavaScript cộng lại rất nhanh, và model viết chúng theo đúng thứ tự đó: nếu câu trả lời bị cắt, bạn mất phần cuối của script trước tiên, mà đó chính là phần làm cho các nút hoạt động. Trình duyệt vẫn có thể mở trang. Nó chỉ không làm gì cả.
Đó là lý do script kiểm tra finish_reason trước khi xem văn bản. stop nghĩa là model đã tự kết thúc. length nghĩa là nó đã chạm trần max_tokens giữa chừng tệp. Phiên bản tổng quát của vấn đề này được đề cập trong Câu trả lời AI bị cắt? Sửa finish_reason length; ở đây quy tắc rất ngắn: không bao giờ lưu một trang có finish_reason là length.
Nếu bạn gặp trường hợp đó:
- tăng
max_tokens(DeepSeek-V4-Flash cho phép tối đa 32.768 mỗi câu trả lời); - hoặc yêu cầu ít hơn: ít điều khiển hơn, một màn hình, không animation;
- trên GLM-5.3-Flash (
zai-) trần là 8.192 token đầu ra, nên model đó phù hợp với các công cụ nhỏ, như công cụ chuyển đổi ở trên.org/ GLM- 5. 3- Flash
Bước kiểm tra thứ hai, </html> trong văn bản, bắt được lỗi âm thầm hơn khi model kết thúc phản hồi một cách lịch sự mà không hoàn thành tệp. Đặt max_tokens cũng không khiến model viết nhiều hơn: nó chỉ là một trần, và bạn trả tiền cho số token thực sự được tạo ra (xem thêm trong Cắt token đầu ra).
Kiểm tra nhanh
Script in ra finish_reason = length. Bạn làm gì?
Hiện đáp án
Trả lời: Không lưu; tăng max_tokens hoặc thu nhỏ yêu cầu
length nghĩa là câu trả lời bị cắt tại trần, nên phần cuối của script bị thiếu. Trần thấp hơn làm chỗ cắt đến sớm hơn.
Mở và xem trang#
Mở tool.html bằng cách nhấp đúp, hoặc từ terminal: open tool.html trên macOS, xdg- trên Linux, start tool.html trên Windows.
Đây là mã do model viết cho bạn, nên hãy dành một phút trước khi tin nó. Mở công cụ dành cho nhà phát triển của trình duyệt (F12), xem tab Network và tải lại: với ràng buộc "no external requests" nó phải trống. Sau đó nhấp thử từng điều khiển trong phần "Controls" của prompt một lần.
Nếu có gì đó chưa ổn, đừng tạo lại từ đầu. Thêm một câu vào prompt về đúng thứ cụ thể đó ("nút swap cũng phải hoán đổi hai giá trị") và chạy lại. Trang của chính DeepSeek ghi chú rằng một số demo của họ được tinh chỉnh qua nhiều vòng hội thoại, nên làm thêm một lượt là bình thường.
Tự mình thử xemThử xem: bạn mong đợi thấy gì trong tab Network với công cụ chuyển đổi?Hiện đáp án
Không có gì: trang là một tệp duy nhất với CSS và JavaScript nội tuyến, nên sau lần tải đầu tiên không có thêm yêu cầu nào. Nếu bạn thấy một yêu cầu đến CDN, model đã bỏ qua ràng buộc; hãy thêm nó vào prompt bằng chữ in hoa và chạy lại.
Một lần tạo tốn bao nhiêu#
Giả sử prompt khoảng 600 token đầu vào và trang hoàn chỉnh khoảng 6.000 token đầu ra (một giả định cho công cụ cỡ trung bình; dòng usage của bạn sẽ cho thấy con số thực). Một lần chạy trên DeepSeek-V4-Flash là $0.00061, và trên GLM-5.3-Flash là $0.00025. Cả hai đều là con số trực tiếp từ bảng giá hiện tại, và tổng cộng, tính cả đầu vào lẫn đầu ra, cả hai đều rẻ hơn OpenRouter.
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Chi phí | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
Tổng cộng 600 token đầu vào và 6.000 token đầu ra. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Trên thực tế bạn sẽ không có được công cụ đúng ngay lần đầu, nên hãy nghĩ theo vòng lặp: mười lần chỉnh prompt là mười lần dòng chi phí đó, vẫn là một khoản nhỏ cho một công cụ mà nếu không bạn phải tự viết tay. Gần như toàn bộ là phía đầu ra, chính là trang, nên thu nhỏ yêu cầu (ít điều khiển hơn) sẽ rút ngắn câu trả lời và hóa đơn.
Nếu nó không chạy#
Cuộn bảng sang phải →
| Bạn thấy gì | Nguyên nhân khả dĩ | Cần làm gì |
|---|---|---|
401 hoặc 404 từ API |
sai key, base URL hoặc model id | kiểm tra cả ba, xem Lỗi API 401 hoặc 404 |
Cut off at max_ |
trang dài hơn trần | tăng max_tokens hoặc yêu cầu ít hơn |
The reply has no closing </ |
model dừng sớm hoặc thêm văn bản | chạy lại; thêm "end with </html>" vào prompt |
| Trang mở nhưng nút không làm gì | lỗi JavaScript | mở console (F12), dán lỗi màu đỏ vào prompt tiếp theo |
Nếu bạn muốn phân tích phản hồi của model như dữ liệu thay vì một trang, mẹo trích xuất cũng giống như trong json.JSONDecodeError trên phản hồi LLM. Mới dùng API? Hãy bắt đầu với yêu cầu API đầu tiên của bạn.


