Tối ưu chi phíHướng dẫn
Cắt token output: độ dài câu trả lời, max_tokens, stop sequence
Rút ngắn câu trả lời AI theo thiết kế: yêu cầu một định dạng có giới hạn, giữ max_tokens như một giới hạn, dùng stop sequence, rồi xem chi phí của 1.000 request.
Trên trang này
Bot của bạn trả lời bằng 400 token khi 100 là đủ, và bạn trả tiền cho từng token một. Cách khắc phục chủ yếu nằm ở prompt: yêu cầu một định dạng có giới hạn, giữ max_tokens như một giới hạn an toàn thay vì một núm điều chỉnh độ dài, và kiểm tra usage. để xem thực sự đã trả về gì.
Điều này quan trọng vì output là phía đắt hơn trên mọi model chúng tôi cung cấp: xem giá trực tiếp trên trang giá. Cùng một câu hỏi, câu trả lời ngắn hơn, hóa đơn nhỏ hơn.
Bắt đầu từ prompt, không phải từ giới hạn#
Giả sử bạn vận hành một bot hỗ trợ với 2.000 ticket mỗi ngày. Mỗi ticket cần một danh mục và một câu lý do. Model, nếu để tự do, sẽ viết một đoạn thân thiện, một danh sách các lưu ý và một lời đề nghị hỗ trợ thêm. Đó là nơi 400 token ra đi.
So sánh
Cùng một ticket, hai prompt
Không giới hạn
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: một đoạn văn có lời chào, giải thích và lời đề nghị hỗ trợ (khoảng 400 token).
Có giới hạn
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: cùng ticket đó.
Answer: billing và một lý do ngắn (khoảng 100 token hoặc ít hơn).
Mẹo là bạn mô tả hình dạng của câu trả lời: số dòng, một danh sách nhãn đóng, một giới hạn từ. "Hãy ngắn gọn" hoạt động kém hơn "hai dòng, 15 từ", vì model có thứ cụ thể để đếm. Nếu bạn chỉ cần một nhãn, hãy yêu cầu nhãn và không gì khác. Một bộ phân loại phải trả về billing thì không nên được phép tự giải thích.
Điều tương tự cũng đúng với việc trích xuất JSON. Khi model bọc JSON của bạn trong văn xuôi, phần văn xuôi đó là output bạn trả tiền rồi vứt đi. Hãy đặt "Return only the JSON object, no text before or after it" trong system message. Để phân tích những gì trả về, xem cách trích xuất JSON từ câu trả lời của LLM.
max_tokens là dây an toàn#
Thật hấp dẫn khi đặt max_tokens: 100 và coi như xong. Đừng mong đợi câu trả lời ngắn từ nó. Tài liệu tham khảo API của DeepSeek (kiểm tra ngày 2 tháng 11 năm 2026) mô tả max_tokens là số token tối đa có thể được tạo ra trong completion, với input cộng output bị giới hạn bởi độ dài ngữ cảnh của model. Nó dừng việc tạo. Nó không khiến model lập kế hoạch cho một câu trả lời ngắn hơn.
Vì vậy một model muốn viết 400 token mà chỉ được 100 sẽ đưa bạn một câu kết thúc giữa chừng, finish_reason được đặt thành length, và một hóa đơn cho cả 100 token. Bạn đã trả tiền cho một câu trả lời không dùng được. Lý do điều đó xảy ra và cách sửa được đề cập trong vì sao câu trả lời AI dừng giữa câu và cách sửa finish_reason "length". Tôi sẽ không lặp lại ở đây.
Cách phân chia hiệu quả rất đơn giản:
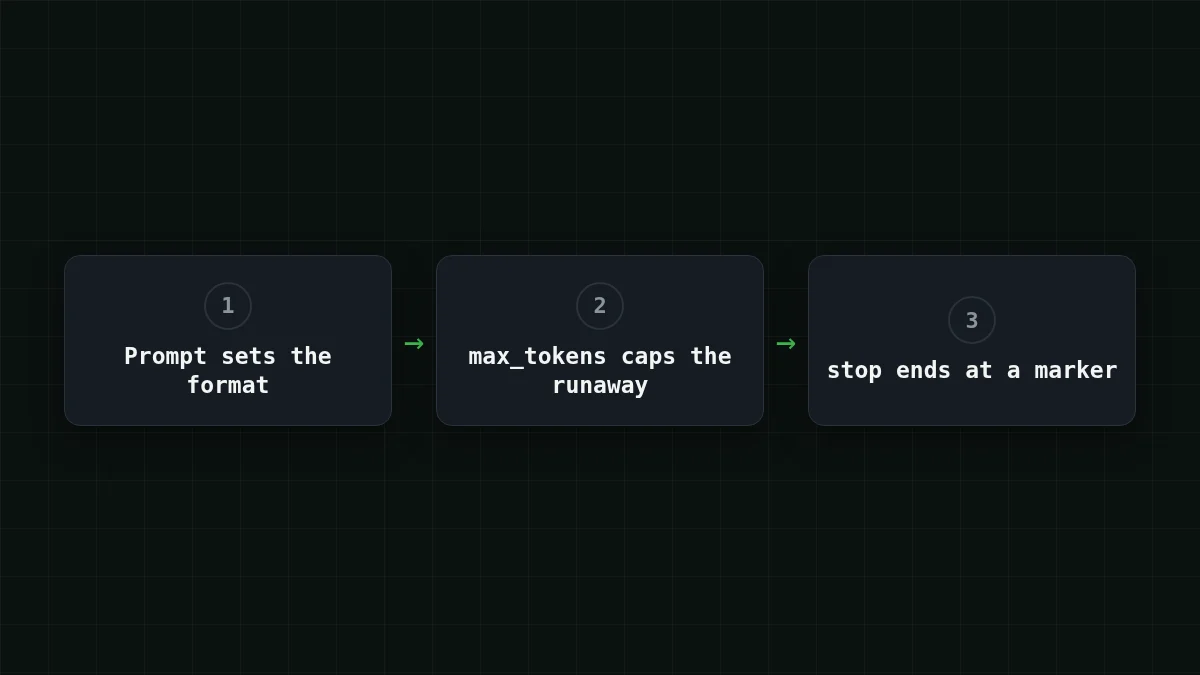
- prompt quyết định một câu trả lời tốt dài bao nhiêu;
max_tokensnằm cao hơn một chút so với câu trả lời tốt dài nhất, để một câu trả lời mất kiểm soát bị cắt thay vì phình to đến giới hạn output của model (tối đa 32.768 token trên DeepSeek-V4-Flash).
Với câu trả lời ticket hai dòng, 150 là quá đủ. Với một nhãn một từ, 20.
Stop sequence kết thúc câu trả lời tại một dấu hiệu#
Trong tài liệu tham khảo của DeepSeek, stop nhận tối đa 16 chuỗi, và việc tạo dừng lại khi model sắp tạo ra một trong số đó. Khi điều đó xảy ra, finish_reason là stop, giống như một kết thúc tự nhiên. Điều này tiện lợi khi định dạng của bạn có một dấu hiệu kết thúc. Yêu cầu câu trả lời, rồi một dòng với END, và đặt END trong stop. Hãy thử một lần trên thiết lập của riêng bạn: thực hiện một lệnh gọi và kiểm tra rằng finish_reason là stop và văn bản kết thúc trước dấu hiệu.
Một quy tắc: văn bản stop phải là thứ không thể xuất hiện bên trong một câu trả lời tốt. Một stop trên \n\n sẽ cắt một câu trả lời hai đoạn sau đoạn đầu tiên.
Một request bạn có thể chạy và đo#
Đây là lệnh gọi ticket có giới hạn. Id model là gateway_id đầy đủ từ tài liệu CheapTokens, và base URL là https:/. Tài liệu chỉ cách tạo khóa; đặt nó trong một biến môi trường.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
Trong phản hồi, hai thứ quan trọng: choices[0]. và đối tượng usage với prompt_tokens và completion_. Trong Python với gói openai nó trông như thế này:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Hãy chạy nó trên mười ticket thực trước khi bạn tin tưởng định dạng. Nếu completion_ vẫn nhỏ và finish_reason luôn là stop, prompt đang làm việc. Nếu bạn thấy length, giới hạn của bạn thấp hơn mức một câu trả lời tốt cần: hãy nâng nó lên hoặc siết chặt prompt, không phải cả hai một cách mù quáng.
Ghép cặp
Các trường cho bạn biết điều gì
Nhấn vào một mục bên trái, rồi đến cặp của nó
- lengthĐã đạt giới hạn max_tokens
- stopMột điểm dừng tự nhiên hoặc một stop sequence
- usage.completion_tokensSố token trong câu trả lời, phía output trong hóa đơn của bạn
Nếu finish_reason không phải stop, hãy xem giới hạn trước.
Tiết kiệm được gì trên 1.000 request#
Giờ đến hóa đơn. Giả sử một ticket cộng hướng dẫn là 300 token input, câu trả lời không giới hạn là 400 token output và câu trả lời có giới hạn là 100. Đây là các giả định cho ví dụ; hãy thay bằng số liệu từ usage của riêng bạn. Trên 1.000 request, đó là 300 × 1.000 = 300.000 token input trong cả hai trường hợp, và 400 × 1.000 = 400.000 token output so với 100 × 1.000 = 100.000.
Câu trả lời không giới hạn, 1.000 request:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 1.000 yêu cầu | OpenRouter, 1.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 token đầu vào và 400 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Câu trả lời có giới hạn, 1.000 request:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 1.000 yêu cầu | OpenRouter, 1.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 token đầu vào và 100 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Phía input không thay đổi, và đó chính là điểm mấu chốt: chỉ phần bạn rút ngắn mới rẻ hơn, và đó là phần có giá cao hơn. Theo từng model, cùng 1.000 ticket tốn $0.0445 khi không giới hạn và $0.0145 khi có giới hạn trên DeepSeek-V4-Flash. Tổng cộng, với input và output tính cùng nhau, cả ba model trong các bảng đều rẻ hơn giá tham chiếu của OpenRouter. Với câu trả lời ngắn, hãy chọn model từ các bảng trên: so sánh các hàng cho input và output của riêng bạn. GLM-5.3-Flash ($0.04 mỗi 1M token output) phù hợp nơi câu trả lời dài hơn, tối đa 8.192 token; trang DeepSeek có phần còn lại.
Thứ tự tôi sẽ áp dụng điều này#
Sắp xếp thứ tự
Sắp xếp các bước theo thứ tự hợp lý
Kéo các mục hoặc dùng mũi tên
- Viết định dạng câu trả lời vào prompt
- Đặt max_tokens cao hơn một chút so với câu trả lời tốt dài nhất
- Nếu API chấp nhận stop và định dạng có dấu hiệu kết thúc, thêm một stop sequence
- Ghi log completion_tokens và finish_reason cho mọi lệnh gọi
- So sánh chi phí của một lô 1.000 request trước và sau
Bước 4 là bước mọi người bỏ qua. Không có nó, bạn không biết liệu thay đổi prompt có hiệu quả hay liệu một vài câu trả lời dài đang kéo mức trung bình lên. Nếu bạn đã theo dõi chi tiêu, cách đếm token trong Python và token input so với output là nơi tốt để tiếp tục.


