लागत अनुकूलनगाइड
आउटपुट टोकन कम करें: उत्तर की लंबाई, max_tokens, स्टॉप सीक्वेंस
डिज़ाइन से AI उत्तर छोटे करें: एक सीमित फ़ॉर्मेट माँगें, max_tokens को कैप रखें, स्टॉप सीक्वेंस का उपयोग करें, फिर 1,000 अनुरोधों की लागत देखें।
इस पृष्ठ पर
आपका बॉट 400 टोकन में जवाब देता है जबकि 100 काफी होते, और आप उन सभी के लिए भुगतान करते हैं। इसका समाधान मुख्य रूप से प्रॉम्प्ट में है: एक सीमित फ़ॉर्मेट माँगें, max_tokens को लंबाई नियंत्रित करने के बजाय सुरक्षा कैप के रूप में रखें, और यह देखने के लिए usage. जाँचें कि वास्तव में क्या वापस आया।
यह मायने रखता है क्योंकि हमारे द्वारा दिए जाने वाले हर मॉडल पर आउटपुट महँगा पक्ष है: मूल्य पृष्ठ पर लाइव कीमतें देखें। वही प्रश्न, छोटा उत्तर, छोटा बिल।
सीमा से नहीं, प्रॉम्प्ट से शुरू करें#
मान लें कि आप एक सपोर्ट बॉट चलाते हैं जिसमें प्रतिदिन 2,000 टिकट आते हैं। प्रत्येक टिकट को एक श्रेणी और कारण का एक वाक्य चाहिए। मॉडल, अकेला छोड़े जाने पर, एक मैत्रीपूर्ण अनुच्छेद, चेतावनियों की सूची और आगे सहायता की पेशकश लिखता है। यहीं 400 टोकन खर्च होते हैं।
तुलना करें
वही टिकट, दो प्रॉम्प्ट
खुला
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: अभिवादन, एक व्याख्या और सहायता की पेशकश वाला एक अनुच्छेद (लगभग 400 टोकन)।
सीमित
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: वही टिकट।
Answer: billing और एक छोटा कारण (लगभग 100 टोकन या कम)।
तरकीब यह है कि आप उत्तर का आकार बताते हैं: पंक्तियों की संख्या, लेबल की एक बंद सूची, शब्द सीमा। "संक्षिप्त रहें" से "दो पंक्तियाँ, 15 शब्द" बेहतर काम करता है, क्योंकि मॉडल के पास गिनने के लिए कुछ ठोस होता है। यदि आपको केवल एक लेबल चाहिए, तो लेबल माँगें और कुछ नहीं। एक क्लासिफ़ायर जिसे billing लौटाना है, उसे अपना बचाव करने की अनुमति नहीं होनी चाहिए।
यही JSON निष्कर्षण पर भी लागू होता है। जब मॉडल आपके JSON को गद्य में लपेटता है, तो वह गद्य आउटपुट होता है जिसके लिए आप भुगतान करते हैं और फिर फेंक देते हैं। सिस्टम संदेश में "Return only the JSON object, no text before or after it" डालें। जो वापस आता है उसे पार्स करने के लिए, LLM उत्तर से JSON कैसे निकालें देखें।
max_tokens एक सीटबेल्ट है#
max_tokens: 100 सेट करके इसे पूरा मान लेना लुभावना है। इससे छोटे उत्तरों की अपेक्षा न करें। DeepSeek का API संदर्भ (2 नवंबर 2026 को जाँचा गया) max_tokens को कम्प्लीशन में उत्पन्न किए जा सकने वाले टोकन की अधिकतम संख्या के रूप में वर्णित करता है, जिसमें इनपुट और आउटपुट मॉडल की कॉन्टेक्स्ट लंबाई से सीमित होते हैं। यह जनरेशन रोकता है। यह मॉडल को छोटा उत्तर योजना बनाने पर मजबूर नहीं करता।
तो एक मॉडल जो 400 टोकन लिखना चाहता था और उसे 100 मिले, आपको बीच में समाप्त होने वाला एक वाक्य देता है, finish_reason को length पर सेट किया गया, और सभी 100 टोकन का बिल। आपने ऐसे उत्तर के लिए भुगतान किया जिसका आप उपयोग नहीं कर सकते। ऐसा क्यों होता है और इसे कैसे ठीक करें, यह AI उत्तर वाक्य के बीच में क्यों रुकता है और finish_reason "length" का समाधान में शामिल है। मैं इसे यहाँ दोहराऊँगा नहीं।
कार्यशील विभाजन सरल है:
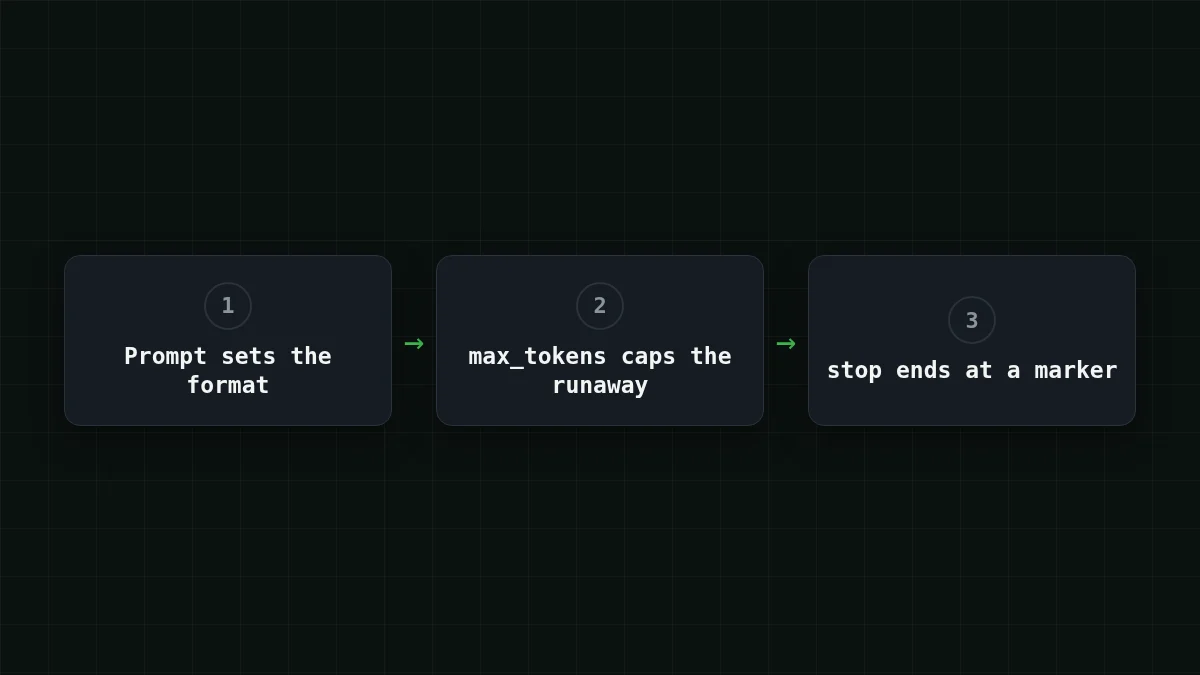
- प्रॉम्प्ट तय करता है कि एक अच्छा उत्तर कितना लंबा है;
max_tokensसबसे लंबे अच्छे उत्तर से थोड़ा ऊपर रहता है, ताकि बेकाबू उत्तर कट जाए बजाय मॉडल की आउटपुट सीमा (DeepSeek-V4-Flash पर 32,768 टोकन तक) तक बढ़ने के।
दो-पंक्ति वाले टिकट उत्तर के लिए, 150 पर्याप्त है। एक-शब्द लेबल के लिए, 20।
स्टॉप सीक्वेंस एक मार्कर पर उत्तर समाप्त करते हैं#
DeepSeek के संदर्भ में, stop अधिकतम 16 सीक्वेंस लेता है, और जनरेशन तब रुक जाता है जब मॉडल उनमें से एक उत्पन्न करने वाला हो। जब ऐसा होता है, finish_reason stop होता है, जो प्राकृतिक अंत के समान है। यह तब उपयोगी है जब आपके फ़ॉर्मेट में एक अंत मार्कर हो। उत्तर माँगें, फिर END वाली एक पंक्ति, और END को stop में डालें। इसे अपने सेटअप पर एक बार परखें: एक कॉल करें और जाँचें कि finish_reason stop है और टेक्स्ट मार्कर से पहले समाप्त होता है।
एक नियम: स्टॉप टेक्स्ट ऐसा होना चाहिए जो एक अच्छे उत्तर के अंदर नहीं आ सकता। \n\n पर स्टॉप दो-अनुच्छेद वाले उत्तर को पहले अनुच्छेद के बाद काट देता है।
एक अनुरोध जिसे आप चला और माप सकते हैं#
यहाँ सीमित टिकट कॉल है। मॉडल आईडी CheapTokens दस्तावेज़ों से पूरा gateway_id है, और बेस URL https:/ है। दस्तावेज़ दिखाते हैं कि कुंजी कैसे बनाएँ; इसे एक एनवायरनमेंट वेरिएबल में रखें।
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
प्रतिक्रिया में, दो चीज़ें मायने रखती हैं: choices[0]. और usage ऑब्जेक्ट जिसमें prompt_tokens और completion_ हैं। Python में openai पैकेज के साथ यह ऐसा दिखता है:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
फ़ॉर्मेट पर भरोसा करने से पहले इसे दस वास्तविक टिकटों पर चलाएँ। यदि completion_ छोटा रहता है और finish_reason हमेशा stop है, तो प्रॉम्प्ट काम कर रहा है। यदि आप length देखते हैं, तो आपकी सीमा एक अच्छे उत्तर के लिए आवश्यकता से कम है: इसे बढ़ाएँ या प्रॉम्प्ट को कसें, दोनों को अंधाधुंध नहीं।
जोड़े मिलाएँ
फ़ील्ड आपको क्या बताते हैं
बाईं ओर एक आइटम पर टैप करें, फिर उसका जोड़ा
- lengthmax_tokens सीमा तक पहुँच गया
- stopएक प्राकृतिक स्टॉप बिंदु या एक स्टॉप सीक्वेंस
- usage.completion_tokensउत्तर में टोकन, आपके बिल का आउटपुट पक्ष
यदि finish_reason stop नहीं है, तो पहले सीमा देखें।
1,000 अनुरोधों पर यह क्या बचाता है#
अब बिल। मान लें कि एक टिकट और निर्देश 300 इनपुट टोकन हैं, खुला उत्तर 400 आउटपुट टोकन है और सीमित 100। ये उदाहरण के लिए अनुमान हैं; अपने स्वयं के usage के आँकड़े डालें। 1,000 अनुरोधों पर, यह दोनों स्थितियों में 300 × 1,000 = 300,000 इनपुट टोकन है, और 400 × 1,000 = 400,000 आउटपुट टोकन बनाम 100 × 1,000 = 100,000।
खुले उत्तर, 1,000 अनुरोध:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
प्रति अनुरोध 300 इनपुट और 400 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
सीमित उत्तर, 1,000 अनुरोध:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
प्रति अनुरोध 300 इनपुट और 100 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
इनपुट पक्ष नहीं हिलता, और यही बात है: केवल वह हिस्सा सस्ता होता है जिसे आपने छोटा किया, और वही हिस्सा है जिसकी कीमत अधिक है। प्रति मॉडल, वही 1,000 टिकट DeepSeek-V4-Flash पर खुले $0.0445 और सीमित $0.0145 में खर्च होते हैं। कुल मिलाकर, इनपुट और आउटपुट को एक साथ गिनते हुए, तालिकाओं में सभी तीन मॉडल OpenRouter के संदर्भ मूल्य से सस्ते निकलते हैं। छोटे उत्तरों के लिए, ऊपर की तालिकाओं से मॉडल चुनें: अपने स्वयं के इनपुट और आउटपुट के लिए पंक्तियों की तुलना करें। GLM-5.3-Flash ($0.04 प्रति 1M आउटपुट टोकन) वहाँ फिट बैठता है जहाँ उत्तर लंबे रहते हैं, 8,192 टोकन तक; बाकी DeepSeek पृष्ठ पर है।
मैं इसे इस क्रम में लागू करूँगा#
क्रम में लगाएँ
चरणों को एक समझदार क्रम में रखें
आइटम खींचें या तीरों का उपयोग करें
- उत्तर का फ़ॉर्मेट प्रॉम्प्ट में लिखें
- max_tokens को सबसे लंबे अच्छे उत्तर से थोड़ा ऊपर सेट करें
- यदि API stop स्वीकार करता है और फ़ॉर्मेट में अंत मार्कर है, तो एक स्टॉप सीक्वेंस जोड़ें
- हर कॉल के लिए completion_tokens और finish_reason लॉग करें
- पहले और बाद में 1,000-अनुरोध बैच की लागत की तुलना करें
चरण 4 वह है जिसे लोग छोड़ देते हैं। इसके बिना आप नहीं जानते कि प्रॉम्प्ट परिवर्तन काम कर गया या कुछ लंबे उत्तर औसत को ऊपर खींच रहे हैं। यदि आप पहले से खर्च ट्रैक करते हैं, तो Python में टोकन-गिनती का तरीका और इनपुट बनाम आउटपुट टोकन जारी रखने के लिए अच्छी जगह हैं।


