Оптимизация расходовИнструкция
Как сократить output-токены: формат, max_tokens, stop
Как сделать ответы модели короче нарочно: формат в промпте, max_tokens как предохранитель, stop-последовательности и расчёт на 1000 запросов.
Содержание
Бот отвечает 400 токенами, хотя хватило бы 100, и вы платите за каждый. Чинится это в основном промптом: попросите ограниченный формат, держите max_tokens как предохранитель, а не как регулятор длины, и смотрите в usage., сколько реально пришло.
Это важно, потому что выход дороже входа у каждой нашей модели: живые цены — на странице цен. Тот же вопрос, ответ короче, счёт меньше.
Сначала промпт, потом лимит#
Допустим, у вас бот поддержки и 2000 обращений в день. На каждое нужны категория и одно предложение с причиной. Если ничего не ограничивать, модель напишет дружелюбный абзац, список оговорок и предложение помочь ещё. Вот туда и уходят 400 токенов.
Сравнение
Одно обращение, два промпта
Без ограничений
System: You are a helpful support assistant. User: Определи тип обращения: "Дважды списали деньги за заказ 1182." Ответ: абзац с приветствием, объяснением и предложением помочь (около 400 токенов).
С форматом
System: Ответь ровно двумя строками. Строка 1: категория из billing, bug, other. Строка 2: причина не длиннее 15 слов. Без приветствия.
User: то же обращение.
Ответ: billing и короткая причина (около 100 токенов или меньше).
Секрет в том, что вы описываете форму ответа: число строк, закрытый список меток, лимит слов. «Отвечай кратко» работает хуже, чем «две строки, 15 слов»: у модели появляется что-то, что можно сосчитать. Нужна только метка — просите метку и ничего больше. Классификатор, который должен вернуть billing, не обязан объяснять себя.
С извлечением JSON то же самое. Когда модель оборачивает JSON в текст, этот текст — выход, за который вы платите, а потом выбрасываете. Напишите в системном сообщении: «Верни только JSON-объект, без текста до и после». О том, как разобрать ответ, — в статье как достать JSON из ответа LLM.
max_tokens — это ремень безопасности#
Соблазн велик: поставить max_tokens: 100 и считать дело сделанным. Короткого ответа от него не ждите. В справочнике API DeepSeek (проверено 2 ноября 2026) max_tokens — максимальное число токенов, которое может быть сгенерировано в ответе; вход плюс выход ограничены длиной контекста модели. Он останавливает генерацию. Планировать ответ короче модель он не заставит.
Поэтому модель, которая собиралась написать 400 токенов и получила 100, отдаёт вам предложение, оборванное на полуслове, finish_reason равен length, а счёт выставлен за все 100 токенов. Вы заплатили за ответ, которым нельзя пользоваться. Почему так происходит и как это чинить — в статьях почему ответ ИИ обрывается на полуслове и как исправить finish_reason "length". Повторяться не буду.
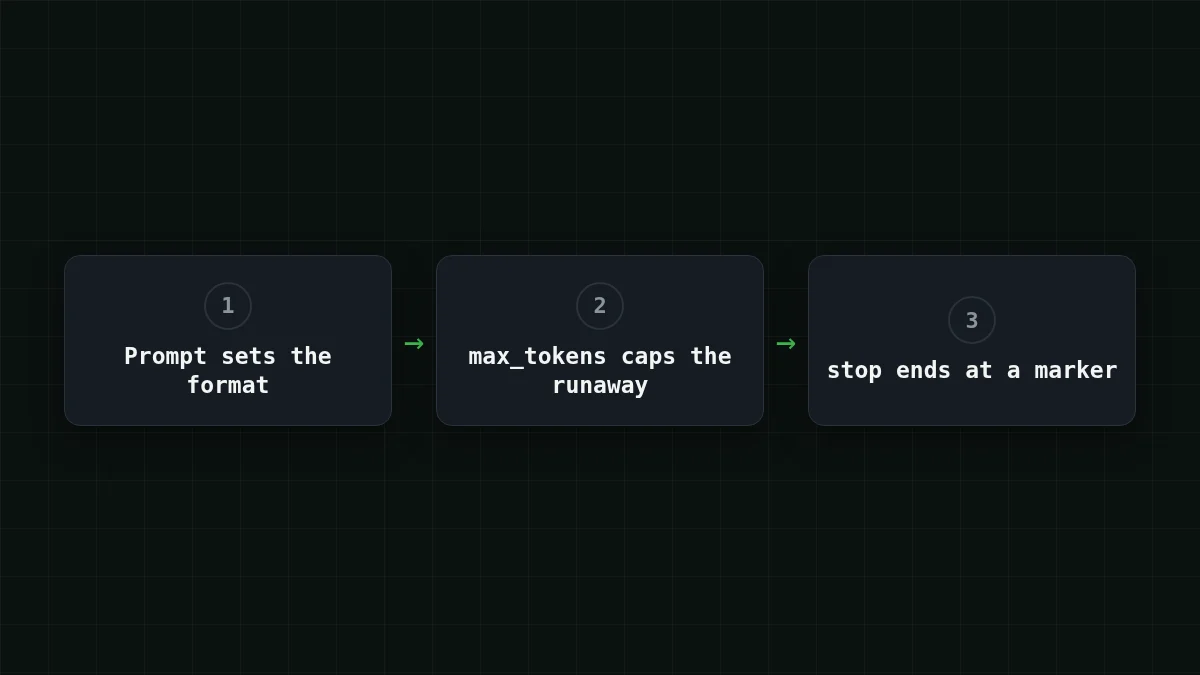
Рабочее разделение простое:
- длину хорошего ответа определяет промпт;
max_tokensстоит чуть выше самого длинного хорошего ответа, чтобы разошедшийся ответ обрезался, а не рос до предела вывода модели (до 32 768 токенов у DeepSeek-V4-Flash).
Для двухстрочного ответа про обращение хватит 150. Для метки из одного слова — 20.
Stop-последовательность обрывает ответ на маркере#
В том же справочнике сказано: stop принимает до 16 последовательностей, и генерация останавливается, когда модель собирается их выдать. Тогда finish_reason равен stop, как и при обычном завершении. Это удобно, если в формате есть маркер конца. Попросите ответ, затем строку END, и положите END в stop. Проверьте на своей установке: сделайте один вызов и убедитесь, что finish_reason равен stop, а текст кончается до маркера.
Одно правило: stop-текст не должен встречаться внутри хорошего ответа. Остановка на \n\n обрежет двухабзацный ответ после первого абзаца.
Запрос, который можно запустить и измерить#
Вот ограниченный запрос про обращение. Id модели — полный gateway_id из документации CheapTokens, базовый адрес — https:/. Как создать ключ, показано в документации; положите его в переменную окружения.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
В ответе важны две вещи: choices[0]. и объект usage с prompt_tokens и completion_. В Python с пакетом openai это выглядит так:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Прогоните десять настоящих обращений, прежде чем верить формату. Если completion_ остаётся маленьким, а finish_reason всегда stop, работает промпт. Если видите length, лимит ниже, чем нужно хорошему ответу: поднимите его или ужесточите промпт, но не оба сразу вслепую.
Найдите пары
Что говорят поля
Нажмите на элемент слева, затем на его пару
- lengthДостигнут лимит max_tokens
- stopЕстественное завершение или stop-последовательность
- usage.completion_tokensТокены ответа, выходная сторона вашего счёта
Если finish_reason не stop, сначала смотрите на лимит.
Сколько это экономит на 1000 запросов#
Теперь счёт. Допустим, обращение вместе с инструкциями — 300 входных токенов, ответ без ограничений — 400 выходных, а с форматом — 100. Это допущения для примера, подставьте цифры из своего usage. На 1000 запросов выходит 300 × 1000 = 300 000 входных токенов в обоих случаях и 400 × 1000 = 400 000 выходных против 100 × 1000 = 100 000.
Ответы без ограничений, 1000 запросов:
| Модель | Вход $/1M | Выход $/1M | За запрос | 1 000 запросов | OpenRouter, 1 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 входных и 400 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Ответы с форматом, 1000 запросов:
| Модель | Вход $/1M | Выход $/1M | За запрос | 1 000 запросов | OpenRouter, 1 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 входных и 100 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Вход не меняется, и в этом суть: дешевеет только то, что вы сократили, а это как раз сторона с большей ценой. По моделям: те же 1000 обращений на DeepSeek-V4-Flash стоят $0.0445 без ограничений и $0.0145 с форматом. В сумме, с учётом входа и выхода, все три модели в таблицах выходят дешевле референсной цены OpenRouter. Для коротких ответов модель лучше выбирать по таблицам выше: сравните строки для своих входа и выхода. GLM-5.3-Flash ($0.04 за 1M выходных токенов) пригодится там, где ответы остаются длиннее, до 8 192 токенов; остальное — на странице DeepSeek.
В каком порядке это внедрять#
Расставьте по порядку
Расставьте шаги по порядку
Перетащите элементы или используйте стрелки
- Впишите формат ответа в промпт
- Поставьте max_tokens чуть выше самого длинного хорошего ответа
- Если API принимает stop и у формата есть маркер конца, добавьте stop-последовательность
- Логируйте completion_tokens и finish_reason в каждом вызове
- Сравните стоимость пачки из 1000 запросов до и после
Четвёртый шаг пропускают чаще всего. Без него не понять, сработало ли изменение промпта или несколько длинных ответов тянут среднее вверх. Если вы уже следите за расходами, дальше полезны подсчёт токенов на запрос и разбор input и output токенов.


