Оптимізація витратПосібник
Скоротіть вихідні токени: довжина відповіді, max_tokens, стоп-послідовності
Скоротіть відповіді AI за задумом: просіть обмежений формат, тримайте max_tokens як ліміт, використовуйте стоп-послідовності, а потім подивіться на вартість 1 000 запитів.
На цій сторінці
Ваш бот відповідає 400 токенами там, де вистачило б 100, і ви платите за кожен із них. Виправлення здебільшого в промпті: просіть обмежений формат, тримайте max_tokens як запобіжник, а не як регулятор довжини, і перевіряйте usage., щоб побачити, що насправді повернулося.
Це важливо, бо вивід — дорожча сторона на кожній моделі, яку ми пропонуємо: дивіться актуальні ціни на сторінці цін. Те саме питання, коротша відповідь, менший рахунок.
Почніть із промпту, а не з ліміту#
Припустімо, ви керуєте ботом підтримки з 2 000 тікетів на день. Кожному тікету потрібна категорія й одне речення причини. Модель, залишена сама собі, пише привітний абзац, список застережень і пропозицію допомогти далі. Ось куди йдуть 400 токенів.
Порівняйте
Той самий тікет, два промпти
Відкритий
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: абзац із привітанням, поясненням і пропозицією допомогти (близько 400 токенів).
Обмежений
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: той самий тікет.
Answer: billing і одна коротка причина (близько 100 токенів або менше).
Хитрість у тому, що ви описуєте форму відповіді: кількість рядків, закритий список міток, обмеження слів. «Будь коротким» працює гірше за «два рядки, 15 слів», бо модель має що конкретно порахувати. Якщо вам потрібна лише мітка, просіть мітку і нічого більше. Класифікатор, який має повернути billing, не повинен мати змоги пояснювати себе.
Те саме стосується вилучення JSON. Коли модель загортає ваш JSON у прозу, ця проза — це вивід, за який ви платите, а потім викидаєте. Додайте в системне повідомлення «Return only the JSON object, no text before or after it». Про розбір того, що повертається, дивіться як витягти JSON із відповіді LLM.
max_tokens — це ремінь безпеки#
Спокусливо встановити max_tokens: 100 і вважати справу зробленою. Не очікуйте від цього коротких відповідей. Довідка API DeepSeek (перевірено 2 листопада 2026) описує max_tokens як максимальну кількість токенів, які можна згенерувати в завершенні, причому вхід плюс вихід обмежені довжиною контексту моделі. Це зупиняє генерацію. Це не змушує модель планувати коротшу відповідь.
Тож модель, яка хотіла написати 400 токенів і отримала 100, віддає вам речення, що обривається посередині, finish_reason зі значенням length, і рахунок за всі 100 токенів. Ви заплатили за відповідь, яку не можете використати. Чому це відбувається і як це виправити, описано в чому відповідь AI обривається посеред речення і виправлення finish_reason "length". Я не повторюватиму це тут.
Робочий поділ простий:
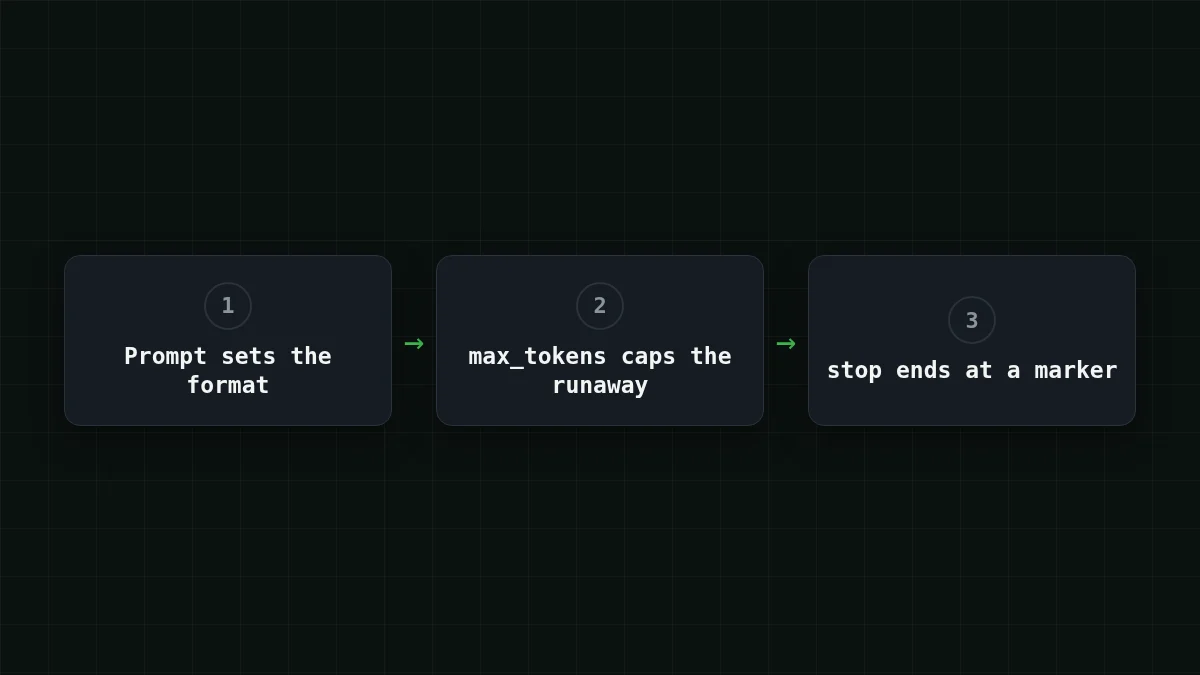
- промпт визначає, якою довгою має бути хороша відповідь;
max_tokensстоїть трохи вище за найдовшу хорошу відповідь, щоб неконтрольована відповідь обрізалася, а не росла до ліміту виводу моделі (до 32 768 токенів на DeepSeek-V4-Flash).
Для дворядкової відповіді на тікет 150 — цілком достатньо. Для мітки з одного слова — 20.
Стоп-послідовності завершують відповідь на маркері#
У довідці DeepSeek stop приймає до 16 послідовностей, і генерація зупиняється, коли модель мала б згенерувати одну з них. Коли це стається, finish_reason дорівнює stop, так само як при природному завершенні. Це зручно, коли ваш формат має маркер кінця. Просіть відповідь, потім рядок з END, і покладіть END у stop. Перевірте це один раз на своєму налаштуванні: зробіть один виклик і переконайтеся, що finish_reason дорівнює stop, а текст закінчується перед маркером.
Одне правило: стоп-текст має бути чимось, що не може з'явитися всередині хорошої відповіді. Стоп на \n\n обрізає відповідь із двох абзаців після першого абзацу.
Запит, який можна запустити й виміряти#
Ось обмежений виклик для тікета. Ідентифікатор моделі — це повний gateway_id з документації CheapTokens, а базова URL-адреса — https:/. Документація показує, як створити ключ; покладіть його в змінну середовища.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
У відповіді важливі дві речі: choices[0]. і об'єкт usage з prompt_tokens та completion_. У Python з пакетом openai це виглядає так:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Запустіть це на десяти реальних тікетах, перш ніж довіряти формату. Якщо completion_ залишається малим, а finish_reason завжди stop, промпт робить свою роботу. Якщо ви бачите length, ваш ліміт нижчий за те, що потрібно хорошій відповіді: підніміть його або посильте промпт, але не обидва наосліп.
З'єднайте пари
Що вам кажуть поля
Торкніться елемента ліворуч, потім його пари
- lengthДосягнуто ліміту max_tokens
- stopПриродна точка зупинки або стоп-послідовність
- usage.completion_tokensТокени у відповіді, сторона виводу у вашому рахунку
Якщо finish_reason не дорівнює stop, спершу подивіться на ліміт.
Що це економить на 1 000 запитів#
Тепер рахунок. Припустімо, тікет плюс інструкції — це 300 вхідних токенів, відкрита відповідь — 400 вихідних токенів, а обмежена — 100. Це припущення для прикладу; підставте числа зі свого власного usage. На 1 000 запитів це 300 × 1 000 = 300 000 вхідних токенів в обох випадках, і 400 × 1 000 = 400 000 вихідних токенів проти 100 × 1 000 = 100 000.
Відкриті відповіді, 1 000 запитів:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 1 000 запитів | OpenRouter, 1 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 вхідних і 400 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Обмежені відповіді, 1 000 запитів:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 1 000 запитів | OpenRouter, 1 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 вхідних і 100 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Вхідна сторона не змінюється, і в цьому суть: дешевшає лише та частина, яку ви скоротили, а це частина з вищою ціною. Для кожної моделі ті самі 1 000 тікетів коштують $0.0445 у відкритому варіанті та $0.0145 в обмеженому на DeepSeek-V4-Flash. Загалом, з урахуванням входу й виходу разом, усі три моделі в таблицях виходять дешевшими за довідкову ціну OpenRouter. Для коротких відповідей вибирайте модель із таблиць вище: порівняйте рядки для свого входу й виходу. GLM-5.3-Flash ($0.04 за 1 млн вихідних токенів) підходить там, де відповіді довші, до 8 192 токенів; решта — на сторінці DeepSeek.
У якому порядку я б це застосовував#
Розставте по порядку
Розставте кроки в розумному порядку
Перетягніть елементи або скористайтеся стрілками
- Запишіть формат відповіді в промпт
- Встановіть max_tokens трохи вище за найдовшу хорошу відповідь
- Якщо API приймає stop і формат має маркер кінця, додайте стоп-послідовність
- Логуйте completion_tokens і finish_reason для кожного виклику
- Порівняйте вартість пакета з 1 000 запитів до і після
Крок 4 — це той, який люди пропускають. Без нього ви не знаєте, чи спрацювала зміна промпту, чи кілька довгих відповідей тягнуть середнє вгору. Якщо ви вже відстежуєте витрати, підхід до підрахунку токенів у Python і вхідні проти вихідних токенів — гарне місце, щоб продовжити.


