コスト最適化ガイド
出力トークンを削減: 回答の長さ、max_tokens、停止シーケンス
設計でAIの回答を短くする: 範囲限定の形式を要求し、max_tokensを上限として保ち、停止シーケンスを使い、1,000リクエストのコストを確認する。
このページの内容
ボットが100トークンで済むところを400トークンで答えており、そのすべてに料金を払っています。修正のほとんどはプロンプトにあります。範囲を限定した形式を要求し、max_tokensは長さの調整つまみではなく安全上限として使い、usage.を確認して実際に何が返ってきたかを見ましょう。
これが重要なのは、提供するすべてのモデルで出力側の方が高価だからです。最新の価格は料金ページで確認できます。同じ質問、短い回答、少ない請求です。
制限ではなくプロンプトから始める#
1日に2,000件のチケットを処理するサポートボットを運用しているとします。各チケットにはカテゴリと理由を1文で付ける必要があります。モデルを放置すると、親しみやすい段落、注意事項のリスト、さらに支援を申し出る文を書きます。そこに400トークンが費やされます。
比較する
同じチケット、2つのプロンプト
自由形式
System: あなたは親切なサポートアシスタントです。 User: このチケットがどの種類か教えてください:「注文1182でカードが二重に請求されました。」 Answer: 挨拶、説明、支援の申し出を含む段落(約400トークン)。
範囲限定
System: ちょうど2行で答えてください。1行目: カテゴリ。billing、bug、other のいずれか。2行目: 15語以内の理由。挨拶は不要。
User: 同じチケット。
Answer: billing と短い理由(約100トークン以下)。
コツは回答の形を指定することです。行数、閉じたラベルのリスト、語数制限などです。「簡潔に」は「2行、15語」よりもうまくいきません。モデルが数えられる具体的なものがあるからです。ラベルだけが必要なら、ラベルだけを要求し、それ以外は求めないでください。billingを返さなければならない分類器に、自己説明を許すべきではありません。
JSON抽出も同じです。モデルがJSONを文章で包むと、その文章は料金を払って出力し、その後捨てるものになります。システムメッセージに「JSONオブジェクトのみを返し、前後にテキストを付けないでください」と入れましょう。返ってきたものの解析については、LLMの返信からJSONを抽出する方法を参照してください。
max_tokensはシートベルト#
max_tokens: 100を設定して終わりにしたくなりますが、それで短い回答を期待してはいけません。DeepSeekのAPIリファレンス(2026年11月2日確認)では、max_tokensは補完で生成できるトークンの最大数であり、入力と出力の合計はモデルのコンテキスト長で上限が決まると説明されています。これは生成を停止しますが、モデルに短い回答を計画させるわけではありません。
つまり、400トークン書きたかったモデルに100を与えると、途中で終わる文、finish_reasonがlengthに設定され、100トークンすべての請求が返ってきます。使えない回答に料金を払ったことになります。なぜそうなるか、どう修復するかはAIの回答が途中で止まる理由とfinish_reason "length"の修正で扱っています。ここでは繰り返しません。
実用的な分担は単純です:
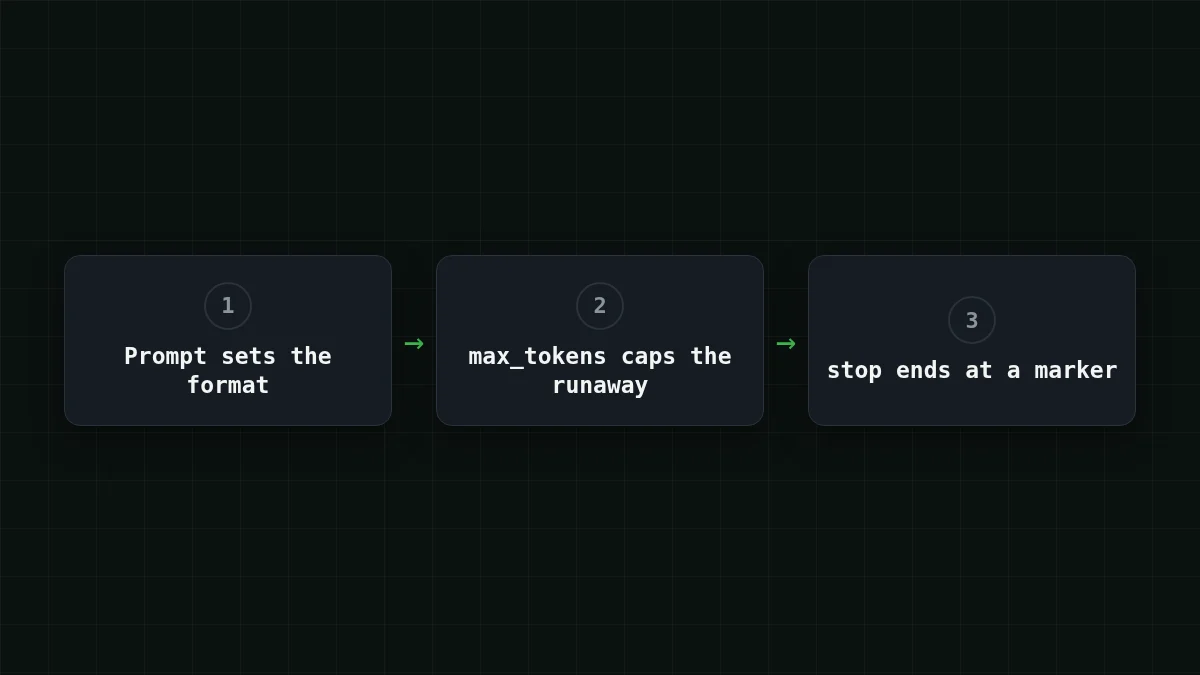
- プロンプトが良い回答の長さを決める;
max_tokensは最長の良い回答より少し上に置き、暴走した返信がモデルの出力上限(DeepSeek-V4-Flashでは最大32,768トークン)まで伸びるのではなく切られるようにする。
2行のチケット回答なら150で十分です。1語のラベルなら20です。
停止シーケンスはマーカーで回答を終わらせる#
DeepSeekのリファレンスでは、stopは最大16個のシーケンスを受け取り、モデルがそれを生成しようとすると生成が停止します。そのときfinish_reasonはstopになり、自然な終了と同じです。これは形式に終了マーカーがある場合に便利です。回答を要求し、次にENDを含む行を要求し、ENDをstopに入れます。自分の環境で一度テストしてください。1回呼び出して、finish_reasonがstopであり、テキストがマーカーの前で終わることを確認します。
1つのルール: 停止テキストは良い回答の中に現れ得ないものでなければなりません。\n\nで停止すると、2段落の回答が最初の段落の後で切れます。
実行して測定できるリクエスト#
範囲限定のチケット呼び出しは次のとおりです。モデルIDはCheapTokensのドキュメントにある完全なgateway_idで、ベースURLはhttps:/です。ドキュメントにキーの作成方法が示されています。環境変数に入れてください。
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
レスポンスでは2つが重要です: choices[0].と、prompt_tokensとcompletion_を含むusageオブジェクトです。Pythonでopenaiパッケージを使うと次のようになります:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)形式を信頼する前に、10件の実際のチケットで実行してください。completion_が小さく、finish_reasonが常にstopなら、プロンプトが仕事をしています。lengthが表示されるなら、上限が良い回答に必要な量を下回っています。上限を上げるかプロンプトを厳しくするか、どちらか一方にしてください。両方を盲目的にではありません。
ペアを合わせる
フィールドが教えてくれること
左の項目をタップしてから、そのペアをタップ
- lengthmax_tokensの上限に達した
- stop自然な停止点または停止シーケンス
- usage.completion_tokens回答内のトークン数、請求の出力側
finish_reasonがstopでないなら、まず上限を確認してください。
1,000リクエストでどれだけ節約できるか#
では請求です。チケットと指示で入力300トークン、自由形式の回答が出力400トークン、範囲限定が100トークンと仮定します。これは例のための仮定です。自分のusageの数値に置き換えてください。1,000リクエストでは、どちらの場合も入力は300 × 1,000 = 300,000トークン、出力は400 × 1,000 = 400,000トークン対100 × 1,000 = 100,000トークンです。
自由形式の回答、1,000リクエスト:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
リクエストあたり 300 入力トークンと 400 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
範囲限定の回答、1,000リクエスト:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
リクエストあたり 300 入力トークンと 100 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
入力側は変わりません。それが要点です。短縮した部分だけが安くなり、しかもそれは単価の高い部分です。モデルごとに、同じ1,000チケットはDeepSeek-V4-Flashで自由形式$0.0445、範囲限定$0.0145です。入力と出力を合計すると、表の3モデルすべてがOpenRouterの参考価格より安くなります。短い回答には上の表からモデルを選んでください。自分の入力と出力の行を比較しましょう。GLM-5.3-Flash(出力1Mトークンあたり$0.04)は回答がより長く、最大8,192トークンまで続く場合に適しています。残りはDeepSeekページにあります。
私ならこの順序で適用する#
順番に並べる
手順を合理的な順序に並べる
項目をドラッグするか矢印を使う
- 回答形式をプロンプトに書く
- max_tokensを最長の良い回答より少し上に設定する
- APIがstopを受け付け、形式に終了マーカーがあるなら停止シーケンスを追加する
- すべての呼び出しでcompletion_tokensとfinish_reasonをログに記録する
- 1,000リクエストのバッチのコストを前後で比較する
ステップ4は人々が飛ばすものです。これがないと、プロンプトの変更が効いたのか、いくつかの長い回答が平均を押し上げているのか分かりません。すでに支出を追跡しているなら、Pythonでのトークン計数アプローチと入力トークンと出力トークンが続きとして良いでしょう。


