Ridurre i token di output: lunghezza della risposta, max_tokens, sequenze di stop
Accorcia le risposte AI per progettazione: chiedi un formato delimitato, mantieni max_tokens come limite, usa le sequenze di stop, poi guarda il costo di 1.000 richieste.
In questa pagina
Il tuo bot risponde con 400 token quando ne basterebbero 100, e li paghi tutti. La soluzione sta soprattutto nel prompt: chiedi un formato delimitato, mantieni max_tokens come limite di sicurezza anziché come manopola della lunghezza, e controlla usage. per vedere cosa è effettivamente tornato.
Questo conta perché l'output è il lato più caro su ogni modello che offriamo: guarda i prezzi aggiornati sulla pagina dei prezzi. Stessa domanda, risposta più breve, bolletta più piccola.
Parti dal prompt, non dal limite#
Immagina di gestire un bot di supporto con 2.000 ticket al giorno. Ogni ticket richiede una categoria e una frase di motivazione. Il modello, lasciato a sé, scrive un paragrafo cordiale, un elenco di avvertenze e un'offerta di ulteriore aiuto. È lì che finiscono i 400 token.
Confronta
Stesso ticket, due prompt
Aperto
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: un paragrafo con un saluto, una spiegazione e un'offerta di aiuto (circa 400 token).
Delimitato
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: lo stesso ticket.
Answer: billing e una breve motivazione (circa 100 token o meno).
Il trucco è descrivere la forma della risposta: numero di righe, un elenco chiuso di etichette, un limite di parole. "Sii breve" funziona peggio di "due righe, 15 parole", perché il modello ha qualcosa di concreto da contare. Se ti serve solo un'etichetta, chiedi l'etichetta e nient'altro. Un classificatore che deve restituire billing non dovrebbe poter spiegarsi.
Lo stesso vale per l'estrazione JSON. Quando il modello avvolge il tuo JSON in prosa, la prosa è output che paghi e poi butti via. Metti "Return only the JSON object, no text before or after it" nel messaggio di sistema. Per fare il parsing di ciò che torna, vedi come estrarre JSON da una risposta LLM.
max_tokens è una cintura di sicurezza#
È tentante impostare max_tokens: 100 e considerarlo fatto. Non aspettarti risposte brevi da questo. La documentazione API di DeepSeek (verificata il 2 novembre 2026) descrive max_tokens come il numero massimo di token che possono essere generati nel completamento, con input più output limitati dalla lunghezza del contesto del modello. Ferma la generazione. Non fa pianificare al modello una risposta più breve.
Quindi un modello che voleva scrivere 400 token e ne ha ricevuti 100 ti consegna una frase che finisce a metà, finish_reason impostato a length, e una bolletta per tutti i 100 token. Hai pagato per una risposta che non puoi usare. Perché succede e come ripararlo è trattato in perché una risposta AI si interrompe a metà frase e la correzione di finish_reason "length". Non lo ripeto qui.
La suddivisione che funziona è semplice:
- il prompt decide quanto è lunga una buona risposta;
max_tokenssta un po' sopra la risposta buona più lunga, così una risposta fuori controllo viene tagliata invece di crescere fino al limite di output del modello (fino a 32.768 token su DeepSeek-V4-Flash).
Per la risposta ticket su due righe, 150 è abbondante. Per un'etichetta di una parola, 20.
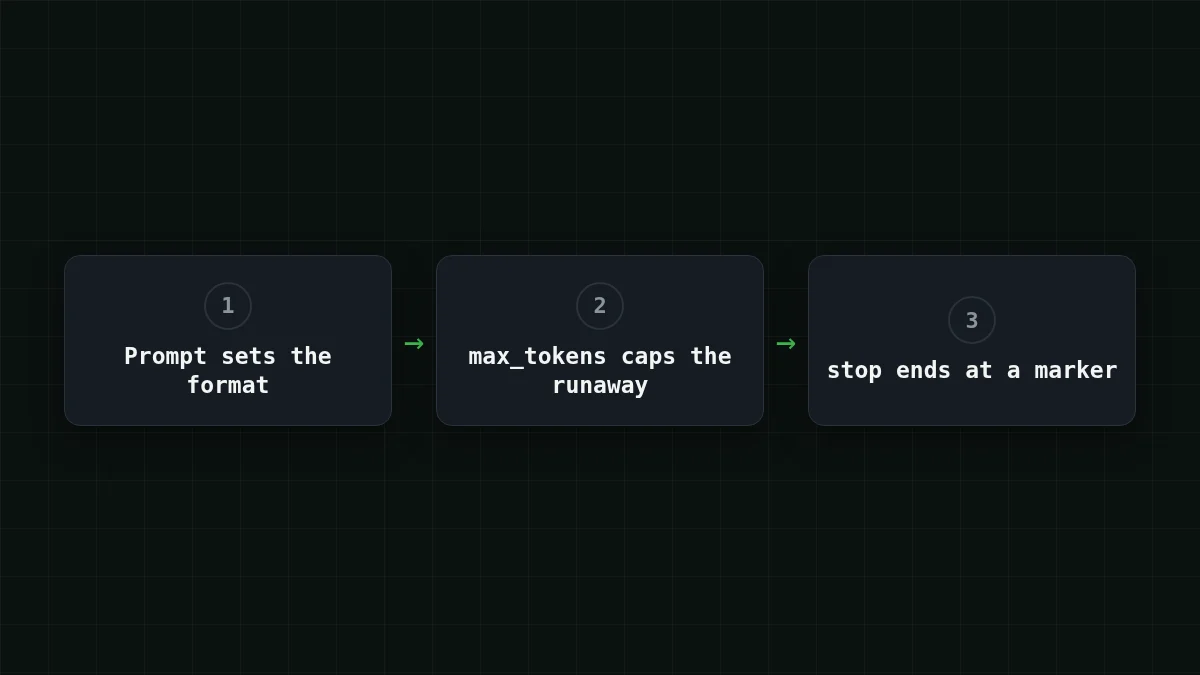
Le sequenze di stop terminano una risposta a un marcatore#
Nella documentazione di DeepSeek, stop accetta fino a 16 sequenze, e la generazione si ferma quando il modello starebbe per produrne una. Quando succede, finish_reason è stop, come per una fine naturale. È comodo quando il tuo formato ha un marcatore di fine. Chiedi la risposta, poi una riga con END, e metti END in stop. Provalo una volta sulla tua configurazione: fai una chiamata e verifica che finish_reason sia stop e che il testo finisca prima del marcatore.
Una regola: il testo di stop deve essere qualcosa che non può comparire dentro una buona risposta. Uno stop su \n\n taglia una risposta di due paragrafi dopo il primo paragrafo.
Una richiesta che puoi eseguire e misurare#
Ecco la chiamata ticket delimitata. L'id del modello è il gateway_id completo dalla documentazione di CheapTokens, e l'URL di base è https:/. La documentazione mostra come creare una chiave; mettila in una variabile d'ambiente.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
Nella risposta contano due cose: choices[0]. e l'oggetto usage con prompt_tokens e completion_. In Python con il pacchetto openai appare così:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Eseguilo su dieci ticket reali prima di fidarti del formato. Se completion_ resta piccolo e finish_reason è sempre stop, è il prompt che fa il lavoro. Se vedi length, il tuo limite è sotto ciò che serve a una buona risposta: alzalo o stringi il prompt, non entrambi alla cieca.
Abbina le coppie
Cosa ti dicono i campi
Tocca un elemento a sinistra, poi il suo abbinamento
- lengthÈ stato raggiunto il limite max_tokens
- stopUn punto di stop naturale o una sequenza di stop
- usage.completion_tokensI token nella risposta, il lato output della tua bolletta
Se finish_reason non è stop, guarda prima il limite.
Quanto risparmia su 1.000 richieste#
Ora la bolletta. Supponi che un ticket più le istruzioni siano 300 token di input, la risposta aperta sia 400 token di output e quella delimitata 100. Sono ipotesi per l'esempio; sostituiscile con i numeri del tuo usage. Su 1.000 richieste, sono 300 × 1.000 = 300.000 token di input in entrambi i casi, e 400 × 1.000 = 400.000 token di output contro 100 × 1.000 = 100.000.
Risposte aperte, 1.000 richieste:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 token di input e 400 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Risposte delimitate, 1.000 richieste:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 token di input e 100 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Il lato input non si muove, e questo è il punto: solo la parte che hai accorciato diventa più economica, ed è la parte con il prezzo più alto. Per modello, gli stessi 1.000 ticket costano $0.0445 in modalità aperta e $0.0145 in modalità delimitata su DeepSeek-V4-Flash. In totale, contando insieme input e output, tutti e tre i modelli nelle tabelle risultano più economici del prezzo di riferimento di OpenRouter. Per risposte brevi, scegli il modello dalle tabelle sopra: confronta le righe per il tuo input e output. GLM-5.3-Flash ($0.04 per 1M token di output) si adatta dove le risposte restano più lunghe, fino a 8.192 token; la pagina DeepSeek ha il resto.
L'ordine in cui applicherei tutto questo#
Metti in ordine
Metti i passaggi in un ordine sensato
Trascina gli elementi o usa le frecce
- Scrivi il formato della risposta nel prompt
- Imposta max_tokens un po' sopra la risposta buona più lunga
- Se l'API accetta stop e il formato ha un marcatore di fine, aggiungi una sequenza di stop
- Registra completion_tokens e finish_reason per ogni chiamata
- Confronta il costo di un batch di 1.000 richieste prima e dopo
Il passaggio 4 è quello che la gente salta. Senza di esso non sai se la modifica al prompt ha funzionato o se alcune risposte lunghe stanno alzando la media. Se già tieni traccia della spesa, l'approccio al conteggio dei token in Python e input vs output token sono un buon punto da cui continuare.


