Réduire les tokens de sortie : longueur des réponses, max_tokens, séquences d'arrêt
Raccourcissez les réponses IA par conception : demandez un format borné, gardez max_tokens comme plafond, utilisez des séquences d'arrêt, puis voyez le coût de 1 000 requêtes.
Sur cette page
Votre bot répond en 400 tokens quand 100 suffiraient, et vous payez chacun d'eux. Le correctif se trouve surtout dans le prompt : demandez un format borné, gardez max_tokens comme plafond de sécurité plutôt que comme réglage de longueur, et vérifiez usage. pour voir ce qui est réellement revenu.
Cela compte parce que la sortie est le côté le plus cher sur chaque modèle que nous proposons : consultez les prix en direct sur la page de tarifs. Même question, réponse plus courte, facture plus légère.
Commencez par le prompt, pas par la limite#
Supposez un bot de support qui traite 2 000 tickets par jour. Chaque ticket a besoin d'une catégorie et d'une phrase de justification. Le modèle, livré à lui-même, écrit un paragraphe aimable, une liste de réserves et une proposition d'aide supplémentaire. C'est là que partent les 400 tokens.
Comparer
Même ticket, deux prompts
Ouvert
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: un paragraphe avec une salutation, une explication et une proposition d'aide (environ 400 tokens).
Borné
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: le même ticket.
Answer: billing et une courte justification (environ 100 tokens ou moins).
L'astuce, c'est de décrire la forme de la réponse : nombre de lignes, liste fermée de libellés, limite de mots. « Sois bref » marche moins bien que « deux lignes, 15 mots », parce que le modèle a quelque chose de concret à compter. Si vous n'avez besoin que d'un libellé, demandez le libellé et rien d'autre. Un classifieur qui doit renvoyer billing ne devrait pas être autorisé à se justifier.
Il en va de même pour l'extraction JSON. Quand le modèle enveloppe votre JSON dans de la prose, cette prose est une sortie que vous payez puis jetez. Mettez « Return only the JSON object, no text before or after it » dans le message système. Pour parser ce qui revient, voir comment extraire du JSON d'une réponse LLM.
max_tokens est une ceinture de sécurité#
Il est tentant de régler max_tokens: 100 et de considérer que c'est fait. N'attendez pas de réponses courtes pour autant. La référence API de DeepSeek (vérifiée le 2 novembre 2026) décrit max_tokens comme le nombre maximal de tokens pouvant être générés dans la complétion, l'entrée plus la sortie étant plafonnées par la longueur de contexte du modèle. Cela arrête la génération. Cela ne pousse pas le modèle à planifier une réponse plus courte.
Ainsi, un modèle qui voulait écrire 400 tokens et qui en reçoit 100 vous livre une phrase qui se termine au milieu, finish_reason réglé sur length, et une facture pour les 100 tokens. Vous avez payé pour une réponse inutilisable. Les raisons de ce phénomène et la façon de le réparer sont traitées dans pourquoi une réponse IA s'arrête en milieu de phrase et le correctif de finish_reason « length ». Je ne les répète pas ici.
La répartition qui fonctionne est simple :
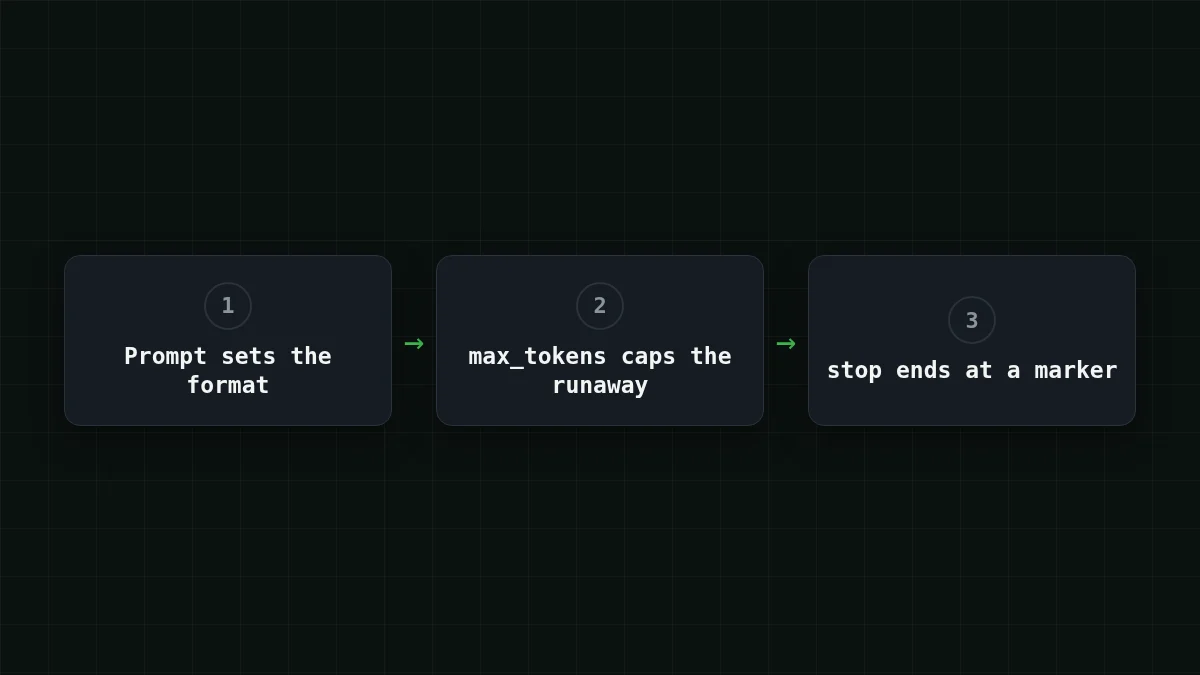
- le prompt décide de la longueur d'une bonne réponse ;
max_tokensse place un peu au-dessus de la plus longue bonne réponse, pour qu'une réponse emballée soit coupée au lieu de croître jusqu'à la limite de sortie du modèle (jusqu'à 32 768 tokens sur DeepSeek-V4-Flash).
Pour la réponse de ticket en deux lignes, 150 suffit largement. Pour un libellé d'un mot, 20.
Les séquences d'arrêt terminent une réponse sur un marqueur#
Dans la référence de DeepSeek, stop accepte jusqu'à 16 séquences, et la génération s'arrête quand le modèle produirait l'une d'elles. Quand cela arrive, finish_reason vaut stop, comme pour une fin naturelle. C'est pratique quand votre format a un marqueur de fin. Demandez la réponse, puis une ligne avec END, et mettez END dans stop. Testez-le une fois sur votre propre configuration : faites un appel et vérifiez que finish_reason vaut stop et que le texte se termine avant le marqueur.
Une règle : le texte d'arrêt doit être quelque chose qui ne peut pas apparaître dans une bonne réponse. Un stop sur \n\n coupe une réponse de deux paragraphes après le premier.
Une requête que vous pouvez exécuter et mesurer#
Voici l'appel de ticket borné. L'id du modèle est le gateway_id complet de la doc CheapTokens, et l'URL de base est https:/. La doc montre comment créer une clé ; mettez-la dans une variable d'environnement.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
Dans la réponse, deux choses comptent : choices[0]. et l'objet usage avec prompt_tokens et completion_. En Python avec le paquet openai, cela ressemble à ceci :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Exécutez-le sur dix tickets réels avant de faire confiance au format. Si completion_ reste petit et que finish_reason vaut toujours stop, c'est le prompt qui fait le travail. Si vous voyez length, votre plafond est en dessous de ce qu'exige une bonne réponse : augmentez-le ou resserrez le prompt, pas les deux à l'aveugle.
Associer les paires
Ce que les champs vous disent
Touchez un élément à gauche, puis sa paire
- lengthLa limite max_tokens a été atteinte
- stopUn point d'arrêt naturel ou une séquence d'arrêt
- usage.completion_tokensLes tokens de la réponse, le côté sortie de votre facture
Si finish_reason ne vaut pas stop, regardez d'abord la limite.
Ce que cela économise sur 1 000 requêtes#
Passons à la facture. Supposez qu'un ticket plus les instructions fasse 300 tokens d'entrée, que la réponse ouverte fasse 400 tokens de sortie et la réponse bornée 100. Ce sont des hypothèses pour l'exemple ; remplacez-les par les chiffres de votre propre usage. Sur 1 000 requêtes, cela fait 300 × 1 000 = 300 000 tokens d'entrée dans les deux cas, et 400 × 1 000 = 400 000 tokens de sortie contre 100 × 1 000 = 100 000.
Réponses ouvertes, 1 000 requêtes :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 tokens d'entrée et 400 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Réponses bornées, 1 000 requêtes :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 tokens d'entrée et 100 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Le côté entrée ne bouge pas, et c'est tout l'intérêt : seule la partie que vous avez raccourcie devient moins chère, et c'est celle au prix le plus élevé. Par modèle, les mêmes 1 000 tickets coûtent $0.0445 en ouvert et $0.0145 en borné sur DeepSeek-V4-Flash. Au total, entrée et sortie comptées ensemble, les trois modèles des tableaux reviennent moins cher que le prix de référence d'OpenRouter. Pour les réponses courtes, choisissez le modèle dans les tableaux ci-dessus : comparez les lignes pour votre propre entrée et sortie. GLM-5.3-Flash ($0.04 par 1M de tokens de sortie) convient là où les réponses restent plus longues, jusqu'à 8 192 tokens ; la page DeepSeek contient le reste.
L'ordre dans lequel j'appliquerais cela#
Remettre en ordre
Mettez les étapes dans un ordre sensé
Faites glisser les éléments ou utilisez les flèches
- Écrire le format de réponse dans le prompt
- Régler max_tokens un peu au-dessus de la plus longue bonne réponse
- Si l'API accepte stop et que le format a un marqueur de fin, ajouter une séquence d'arrêt
- Journaliser completion_tokens et finish_reason pour chaque appel
- Comparer le coût d'un lot de 1 000 requêtes avant et après
L'étape 4 est celle que les gens sautent. Sans elle, vous ne savez pas si le changement de prompt a marché ou si quelques réponses longues tirent la moyenne vers le haut. Si vous suivez déjà vos dépenses, l'approche de comptage de tokens en Python et tokens d'entrée vs de sortie sont un bon point de départ pour continuer.


