成本优化指南
削减输出 token:答案长度、max_tokens、停止序列
通过设计缩短 AI 答案:要求有边界的格式,把 max_tokens 当作上限,使用停止序列,然后看看 1,000 次请求的成本。
你的机器人本可以用 100 个 token 回答,却用了 400 个,而每一个你都要付费。解决办法主要在于提示词:要求一个有边界的格式,把 max_tokens 当作安全上限而不是长度旋钮,并检查 usage. 看看实际返回了什么。
这一点很重要,因为在我们提供的每个模型上,输出都是更贵的一侧:请查看定价页面上的实时价格。同样的问题,更短的答案,更小的账单。
从提示词开始,而不是从限制开始#
假设你运营一个每天处理 2,000 张工单的支持机器人。每张工单需要一个类别和一句理由。如果放任不管,模型会写一段友好的话、一串注意事项,还主动提出进一步帮助。400 个 token 就是这么花掉的。
比较
同一张工单,两种提示词
开放式
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: 一段包含问候、解释和主动提供帮助的话(约 400 个 token)。
有边界
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: 同一张工单。
Answer: billing 和一句简短理由(约 100 个 token 或更少)。
诀窍在于你描述答案的形状:行数、封闭的标签列表、字数限制。“简短一点”不如“两行,15 个词”有效,因为模型有具体的东西可以数。如果你只需要一个标签,就只要标签,别的都不要。一个必须返回 billing 的分类器不应该被允许解释自己。
JSON 提取也是同样的道理。当模型把你的 JSON 包在散文里时,这些散文是你付费输出然后又丢弃的东西。在系统消息中写上“Return only the JSON object, no text before or after it”。关于如何解析返回的内容,请参阅如何从 LLM 回复中提取 JSON。
max_tokens 是安全带#
很容易设置 max_tokens: 100 然后以为万事大吉。别指望它能带来简短答案。DeepSeek 的 API 参考(2026 年 11 月 2 日查阅)将 max_tokens 描述为补全中可以生成的最大 token 数,输入加输出受模型上下文长度限制。它会停止生成。它不会让模型去规划一个更短的答案。
所以,一个本想写 400 个 token 的模型被限制到 100 时,会给你一句中途结束的话,finish_reason 被设为 length,而账单仍然是全部 100 个 token。你为一个无法使用的答案付了钱。为什么会这样以及如何修复,已在为什么 AI 回答会在句子中间停止和finish_reason "length" 的修复中讲过。这里不再重复。
有效的分工很简单:
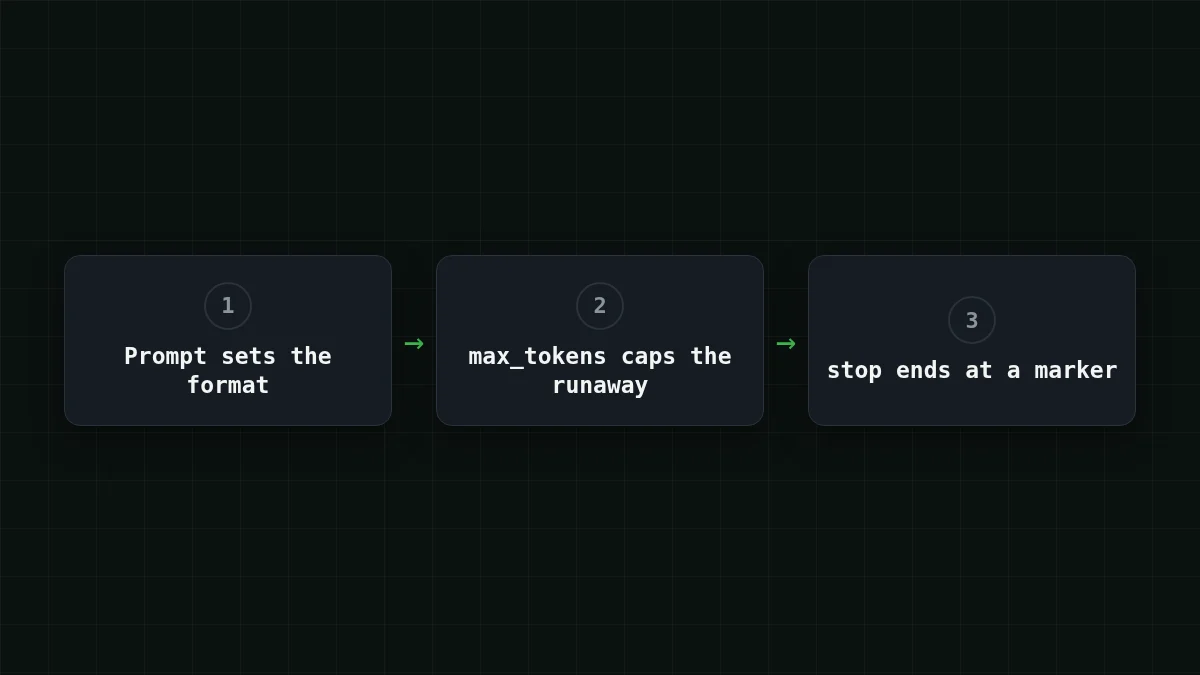
- 提示词决定一个好答案有多长;
max_tokens设在最长好答案稍高一点的位置,这样失控的回复会被截断,而不是增长到模型的输出上限(DeepSeek-V4-Flash 上最高 32,768 个 token)。
对于两行的工单答案,150 足够了。对于一个单词的标签,20。
停止序列在标记处结束答案#
在 DeepSeek 的参考中,stop 最多接受 16 个序列,当模型将要生成其中一个时,生成就会停止。此时 finish_reason 为 stop,与自然结束相同。当你的格式有结束标记时,这很方便。要求给出答案,然后是一行 END,并把 END 放进 stop。在你自己的环境上测试一次:发起一次调用,检查 finish_reason 是否为 stop,以及文本是否在标记之前结束。
一条规则:停止文本必须是绝不会出现在好答案内部的内容。用 \n\n 作为停止符会把两段式的答案在第一段之后就截断。
一个可以运行并测量的请求#
下面是有边界的工单调用。模型 id 是 CheapTokens 文档中的完整 gateway_id,基础 URL 是 https:/。文档展示了如何创建密钥;把它放进环境变量。
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
}'在响应中,有两件事重要:choices[0]. 和包含 prompt_tokens 与 completion_ 的 usage 对象。在 Python 中使用 openai 包,看起来是这样的:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
在信任这个格式之前,先在十张真实工单上运行它。如果 completion_ 保持很小,且 finish_reason 始终是 stop,说明提示词起了作用。如果你看到 length,说明你的上限低于好答案所需:提高它或收紧提示词,不要盲目地两者都做。
配对
这些字段告诉你什么
点击左侧项目,然后点击其配对项
- length达到了 max_tokens 限制
- stop自然停止点或停止序列
- usage.completion_tokens答案中的 token 数,即你账单的输出侧
如果 finish_reason 不是 stop,先检查限制。
在 1,000 次请求上能省多少#
现在算账单。假设一张工单加指令是 300 个输入 token,开放式答案是 400 个输出 token,有边界的是 100 个。这些是示例的假设;请换成你自己 usage 中的数字。在 1,000 次请求中,两种情况都是 300 × 1,000 = 300,000 个输入 token,而输出 token 是 400 × 1,000 = 400,000 对 100 × 1,000 = 100,000。
开放式答案,1,000 次请求:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
每次请求 300 个输入 token 和 400 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
有边界答案,1,000 次请求:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
每次请求 300 个输入 token 和 100 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
输入侧没有变化,而这正是重点:只有你缩短的那部分变便宜了,而它正是价格更高的那部分。按模型计算,同样的 1,000 张工单在 DeepSeek-V4-Flash 上开放式花费 $0.0445,有边界花费 $0.0145。总计,把输入和输出加在一起,表格中的三个模型都比 OpenRouter 的参考价格便宜。对于短答案,从上面的表格中选择模型:针对你自己的输入和输出比较各行。GLM-5.3-Flash(每 1M 输出 token $0.04)适合答案较长的情况,最高 8,192 个 token;DeepSeek 页面有其余内容。
我会按这个顺序应用#
排序
把步骤按合理的顺序排列
拖动项目或使用箭头
- 把答案格式写进提示词
- 将 max_tokens 设在最长好答案稍高一点的位置
- 如果 API 接受 stop 且格式有结束标记,添加停止序列
- 为每次调用记录 completion_tokens 和 finish_reason
- 比较 1,000 次请求批次前后的成本
第 4 步是人们会跳过的。没有它,你就不知道提示词改动是否奏效,或者是不是几个长答案把平均值拉高了。如果你已经在跟踪支出,Python 中的 token 计数方法和输入与输出 token是继续深入的好地方。


