لاگت کی بہتریگائیڈ
آؤٹ پٹ ٹوکنز کم کریں: جواب کی لمبائی، max_tokens، اسٹاپ سیکوئنسز
AI جوابات کو ڈیزائن سے مختصر کریں: محدود فارمیٹ طلب کریں، max_tokens کو حد کے طور پر رکھیں، اسٹاپ سیکوئنسز استعمال کریں، پھر 1,000 درخواستوں کی لاگت دیکھیں۔
اس صفحہ پر
آپ کا بوٹ 400 ٹوکنز میں جواب دیتا ہے جبکہ 100 کافی ہوتے، اور آپ ان میں سے ہر ایک کی قیمت ادا کرتے ہیں۔ اس کا حل زیادہ تر پرامپٹ میں ہے: ایک محدود فارمیٹ طلب کریں، max_tokens کو لمبائی کنٹرول کرنے کے بجائے حفاظتی حد کے طور پر رکھیں، اور یہ دیکھنے کے لیے usage. چیک کریں کہ اصل میں کیا واپس آیا۔
یہ اہم ہے کیونکہ آؤٹ پٹ ہر ماڈل پر مہنگی طرف ہے جو ہم پیش کرتے ہیں: قیمتوں کے صفحے پر لائیو قیمتیں دیکھیں۔ وہی سوال، مختصر جواب، کم بل۔
حد سے نہیں، پرامپٹ سے شروع کریں#
فرض کریں آپ روزانہ 2,000 ٹکٹوں والا سپورٹ بوٹ چلاتے ہیں۔ ہر ٹکٹ کو ایک زمرہ اور وجہ کا ایک جملہ درکار ہے۔ ماڈل، اپنی حالت میں، ایک دوستانہ پیراگراف، انتباہات کی فہرست اور مزید مدد کی پیشکش لکھتا ہے۔ یہیں 400 ٹوکنز جاتے ہیں۔
موازنہ کریں
وہی ٹکٹ، دو پرامپٹس
کھلا
سسٹم: آپ ایک مددگار سپورٹ اسسٹنٹ ہیں۔ صارف: مجھے بتائیں یہ کس قسم کا ٹکٹ ہے: "میرے کارڈ سے آرڈر 1182 کے لیے دو بار چارج لیا گیا۔" جواب: سلام، وضاحت اور مدد کی پیشکش والا ایک پیراگراف (تقریباً 400 ٹوکنز)۔
محدود
سسٹم: بالکل دو لائنیں جواب دیں۔ لائن 1: زمرہ، بلنگ، بگ، دیگر میں سے ایک۔ لائن 2: زیادہ سے زیادہ 15 الفاظ میں وجہ۔ کوئی سلام نہیں۔
صارف: وہی ٹکٹ۔
جواب: billing اور ایک مختصر وجہ (تقریباً 100 ٹوکنز یا کم)۔
چال یہ ہے کہ آپ جواب کی شکل بیان کریں: لائنوں کی تعداد، لیبلز کی بند فہرست، الفاظ کی حد۔ "مختصر رہیں" سے "دو لائنیں، 15 الفاظ" بہتر کام کرتا ہے، کیونکہ ماڈل کے پاس گننے کے لیے کچھ ٹھوس ہوتا ہے۔ اگر آپ کو صرف ایک لیبل چاہیے، تو لیبل طلب کریں اور کچھ نہیں۔ ایک کلاسیفائر جسے billing واپس کرنا ہے اسے خود کی وضاحت کی اجازت نہیں ہونی چاہیے۔
یہی بات JSON نکالنے پر بھی لاگو ہوتی ہے۔ جب ماڈل آپ کے JSON کو نثر میں لپیٹ دیتا ہے، تو وہ نثر آؤٹ پٹ ہے جس کی آپ قیمت ادا کرتے ہیں اور پھر پھینک دیتے ہیں۔ سسٹم پیغام میں "صرف JSON آبجیکٹ واپس کریں، اس سے پہلے یا بعد میں کوئی متن نہیں" رکھیں۔ جو واپس آئے اسے پارس کرنے کے لیے، LLM کے جواب سے JSON کیسے نکالیں دیکھیں۔
max_tokens ایک سیٹ بیلٹ ہے#
max_tokens: 100 سیٹ کر کے اسے مکمل سمجھنا پرکشش ہے۔ اس سے مختصر جوابات کی توقع نہ رکھیں۔ DeepSeek کی API ریفرنس (2 نومبر 2026 کو چیک کی گئی) max_tokens کو کمپلیشن میں پیدا ہو سکنے والے ٹوکنز کی زیادہ سے زیادہ تعداد کے طور پر بیان کرتی ہے، جس میں ان پٹ اور آؤٹ پٹ ماڈل کی کانٹیکسٹ لمبائی سے محدود ہوتے ہیں۔ یہ جنریشن روک دیتا ہے۔ یہ ماڈل کو مختصر جواب کی منصوبہ بندی نہیں کرواتا۔
تو ایک ماڈل جس نے 400 ٹوکنز لکھنے کا ارادہ کیا اور اسے 100 ملے، آپ کو ایک جملہ دیتا ہے جو درمیان میں ختم ہو جاتا ہے، finish_reason length پر سیٹ، اور تمام 100 ٹوکنز کا بل۔ آپ نے ایسے جواب کی قیمت ادا کی جو آپ استعمال نہیں کر سکتے۔ ایسا کیوں ہوتا ہے اور اسے کیسے ٹھیک کریں، یہ AI کا جواب درمیان میں کیوں رک جاتا ہے اور finish_reason "length" کا حل میں بتایا گیا ہے۔ میں یہاں دہراؤں گا نہیں۔
کام کرنے والی تقسیم سادہ ہے:
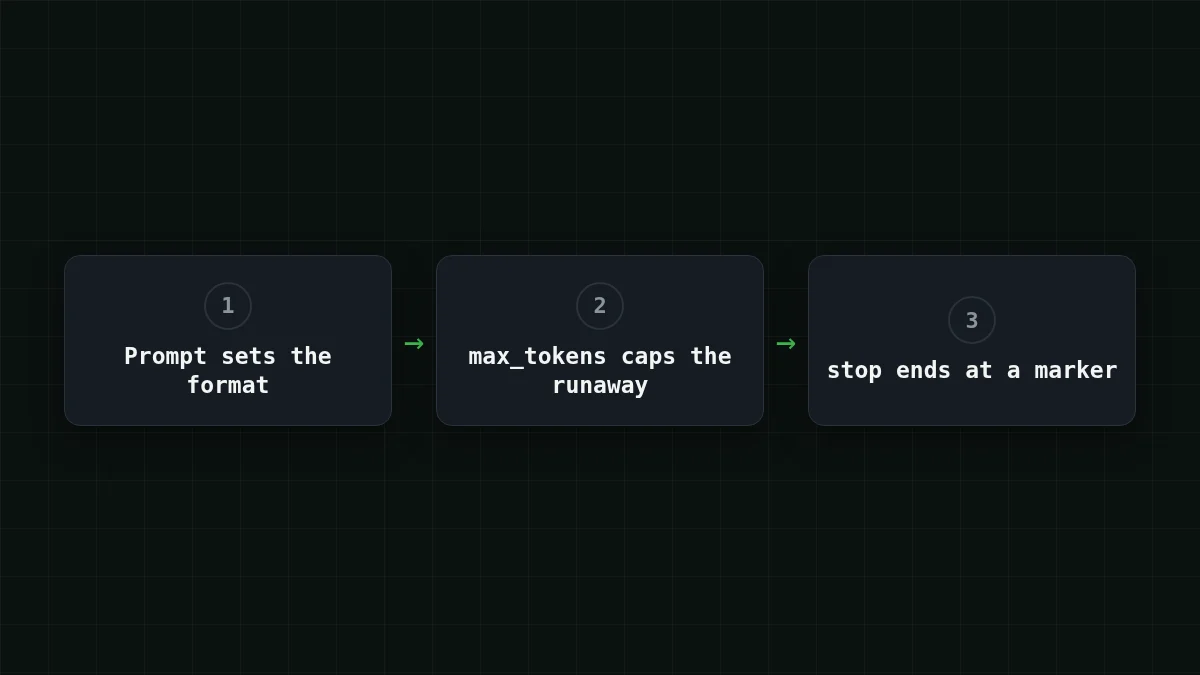
- پرامپٹ فیصلہ کرتا ہے کہ اچھا جواب کتنا لمبا ہے؛
max_tokensسب سے لمبے اچھے جواب سے تھوڑا اوپر ہوتا ہے، تاکہ بے قابو جواب کٹ جائے بجائے ماڈل کی آؤٹ پٹ حد (DeepSeek-V4-Flash پر 32,768 ٹوکنز تک) تک بڑھنے کے۔
دو لائنوں والے ٹکٹ جواب کے لیے، 150 کافی ہے۔ ایک لفظ کے لیبل کے لیے، 20۔
اسٹاپ سیکوئنسز جواب کو مارکر پر ختم کرتے ہیں#
DeepSeek کی ریفرنس میں، stop زیادہ سے زیادہ 16 سیکوئنسز لیتا ہے، اور جنریشن اس وقت رک جاتی ہے جب ماڈل کوئی ایک پیدا کرنے والا ہو۔ ایسا ہونے پر، finish_reason stop ہوتا ہے، بالکل قدرتی اختتام کی طرح۔ یہ اس وقت کارآمد ہے جب آپ کے فارمیٹ میں اختتامی مارکر ہو۔ جواب طلب کریں، پھر END والی ایک لائن، اور END کو stop میں رکھیں۔ اپنی سیٹ اپ پر ایک بار آزمائیں: ایک کال کریں اور چیک کریں کہ finish_reason stop ہے اور متن مارکر سے پہلے ختم ہوتا ہے۔
ایک اصول: اسٹاپ متن ایسا ہونا چاہیے جو اچھے جواب کے اندر نہ آ سکے۔ \n\n پر اسٹاپ دو پیراگراف والے جواب کو پہلے پیراگراف کے بعد کاٹ دیتا ہے۔
ایک درخواست جو آپ چلا اور ناپ سکتے ہیں#
یہاں محدود ٹکٹ کال ہے۔ ماڈل آئی ڈی CheapTokens ڈاکس سے مکمل gateway_id ہے، اور بیس URL https:/ ہے۔ ڈاکس دکھاتے ہیں کہ کلید کیسے بنائیں؛ اسے ایک ماحول متغیر میں رکھیں۔
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
جواب میں، دو چیزیں اہم ہیں: choices[0]. اور usage آبجیکٹ جس میں prompt_tokens اور completion_ ہیں۔ Python میں openai پیکیج کے ساتھ یہ ایسا لگتا ہے:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
فارمیٹ پر بھروسہ کرنے سے پہلے اسے دس حقیقی ٹکٹوں پر چلائیں۔ اگر completion_ چھوٹا رہتا ہے اور finish_reason ہمیشہ stop ہوتا ہے، تو پرامپٹ کام کر رہا ہے۔ اگر آپ کو length نظر آئے، تو آپ کی حد اچھے جواب کی ضرورت سے کم ہے: اسے بڑھائیں یا پرامپٹ سخت کریں، دونوں کو اندھا دھند نہیں۔
جوڑے ملائیں
فیلڈز آپ کو کیا بتاتی ہیں
بائیں طرف کسی آئٹم پر ٹیپ کریں، پھر اس کا جوڑا
- lengthmax_tokens حد تک پہنچ گئی
- stopایک قدرتی اسٹاپ پوائنٹ یا اسٹاپ سیکوئنس
- usage.completion_tokensجواب میں ٹوکنز، آپ کے بل کا آؤٹ پٹ حصہ
اگر finish_reason stop نہیں ہے، تو پہلے حد دیکھیں۔
1,000 درخواستوں پر کیا بچتا ہے#
اب بل۔ فرض کریں ٹکٹ اور ہدایات مل کر 300 ان پٹ ٹوکنز ہیں، کھلا جواب 400 آؤٹ پٹ ٹوکنز اور محدود 100۔ یہ مثال کے لیے مفروضے ہیں؛ اپنے usage کے نمبر ڈالیں۔ 1,000 درخواستوں پر، یہ دونوں صورتوں میں 300 × 1,000 = 300,000 ان پٹ ٹوکنز، اور 400 × 1,000 = 400,000 آؤٹ پٹ ٹوکنز بمقابلہ 100 × 1,000 = 100,000 ہیں۔
کھلے جوابات، 1,000 درخواستیں:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 1,000 درخواستیں | OpenRouter، 1,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
فی درخواست 300 ان پٹ اور 400 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
محدود جوابات، 1,000 درخواستیں:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 1,000 درخواستیں | OpenRouter، 1,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
فی درخواست 300 ان پٹ اور 100 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
ان پٹ طرف نہیں ہلتا، اور یہی بات ہے: صرف وہ حصہ سستا ہوتا ہے جو آپ نے مختصر کیا، اور وہی حصہ زیادہ قیمت والا ہے۔ فی ماڈل، وہی 1,000 ٹکٹ DeepSeek-V4-Flash پر کھلے $0.0445 اور محدود $0.0145 کے ہیں۔ مجموعی طور پر، ان پٹ اور آؤٹ پٹ ملا کر، جدولوں کے تینوں ماڈل OpenRouter کی حوالہ قیمت سے سستے نکلتے ہیں۔ مختصر جوابات کے لیے، اوپر کے جدولوں سے ماڈل منتخب کریں: اپنے ان پٹ اور آؤٹ پٹ کی قطاریں موازنہ کریں۔ GLM-5.3-Flash ($0.04 فی 1M آؤٹ پٹ ٹوکنز) وہاں فٹ ہے جہاں جوابات لمبے رہتے ہیں، 8,192 ٹوکنز تک؛ باقی DeepSeek صفحہ پر ہے۔
میں اسے جس ترتیب سے لاگو کروں گا#
ترتیب دیں
مراحل کو معقول ترتیب میں رکھیں
آئٹمز کو گھسیٹیں یا تیروں کا استعمال کریں
- جواب کا فارمیٹ پرامپٹ میں لکھیں
- max_tokens کو سب سے لمبے اچھے جواب سے تھوڑا اوپر سیٹ کریں
- اگر API stop قبول کرتا ہے اور فارمیٹ میں اختتامی مارکر ہے، تو اسٹاپ سیکوئنس شامل کریں
- ہر کال کے لیے completion_tokens اور finish_reason لاگ کریں
- 1,000 درخواستوں کے بیچ کی لاگت پہلے اور بعد میں موازنہ کریں
مرحلہ 4 وہ ہے جو لوگ چھوڑ دیتے ہیں۔ اس کے بغیر آپ نہیں جان سکتے کہ پرامپٹ کی تبدیلی کام کر گئی یا چند لمبے جوابات اوسط کو اوپر کھینچ رہے ہیں۔ اگر آپ پہلے سے خرچ ٹریک کرتے ہیں، تو Python میں ٹوکن گننے کا طریقہ اور ان پٹ بمقابلہ آؤٹ پٹ ٹوکنز جاری رکھنے کے لیے اچھی جگہ ہیں۔


