Bawasan ang output tokens: haba ng sagot, max_tokens, stop sequences
Paikliin ang mga sagot ng AI sa pamamagitan ng disenyo: humingi ng limitadong format, panatilihin ang max_tokens bilang cap, gumamit ng stop sequences, pagkatapos tingnan ang gastos ng 1,000 request.
Sa pahinang ito
Sumasagot ang bot mo ng 400 token kapag sapat na ang 100, at binabayaran mo ang bawat isa sa kanila. Nasa prompt halos lahat ng solusyon: humingi ng limitadong format, panatilihin ang max_tokens bilang safety cap sa halip na pang-adjust ng haba, at tingnan ang usage. para malaman kung ano talaga ang bumalik.
Mahalaga ito dahil ang output ang mas mahal na bahagi sa bawat model na inaalok namin: tingnan ang live na presyo sa pricing page. Parehong tanong, mas maikling sagot, mas maliit na bill.
Simulan sa prompt, hindi sa limit#
Sabihin nating may support bot ka na humahawak ng 2,000 ticket kada araw. Bawat ticket ay kailangan ng kategorya at isang pangungusap na dahilan. Kung hahayaan lang, magsusulat ang model ng magiliw na talata, listahan ng mga caveat at alok na tumulong pa. Doon napupunta ang 400 token.
Ihambing
Parehong ticket, dalawang prompt
Open-ended
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: isang talata na may pagbati, paliwanag at alok na tumulong (mga 400 token).
Bounded
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: ang parehong ticket.
Answer: billing at isang maikling dahilan (mga 100 token o mas kaunti).
Ang sikreto ay inilalarawan mo ang hugis ng sagot: bilang ng linya, saradong listahan ng label, limitasyon sa salita. Mas mahina ang "Be brief" kaysa sa "two lines, 15 words", dahil may konkretong mabibilang ang model. Kung label lang ang kailangan mo, humingi ng label at wala nang iba. Ang classifier na dapat magbalik ng billing ay hindi dapat payagang magpaliwanag ng sarili.
Ganoon din sa JSON extraction. Kapag binalot ng model ang JSON mo sa prosa, ang prosa ay output na binabayaran mo at itinatapon mo lang. Ilagay ang "Return only the JSON object, no text before or after it" sa system message. Para sa pag-parse ng bumabalik, tingnan ang how to extract JSON from an LLM reply.
Ang max_tokens ay seatbelt#
Nakakatuksong i-set ang max_tokens: 100 at isipin na tapos na. Huwag asahan na magbibigay ito ng maiikling sagot. Inilalarawan ng API reference ng DeepSeek (sinuri noong 2 Nobyembre 2026) ang max_tokens bilang maximum na bilang ng token na maaaring i-generate sa completion, na ang input at output ay nililimitahan ng context length ng model. Pinipigilan nito ang generation. Hindi nito pinapagplanong magbigay ng mas maikling sagot ang model.
Kaya ang model na gustong magsulat ng 400 token at nakatanggap ng 100 ay magbibigay sa iyo ng pangungusap na putol sa gitna, finish_reason na nakatakda sa length, at bill para sa lahat ng 100 token. Nagbayad ka para sa sagot na hindi mo magagamit. Kung bakit nangyayari ito at paano ayusin ay saklaw ng why an AI answer stops mid-sentence at the finish_reason "length" fix. Hindi ko na uulitin dito.
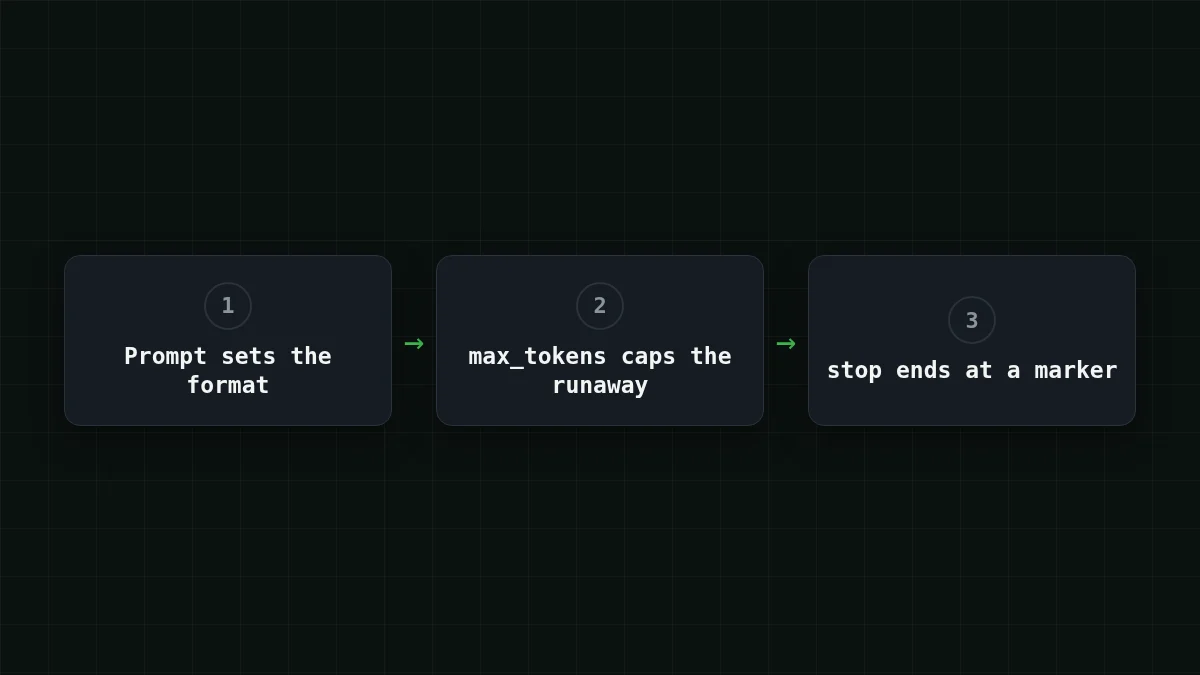
Simple lang ang tamang hati:
- ang prompt ang nagtatakda kung gaano kahaba ang magandang sagot;
- ang
max_tokensay bahagyang mas mataas sa pinakamahabang magandang sagot, para maputol ang runaway na sagot sa halip na lumaki hanggang sa output limit ng model (hanggang 32,768 token sa DeepSeek-V4-Flash).
Para sa two-line na sagot sa ticket, sapat na ang 150. Para sa one-word na label, 20.
Tinatapos ng stop sequences ang sagot sa marker#
Sa reference ng DeepSeek, ang stop ay tumatanggap ng hanggang 16 sequence, at humihinto ang generation kapag malilikha na ito ng model. Kapag nangyari iyon, ang finish_reason ay stop, katulad ng natural na pagtatapos. Kapaki-pakinabang ito kapag may end marker ang format mo. Humingi ng sagot, pagkatapos ay linya na may END, at ilagay ang END sa stop. Subukan ito nang isang beses sa setup mo: gumawa ng isang call at tiyakin na ang finish_reason ay stop at nagtatapos ang teksto bago ang marker.
Isang tuntunin: ang stop text ay dapat hindi maaaring lumitaw sa loob ng magandang sagot. Ang stop sa \n\n ay pumuputol ng two-paragraph na sagot pagkatapos ng unang talata.
Isang request na maaari mong patakbuhin at sukatin#
Narito ang bounded na ticket call. Ang model id ay ang buong gateway_id mula sa CheapTokens docs, at ang base URL ay https:/. Ipinapakita ng docs kung paano gumawa ng key; ilagay ito sa environment variable.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
Sa response, dalawang bagay ang mahalaga: ang choices[0]. at ang usage object na may prompt_tokens at completion_. Sa Python gamit ang openai package, ganito ang hitsura:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Patakbuhin ito sa sampung totoong ticket bago mo pagkatiwalaan ang format. Kung nananatiling maliit ang completion_ at laging stop ang finish_reason, gumagana ang prompt. Kung makita mo ang length, mas mababa ang cap mo sa kailangan ng magandang sagot: taasan ito o higpitan ang prompt, hindi pareho nang walang basehan.
Itugma ang mga pares
Ano ang sinasabi ng mga field
I-tap ang isang item sa kaliwa, pagkatapos ang pares nito
- lengthNaabot ang max_tokens limit
- stopNatural na stop point o stop sequence
- usage.completion_tokensAng mga token sa sagot, ang output side ng bill mo
Kung ang finish_reason ay hindi stop, tingnan muna ang limit.
Ano ang natitipid sa 1,000 request#
Ngayon ang bill. Ipagpalagay na ang ticket kasama ang instructions ay 300 input token, ang open-ended na sagot ay 400 output token at ang bounded ay 100. Mga assumption lang ito para sa halimbawa; palitan ng mga numero mula sa sarili mong usage. Sa 1,000 request, iyon ay 300 × 1,000 = 300,000 input token sa parehong kaso, at 400 × 1,000 = 400,000 output token kumpara sa 100 × 1,000 = 100,000.
Open-ended na sagot, 1,000 request:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 input at 400 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Bounded na sagot, 1,000 request:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 input at 100 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Hindi gumagalaw ang input side, at iyon ang punto: tanging ang bahaging pinaikli mo ang bumaba ang presyo, at iyon ang bahaging mas mataas ang presyo. Bawat model, ang parehong 1,000 ticket ay nagkakahalaga ng $0.0445 open-ended at $0.0145 bounded sa DeepSeek-V4-Flash. Sa kabuuan, kasama ang input at output, lahat ng tatlong model sa mga talahanayan ay mas mura kaysa sa reference price ng OpenRouter. Para sa maiikling sagot, piliin ang model mula sa mga talahanayan sa itaas: ihambing ang mga row para sa sarili mong input at output. Ang GLM-5.3-Flash ($0.04 kada 1M output token) ay bagay kung saan mas mahaba ang sagot, hanggang 8,192 token; nasa DeepSeek page ang iba pa.
Ang order na gagamitin ko#
Ilagay sa tamang pagkakasunod-sunod
Ilagay ang mga hakbang sa tamang order
I-drag ang mga item o gamitin ang mga arrow
- Isulat ang format ng sagot sa prompt
- Itakda ang max_tokens nang bahagyang mas mataas sa pinakamahabang magandang sagot
- Kung tumatanggap ng stop ang API at may end marker ang format, magdagdag ng stop sequence
- I-log ang completion_tokens at finish_reason sa bawat call
- Ihambing ang gastos ng 1,000-request batch bago at pagkatapos
Ang hakbang 4 ang madalas laktawan. Kung wala ito, hindi mo malalaman kung gumana ang pagbabago sa prompt o kung may ilang mahabang sagot na nagpapataas ng average. Kung sinusubaybayan mo na ang gastos, ang token-counting approach in Python at input vs output tokens ay magandang pagpapatuloy.


