PagsisimulaGabay
Unang request sa CheapTokens sa Python gamit ang requests, walang SDK
Isang 20-linyang Python script na may requests lang: isang chat completion, isang timeout, HTTP error handling, at naka-print ang sagot, finish_reason at usage.
Sa pahinang ito
Hindi mo kailangan ang openai package para makipag-usap sa isang OpenAI-compatible API. Isang requests.post call, isang Bearer key at isang JSON body ay sapat na, at makikita mo nang eksakto kung ano ang dumadaan sa wire. Binubuo ng gabay na ito ang script na iyon para sa CheapTokens (https:/) at nagtatapos sa pag-print nito ng sagot, finish_reason at token usage.
Mainam ito kung nasa locked-down na makina ka kung saan requests lang ang naka-install, kung ang isang maliit na cron job ay hindi dapat mag-pull ng SDK, o kung gusto mo lang maunawaan kung ano ang ginagawa ng SDK para sa iyo. Ang first-request guide ay sumasaklaw sa SDK, curl at Node na mga ruta; ito ang plain-Python na paraan.
Ang buong script#
Ilagay muna ang iyong key sa isang environment variable (tingnan ang how to store an API key safely), pagkatapos i-save ito bilang ask.py:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
Patakbuhin ang python ask.py. Ang model id ay ang buong gateway id, deepseek-; kung hindi ka sigurado kung ano ang ilalagay doon, list the models with GET /v1/models. Para subukan ang ibang modelo, palitan ng zai- at wala nang iba pang babaguhin: isang balanse ang sumasaklaw sa lahat ng modelo.
Ano ang ginagawa ng bawat linya#
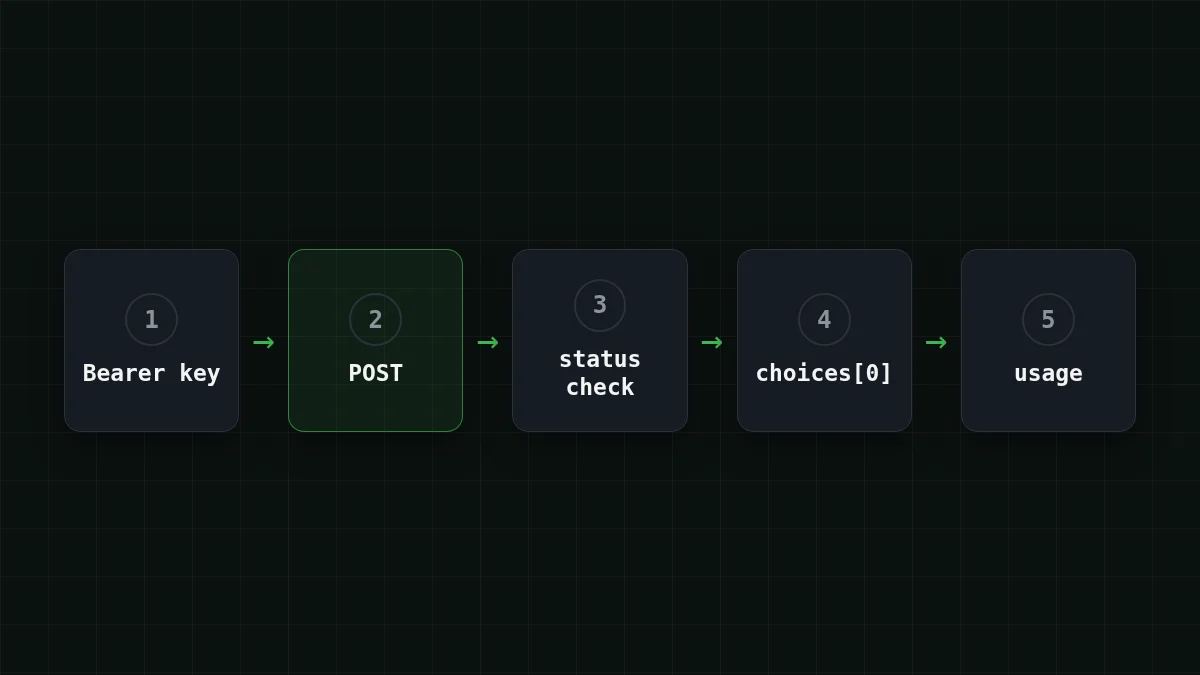
Narito ang limang ideya na sinasandigan ng script. Ang requests Quickstart (living docs, checked 2 November 2026) ay nagpapaliwanag sa karamihan sa kanila, at ang Chat Completions reference mula sa OpenAI ay naglalarawan ng mga field sa reply.
Mga flashcard
Limang bagay sa script
I-tap ang card para i-flip ito
Ang ikatlong bullet ang madalas laktawan ng mga tao. Ang script na hanggang walang hanggan sa isang cron job ay mas malala kaysa sa isang bigong malakas pagkatapos ng 30 segundo.
Basahin ang reply#
Ang matagumpay na response ay JSON. Ang mga bahaging mahalaga sa iyo, ayon sa Chat Completions reference:
choices[0].ang teksto. Maaari itong magingmessage. content null, kaya huwag mag-call ng string methods dito nang walang pag-iingat.- Sinasabi ng
choices[0].kung bakit huminto ang modelo:finish_ reason stop(natapos ito),length(naputol ito ngmax_tokenslimit),tool_calls,content_filter. - Ang
usage.,prompt_ tokens usage.atcompletion_ tokens usage.ang binabayaran mo: input, output, at ang kanilang kabuuan.total_ tokens
Ang reply ay may ganitong hugis (ang mga numero ay placeholder):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}
Subukan mo mismoSubukan ito: itakda ang max_tokens sa 5 at patakbuhin muli ang script. Ano ang sinasabi ng finish_reason?Ipakita ang sagot
Sinasabi nitong length: hininto ng iyong max_tokens limit ang modelo, kaya nagtatapos ang sagot sa gitna ng pangungusap. Itaas ang limit at makakakuha ka muli ng stop. Ang buong kuwento ay nasa AI answer cut off? Fix finish_reason "length".
Kapag hindi ito gumana#
Ginagawang isang linya ng output ng script ang karamihan sa mga pagkabigo. Narito ang karaniwang ibig sabihin ng bawat isa:
Itugma ang mga pares
Itugma ang bawat mensahe sa karaniwang dahilan nito
I-tap ang isang item sa kaliwa, pagkatapos ang pares nito
- HTTP 401Nawawala, mali ang pagkakasulat, o hindi ang tamang key ang ipinadala
- HTTP 404Mali ang URL path o ang model id
- requests.exceptions.TimeoutWalang dumating na bytes sa loob ng timeout
- KeyError: 'CHEAPTOKENS_API_KEY'Hindi naka-set ang environment variable sa terminal na ito
Para sa aktwal na error bodies at step-by-step na pagsusuri ng key, base URL at model id, gamitin ang API 401 or 404 error: wrong key, base URL or model id. Dalawang mas maliit na gotcha: kung makita mo ang KeyError: 'choices', na-parse mo ang isang error body bilang success, ibig sabihin nilaktawan ang raise_. At kung may ~/.netrc file ang makina mo, maaaring gamitin ng requests ang credentials nito sa halip na ang Authorization header na itinakda mo.
Magkano ang isang call#
Sa mga placeholder na numero mula sa reply sa itaas (mga 18 tokens in, 52 out), ang isang call sa DeepSeek-V4-Flash ay nagkakahalaga ng $0.0000055. Iyon ay isang numerong hindi mo mararamdaman, kaya i-scale ito. Sabihin nating ang script mo ay nag-summarize ng 1,000 support tickets bawat araw, mga 800 tokens in at 300 out bawat isa:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 input at 300 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Ang mga presyo ay fixed per model, walang peak hours, kaya ang parehong script ay pareho ang gastos sa 3 a.m. at sa tanghali. Ang kasalukuyang per-model na presyo ay nasa pricing page, at ang docs ay naglilista ng mga endpoint.
Saan pupunta mula rito#
Kapag gumana na ito, ang karaniwang susunod na hakbang ay isang loop sa maraming input, isang retry sa 429 (tingnan ang 429 Too Many Requests: retries with backoff), o ang parehong call na may streaming. Kung ayaw mong pamahalaan ang HTTP nang sarili mo, isang base_url na pagbabago lang ang SDK route.


