API at SDKGabay
Gumawa ng HTML tool mula sa isang prompt gamit ang API (Python)
Isang Python script na nagpapalit ng isang prompt sa gumaganang tool.html, nahuhuli ang putol na sagot sa pamamagitan ng finish_reason, at nagpi-print ng tokens at gastos.
Sa pahinang ito
Makakakuha ka ng gumaganang single-file na tool mula sa isang API call: magpadala ng maayos na nakabalangkas na prompt, tiyakin na ang max_tokens ay sapat na malaki para sa buong pahina, suriin na ang finish_reason ay stop, at i-save ang sagot bilang tool.html. Nasa ibaba ang script na eksaktong gumagawa niyan, at isang prompt template na maaari mong baguhin para sa sarili mong tool.
Simple lang ang ideya, at ipinakita na ito ng DeepSeek. Naglathala ito ng koleksyon ng pitong demo prompt para sa Creator Mode sa DeepSeek Harness (ang pahina, sinuri noong 3 Nobyembre 2026): isang 3D landmark gallery, isang poster workbench, isang video editing workbench, isang paper reader, isang conversation statistics board at ilan pa. Ang Creator Mode ay nasa loob ng Harness app. Kung gusto mo ang parehong "prompt in, tool out" na daloy sa sarili mong script at gamit ang sarili mong key, sapat na ang ordinaryong chat completion para sa single-file na kaso. Kung gagamitin mo mismo ang Harness, ang pagkonekta nito sa CheapTokens ay isang hiwalay na maikling gabay.
Ano ang kailangan ng isang "build me a tool" na prompt#
Basahin ang ilan sa mga demo prompt na iyon at may pattern na lalabas. Sinasabi ng bawat isa kung ano ang tool, ano ang nasa screen, ano ang ginagawa ng mga kontrol, ano ang panimulang estado, at ano ang hindi dapat gawin. Kapag may nakalimutan, pinupunan ng modelo ang puwang ng sarili nitong hula, na kadalasan ay hindi ang sa iyo.
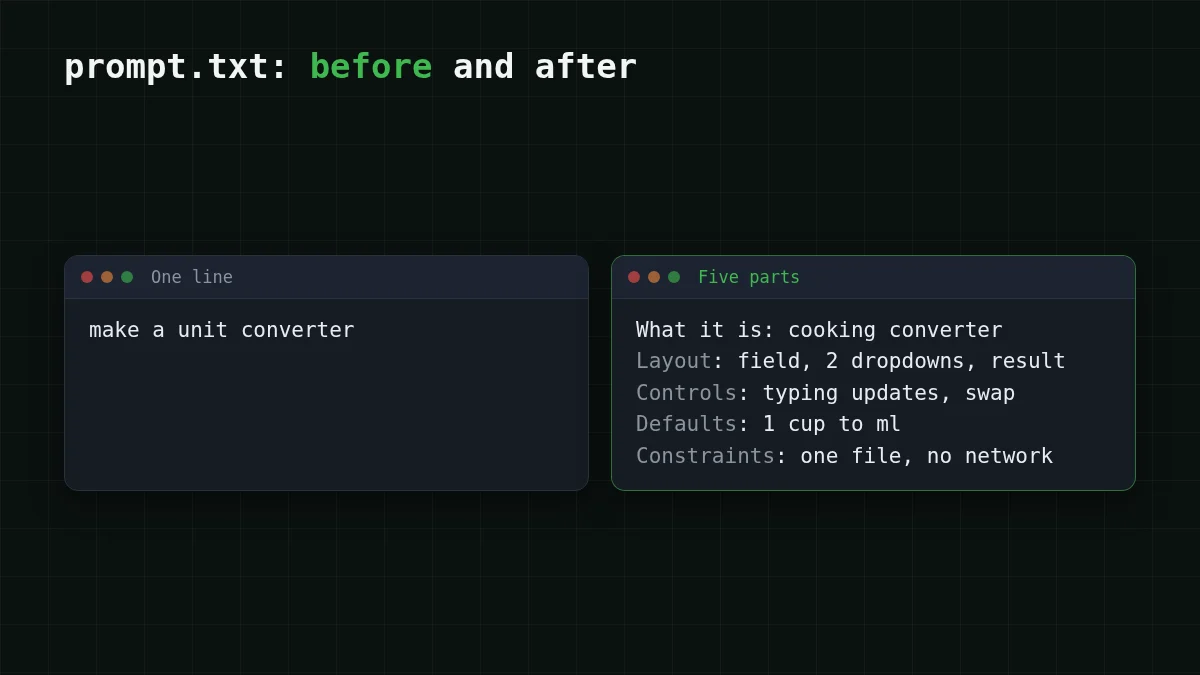
Narito ang template, limang bahagi:
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
At isang punong bersyon. Sabihin nating palagi kang nagko-convert ng cooking measurements at pagod ka nang maghanap ng converter:
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.
I-save iyon bilang prompt.txt sa tabi ng script. Ang linyang "Constraints" ang may pinakamalaking bigat: kung walang "no external requests" gusto ng modelo na kumuha ng CDN library, at pagkatapos ay hindi na gumagana ang pahina offline.
Ang script: request, check, save#
Ang CheapTokens API ay OpenAI Chat Completions compatible sa https:/, kaya gumagana ang openai package na may dalawang pagbabago: ang base URL at ang key. Para sa buong pahina ginagamit namin ang deepseek-: pinapayagan nito ang hanggang 32,768 output tokens bawat sagot at may 380K context window. Ang buong detalye ng API ay nasa CheapTokens docs.
I-install ang package, ilagay ang iyong key sa isang environment variable, at itakda ang dalawang presyo mula sa pricing table (ginagamit ng script ang mga ito para i-print ang gastos):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"
Pagkatapos ay make_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
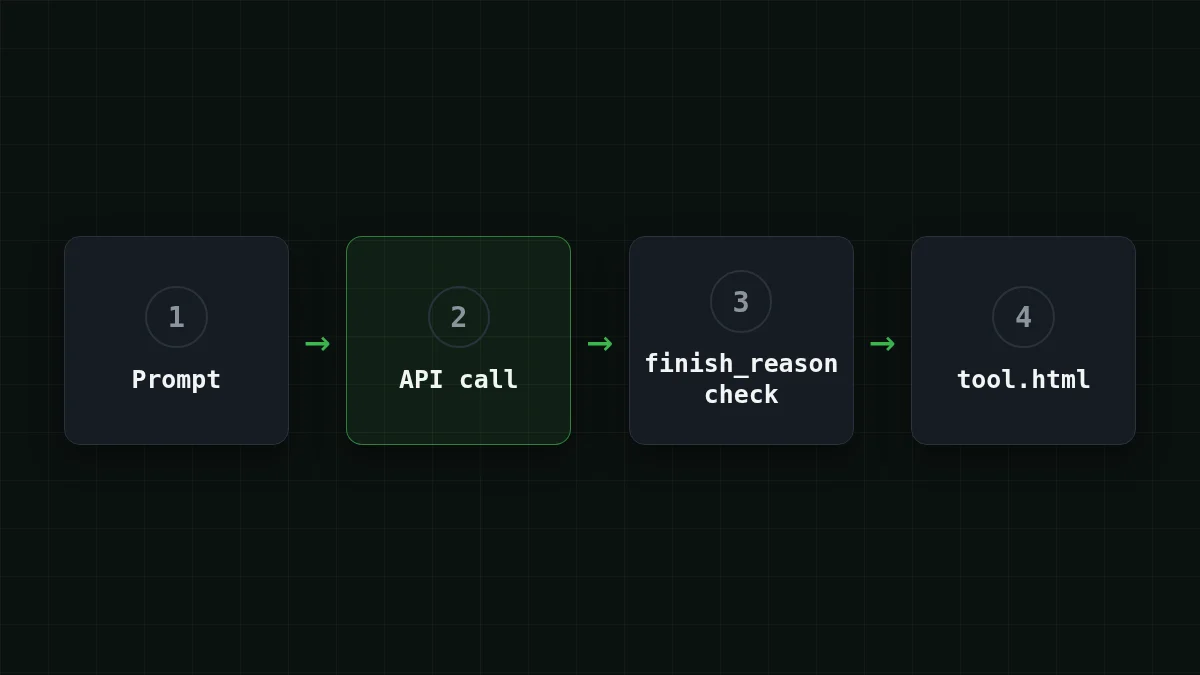
Mahalaga ang pagkakasunod-sunod ng mga hakbang, at madaling magkamali:
Ilagay sa tamang pagkakasunod-sunod
Ilagay ang mga hakbang ng script sa pagkakasunod-sunod na pinapatakbo nito
I-drag ang mga item o gamitin ang mga arrow
- Ipadala ang prompt na may sapat na max_tokens
- Suriin ang finish_reason bago hawakan ang teksto
- Kunin ang HTML mula sa code fence, kung mayroon
- Tiyakin na naroon ang pangwakas na </html>
- I-save ang tool.html at i-print ang usage
Bakit ang max_tokens ang nagpapasya kung gumagana ang pahina#
Ang buong interactive na pahina ay isang mahabang sagot. Mabilis dumami ang HTML, CSS at JavaScript, at isinusulat sila ng modelo sa ganoong pagkakasunod-sunod: kung mapuputol ang sagot, ang dulo ng script ang unang mawawala, na siyang eksaktong bahaging nagpapagana sa mga button. Maaaring magbukas pa rin ang browser sa pahina. Wala lang itong gagawin.
Kaya sinusuri ng script ang finish_reason bago tingnan ang teksto. Ang stop ay nangangahulugang natapos ng modelo nang kusa. Ang length ay nangangahulugang naabot nito ang max_tokens na kisame sa gitna ng file. Ang pangkalahatang bersyon ng problemang ito ay saklaw sa AI answer cut off? Fix finish_reason length; dito maikli ang tuntunin: huwag kailanman i-save ang pahinang ang finish_reason ay length.
Kung makita mo ito:
- taasan ang
max_tokens(pinapayagan ng DeepSeek-V4-Flash ang hanggang 32,768 bawat sagot); - o humingi ng mas kaunti: mas kaunting kontrol, isang screen, walang animation;
- sa GLM-5.3-Flash (
zai-) ang kisame ay 8,192 output tokens, kaya ang modelong iyon ay para sa maliliit na tool, tulad ng converter sa itaas.org/ GLM- 5. 3- Flash
Ang pangalawang pagsusuri, </html> sa teksto, ay nakakahuli ng mas tahimik na pagkabigo kung saan tinatapos ng modelo ang sagot nang magalang nang hindi natatapos ang file. Ang pagtatakda ng max_tokens ay hindi rin nagpapasulat ng mas marami sa modelo: kisame lang ito, at binabayaran mo ang mga token na aktwal na nalikha (higit pa riyan sa Cut output tokens).
Mabilisang pagsusuri
Nag-print ang script ng finish_reason = length. Ano ang gagawin mo?
Ipakita ang sagot
Sagot: Huwag i-save; taasan ang max_tokens o bawasan ang hiling
Ang length ay nangangahulugang naputol ang sagot sa kisame, kaya nawawala ang dulo ng script. Ang mas mababang kisame ay nagpapadali ng pagputol.
Buksan ito at tingnan ang pahina#
Buksan ang tool.html sa pamamagitan ng pag-double-click, o mula sa terminal: open tool.html sa macOS, xdg- sa Linux, start tool.html sa Windows.
Ito ay code na isinulat ng modelo para sa iyo, kaya maglaan ng isang minuto bago mo ito pagkatiwalaan. Buksan ang developer tools ng browser (F12), tingnan ang Network tab at i-reload: sa "no external requests" na constraint dapat itong manatiling walang laman. Pagkatapos ay i-click ang bawat kontrol mula sa "Controls" na bahagi ng iyong prompt nang isang beses.
Kung may mali, huwag mag-regenerate mula sa simula. Magdagdag ng isang pangungusap sa prompt tungkol sa partikular na bagay ("the swap button must also swap the two values") at patakbuhin muli. Sinasabi ng sariling pahina ng DeepSeek na ang ilan sa mga demo nito ay pinino sa ilang round ng usapan, kaya normal lang ang pangalawang pass.
Subukan mo mismoSubukan: ano ang inaasahan mong makita sa Network tab para sa converter?Ipakita ang sagot
Wala: ang pahina ay isang file na may inline CSS at JavaScript, kaya pagkatapos ng unang load wala nang karagdagang request. Kung may nakita kang request sa CDN, binalewala ng modelo ang constraint; idagdag ito sa prompt sa malalaking titik at patakbuhin muli.
Magkano ang isang generation#
Sabihin nating ang prompt ay mga 600 input tokens at ang natapos na pahina ay mga 6,000 output tokens (isang palagay para sa mid-sized na tool; ang iyong usage na linya ang magpapakita ng tunay na numero). Ang isang run sa DeepSeek-V4-Flash ay $0.00061, at sa GLM-5.3-Flash $0.00025. Pareho silang live na numero mula sa kasalukuyang price list, at sa kabuuan, kasama ang input at output, parehong mas mura kaysa OpenRouter.
| Modelo | Input $/1M | Output $/1M | Gastos | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
600 input at 6,000 output na token sa kabuuan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Sa pagsasanay hindi mo makukuha ang tool nang tama sa unang subok, kaya isipin ito sa mga iteration: sampung tweak ng prompt ay sampung beses ang linyang iyon, maliit pa ring halaga para sa tool na kung hindi ay isusulat mo sa kamay. Halos lahat ng ito ay sa output side, ang pahina mismo, kaya ang pagbawas ng hiling (mas kaunting kontrol) ay nagpapaikli ng sagot at ng bayarin.
Kung hindi ito gumana#
I-scroll ang table pakanan →
| Ano ang nakikita mo | Malamang na dahilan | Ano ang gagawin |
|---|---|---|
401 o 404 mula sa API |
maling key, base URL o model id | suriin ang tatlo, tingnan ang API 401 or 404 error |
Cut off at max_ |
mas mahaba ang pahina kaysa sa kisame | taasan ang max_tokens o humingi ng mas kaunti |
The reply has no closing </ |
maagang tumigil ang modelo o nagdagdag ng teksto | patakbuhin muli; idagdag ang "end with </html>" sa prompt |
| Bumubukas ang pahina pero walang ginagawa ang mga button | error sa JavaScript | buksan ang console (F12), i-paste ang pulang error sa follow-up prompt |
Kung gusto mong i-parse ang sagot ng modelo bilang data sa halip na pahina, ang trick sa pagkuha ay pareho sa json.JSONDecodeError on an LLM reply. Bago sa API? Magsimula sa your first API request.


