API i SDKPrzewodnik
Wygeneruj narzędzie HTML z jednego promptu za pomocą API (Python)
Skrypt w Pythonie, który zamienia jeden prompt w działający tool.html, wyłapuje uciętą odpowiedź przez finish_reason i drukuje tokeny oraz koszt.
Na tej stronie
Z jednego wywołania API możesz otrzymać działające narzędzie w jednym pliku: wyślij dobrze ustrukturyzowany prompt, upewnij się, że max_tokens jest wystarczająco duże na całą stronę, sprawdź, że finish_reason to stop, i zapisz odpowiedź jako tool.html. Poniżej znajduje się skrypt, który robi dokładnie to, oraz szablon promptu, który możesz dostosować do własnego narzędzia.
Pomysł jest prosty i DeepSeek właśnie go pokazał. Opublikował kolekcję siedmiu przykładowych promptów dla trybu Creator w DeepSeek Harness (strona sprawdzona 3 listopada 2026): galeria zabytków 3D, warsztat plakatów, warsztat edycji wideo, czytnik artykułów, tablica statystyk rozmów i kilka innych. Tryb Creator działa wewnątrz aplikacji Harness. Jeśli chcesz mieć ten sam przepływ „prompt na wejściu, narzędzie na wyjściu” we własnym skrypcie i z własnym kluczem, zwykłe uzupełnienie czatu wystarczy w przypadku pojedynczego pliku. Jeśli jednak używasz samego Harness, podłączenie go do CheapTokens to osobny krótki przewodnik.
Czego potrzebuje prompt „zbuduj mi narzędzie”#
Przeczytaj kilka z tych przykładowych promptów, a zobaczysz wzorzec. Każdy mówi, czym jest narzędzie, co jest na ekranie, co robią kontrolki, jaki jest stan początkowy i czego nie wolno robić. Pomiń któryś z tych elementów, a model wypełni lukę własnym domysłem, który zwykle nie jest twój.
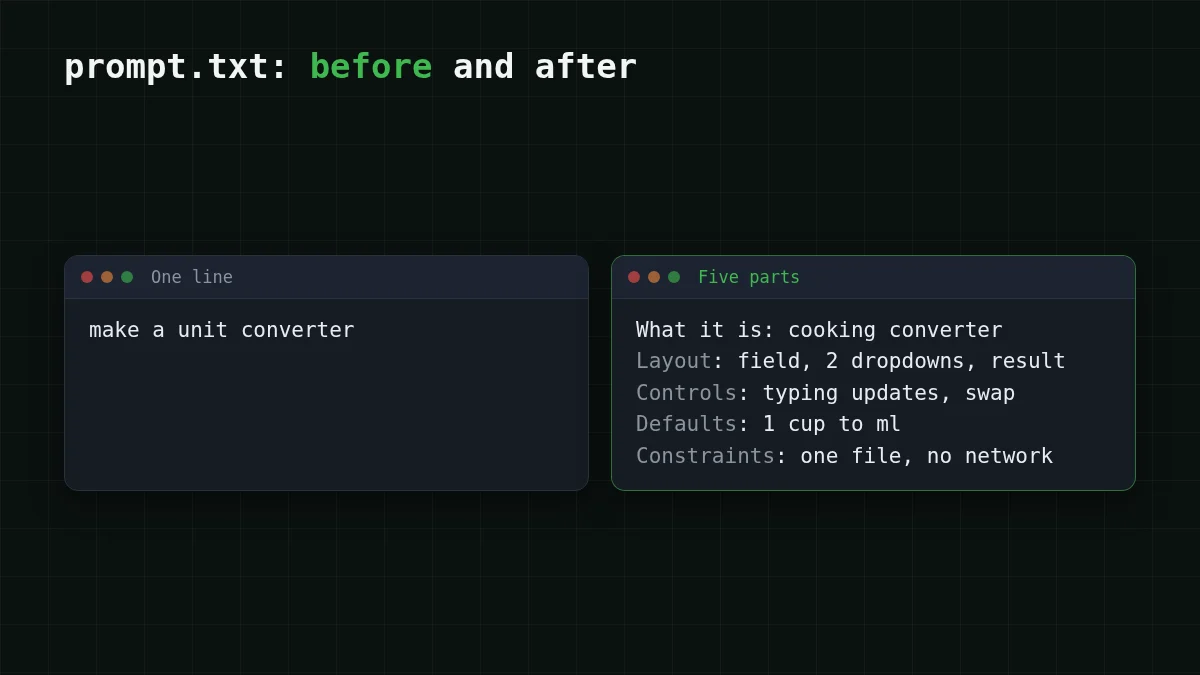
Oto szablon, pięć części:
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
A oto wypełniona wersja. Powiedzmy, że ciągle przeliczasz miary kuchenne i masz dość szukania konwertera:
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.
Zapisz to jako prompt.txt obok skryptu. Linia „Constraints” dźwiga najwięcej: bez „no external requests” model lubi podciągnąć bibliotekę z CDN, a strona wtedy psuje się offline.
Skrypt: żądanie, sprawdzenie, zapis#
API CheapTokens jest zgodne z OpenAI Chat Completions pod https:/, więc pakiet openai działa z dwiema zmianami: bazowym URL i kluczem. Dla całej strony używamy deepseek-: pozwala na do 32 768 tokenów wyjściowych na odpowiedź i ma okno kontekstu 380K. Pełne szczegóły API są w dokumentacji CheapTokens.
Zainstaluj pakiet, umieść klucz w zmiennej środowiskowej i ustaw dwie ceny z tabeli cen (skrypt używa ich do wydrukowania kosztu):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"
Następnie make_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
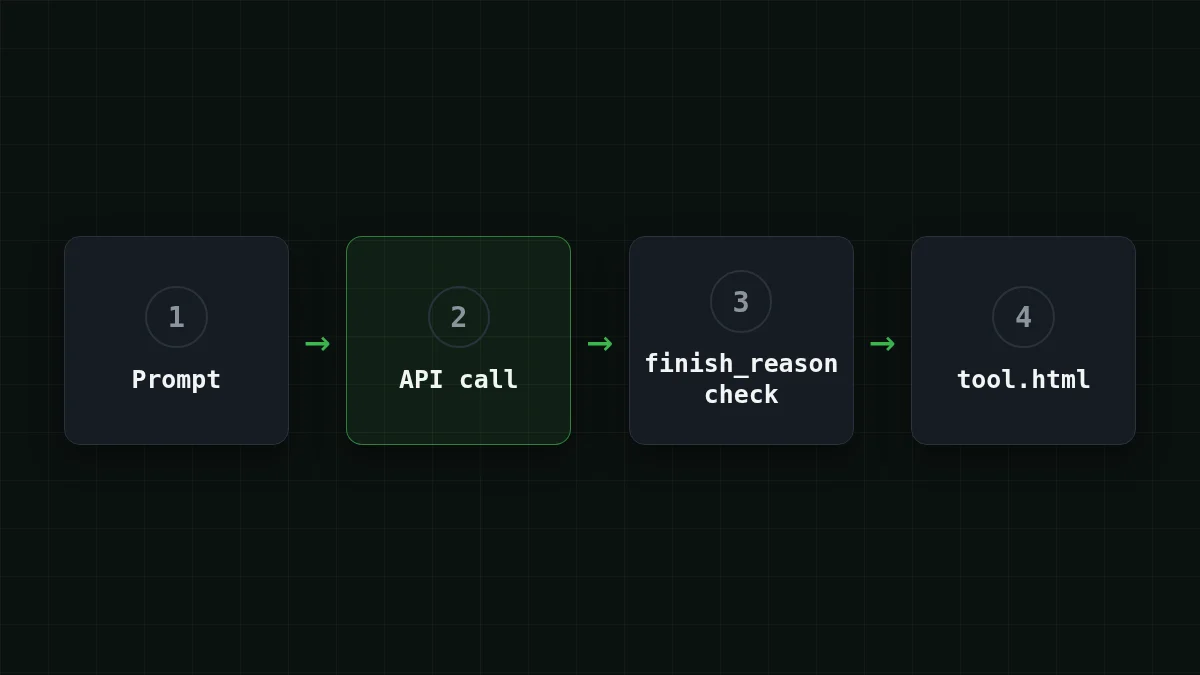
Kolejność kroków ma znaczenie i łatwo ją pomylić:
Ustaw w kolejności
Ułóż kroki skryptu w kolejności wykonania
Przeciągnij elementy lub użyj strzałek
- Wyślij prompt z hojnym max_tokens
- Sprawdź finish_reason, zanim dotkniesz tekstu
- Wyciągnij HTML z bloku kodu, jeśli taki jest
- Potwierdź, że zamykający </html> jest na miejscu
- Zapisz tool.html i wydrukuj zużycie
Dlaczego max_tokens decyduje, czy strona działa#
Pełna interaktywna strona to długa odpowiedź. HTML, CSS i JavaScript szybko się sumują, a model pisze je w tej kolejności: jeśli odpowiedź zostanie ucięta, najpierw tracisz koniec skryptu, czyli dokładnie tę część, która sprawia, że przyciski działają. Przeglądarka może nadal otworzyć stronę. Po prostu nic nie robi.
Dlatego skrypt sprawdza finish_reason, zanim spojrzy na tekst. stop oznacza, że model zakończył samodzielnie. length oznacza, że trafił w limit max_tokens w połowie pliku. Ogólne ujęcie tego problemu znajdziesz w Odpowiedź AI ucięta? Napraw finish_reason length; tutaj zasada jest krótka: nigdy nie zapisuj strony, której finish_reason to length.
Jeśli to zobaczysz:
- zwiększ
max_tokens(DeepSeek-V4-Flash pozwala na do 32 768 na odpowiedź); - albo poproś o mniej: mniej kontrolek, jeden ekran, bez animacji;
- w GLM-5.3-Flash (
zai-) limit to 8 192 tokeny wyjściowe, więc ten model pasuje do małych narzędzi, takich jak powyższy konwerter.org/ GLM- 5. 3- Flash
Drugie sprawdzenie, </html> w tekście, wyłapuje cichszą awarię, gdy model kończy odpowiedź uprzejmie, nie kończąc pliku. Ustawienie max_tokens również nie sprawia, że model pisze więcej: to tylko limit, a płacisz za faktycznie wygenerowane tokeny (więcej w Cut output tokens).
Szybkie sprawdzenie
Skrypt wydrukował finish_reason = length. Co robisz?
Pokaż odpowiedź
Odpowiedź: Nie zapisuj; zwiększ max_tokens lub zmniejsz żądanie
length oznacza, że odpowiedź została ucięta na limicie, więc brakuje końca skryptu. Niższy limit sprawia, że cięcie następuje wcześniej.
Otwórz i obejrzyj stronę#
Otwórz tool.html, klikając dwukrotnie, lub z terminala: open tool.html na macOS, xdg- na Linuksie, start tool.html na Windowsie.
To kod, który napisał dla ciebie model, więc poświęć chwilę, zanim mu zaufasz. Otwórz narzędzia deweloperskie przeglądarki (F12), spójrz na zakładkę Network i odśwież: przy ograniczeniu „no external requests” powinna pozostać pusta. Następnie kliknij każdą kontrolkę z części „Controls” swojego promptu po razie.
Jeśli coś jest nie tak, nie generuj od zera. Dodaj do promptu jedno zdanie o konkretnej rzeczy („przycisk zamiany musi też zamieniać dwie wartości”) i uruchom ponownie. Strona DeepSeek sama zauważa, że niektóre z jej dem były dopracowywane przez kilka rund rozmowy, więc druga próba jest normalna.
Spróbuj samSpróbuj: czego spodziewasz się zobaczyć w zakładce Network dla konwertera?Pokaż odpowiedź
Nic: strona to pojedynczy plik z wbudowanym CSS i JavaScriptem, więc po pierwszym załadowaniu nie ma dalszych żądań. Jeśli widzisz żądanie do CDN, model zignorował ograniczenie; dodaj je do promptu wielkimi literami i uruchom ponownie.
Ile kosztuje jedno generowanie#
Powiedzmy, że prompt to około 600 tokenów wejściowych, a gotowa strona to około 6 000 tokenów wyjściowych (założenie dla średniej wielkości narzędzia; twoja własna linia usage pokaże rzeczywiste liczby). Jedno uruchomienie na DeepSeek-V4-Flash to $0.00061, a na GLM-5.3-Flash $0.00025. Obie liczby są aktualne z bieżącego cennika, a łącznie, z wejściem i wyjściem razem, obie są tańsze niż OpenRouter.
| Model | Wejście $/1M | Wyjście $/1M | Koszt | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
600 tokenów wejściowych i 6000 tokenów wyjściowych łącznie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
W praktyce nie uda ci się zrobić narzędzia za pierwszym razem, więc myśl iteracjami: dziesięć poprawek promptu to dziesięć razy ta linia, wciąż niewielka suma za narzędzie, które w przeciwnym razie napisałbyś ręcznie. Prawie całość to strona wyjściowa, sama strona, dlatego zmniejszenie żądania (mniej kontrolek) skraca odpowiedź i rachunek.
Jeśli nie działa#
Przewiń tabelę w prawo →
| Co widzisz | Prawdopodobna przyczyna | Co zrobić |
|---|---|---|
401 lub 404 z API |
zły klucz, bazowy URL lub identyfikator modelu | sprawdź te trzy, zobacz API 401 lub 404 |
Cut off at max_ |
strona dłuższa niż limit | zwiększ max_tokens lub poproś o mniej |
The reply has no closing </ |
model zatrzymał się wcześnie lub dodał tekst | uruchom ponownie; dodaj „end with </html>” do promptu |
| Strona się otwiera, ale przyciski nic nie robią | błąd JavaScript | otwórz konsolę (F12), wklej czerwony błąd do kolejnego promptu |
Jeśli chcesz, aby odpowiedź modelu została sparsowana jako dane, a nie strona, trik z ekstrakcją jest taki sam jak w json.JSONDecodeError w odpowiedzi LLM. Nowy w API? Zacznij od pierwszego żądania API.


