API & SDKAnleitung
Ein HTML-Tool aus einem Prompt mit einer API generieren (Python)
Ein Python-Skript, das aus einem Prompt eine funktionierende tool.html macht, eine abgeschnittene Antwort per finish_reason erkennt und Tokens und Kosten ausgibt.
Auf dieser Seite
Sie können mit einem einzigen API-Aufruf ein funktionierendes Single-File-Tool erhalten: Senden Sie einen gut strukturierten Prompt, stellen Sie sicher, dass max_tokens groß genug für eine ganze Seite ist, prüfen Sie, dass finish_reason stop ist, und speichern Sie die Antwort als tool.html. Unten finden Sie das Skript, das genau das tut, und eine Prompt-Vorlage, die Sie für Ihr eigenes Tool anpassen können.
Die Idee ist einfach, und DeepSeek hat sie gerade gezeigt. Es hat eine Sammlung von sieben Demo-Prompts für den Creator Mode in DeepSeek Harness veröffentlicht (die Seite, geprüft am 3. November 2026): eine 3D-Wahrzeichen-Galerie, eine Poster-Werkbank, eine Videobearbeitungs-Werkbank, einen Paper-Reader, ein Konversationsstatistik-Board und einige mehr. Der Creator Mode lebt in der Harness-App. Wenn Sie denselben "Prompt rein, Tool raus"-Ablauf in Ihrem eigenen Skript und mit Ihrem eigenen Key wollen, reicht für den Single-File-Fall eine gewöhnliche Chat-Completion. Wenn Sie Harness selbst nutzen, ist die Verbindung mit CheapTokens eine separate kurze Anleitung.
Was ein "bau mir ein Tool"-Prompt braucht#
Lesen Sie ein paar dieser Demo-Prompts, und ein Muster zeigt sich. Jeder sagt, was das Tool ist, was auf dem Bildschirm ist, was die Steuerelemente tun, was der Ausgangszustand ist und was es nicht tun darf. Lassen Sie einen dieser Punkte weg, und das Modell füllt die Lücke mit seiner eigenen Vermutung, die meist nicht Ihre ist.
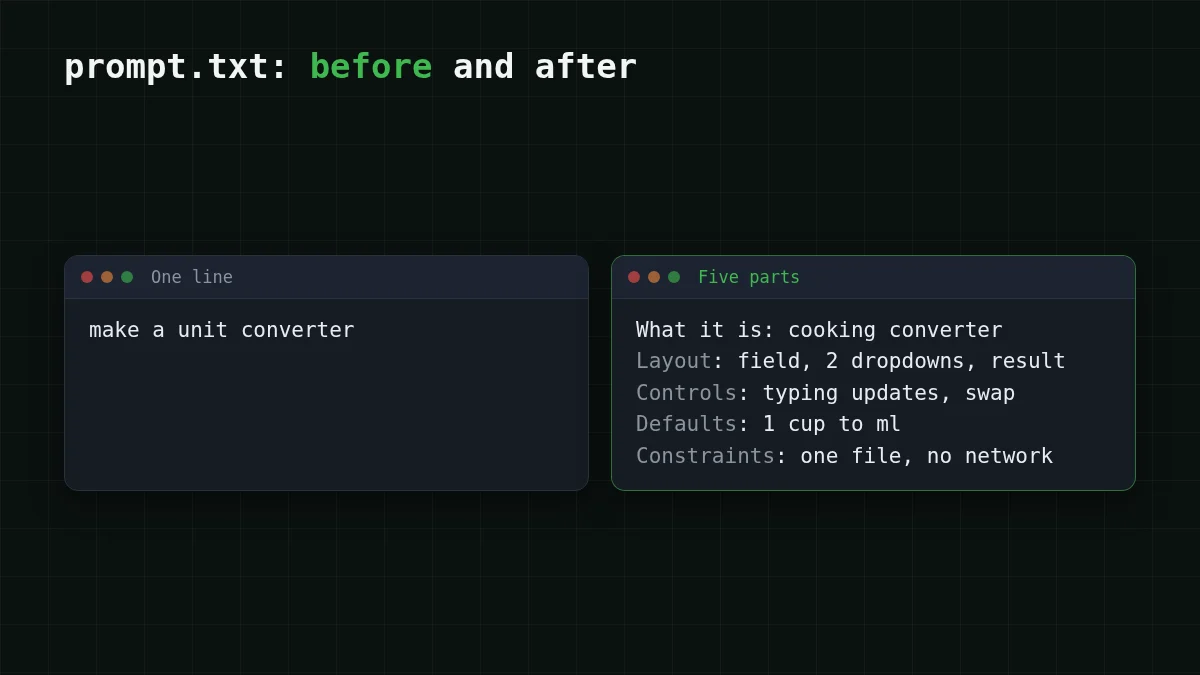
Hier ist die Vorlage, fünf Teile:
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
Und eine ausgefüllte Version. Angenommen, Sie rechnen ständig Kochmaße um und sind es leid, nach einem Konverter zu suchen:
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.
Speichern Sie das als prompt.txt neben dem Skript. Die Zeile "Constraints" trägt das meiste Gewicht: Ohne "no external requests" zieht das Modell gern eine CDN-Bibliothek, und die Seite bricht dann offline.
Das Skript: anfragen, prüfen, speichern#
Die CheapTokens-API ist OpenAI Chat Completions kompatibel unter https:/, also funktioniert das openai-Paket mit zwei Änderungen: der Basis-URL und dem Key. Für eine ganze Seite verwenden wir deepseek-: Es erlaubt bis zu 32.768 Ausgabe-Tokens pro Antwort und hat ein Kontextfenster von 380K. Vollständige API-Details stehen in der CheapTokens-Doku.
Installieren Sie das Paket, legen Sie Ihren Key in eine Umgebungsvariable und setzen Sie die beiden Preise aus der Preistabelle (das Skript nutzt sie, um die Kosten auszugeben):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"
Dann make_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
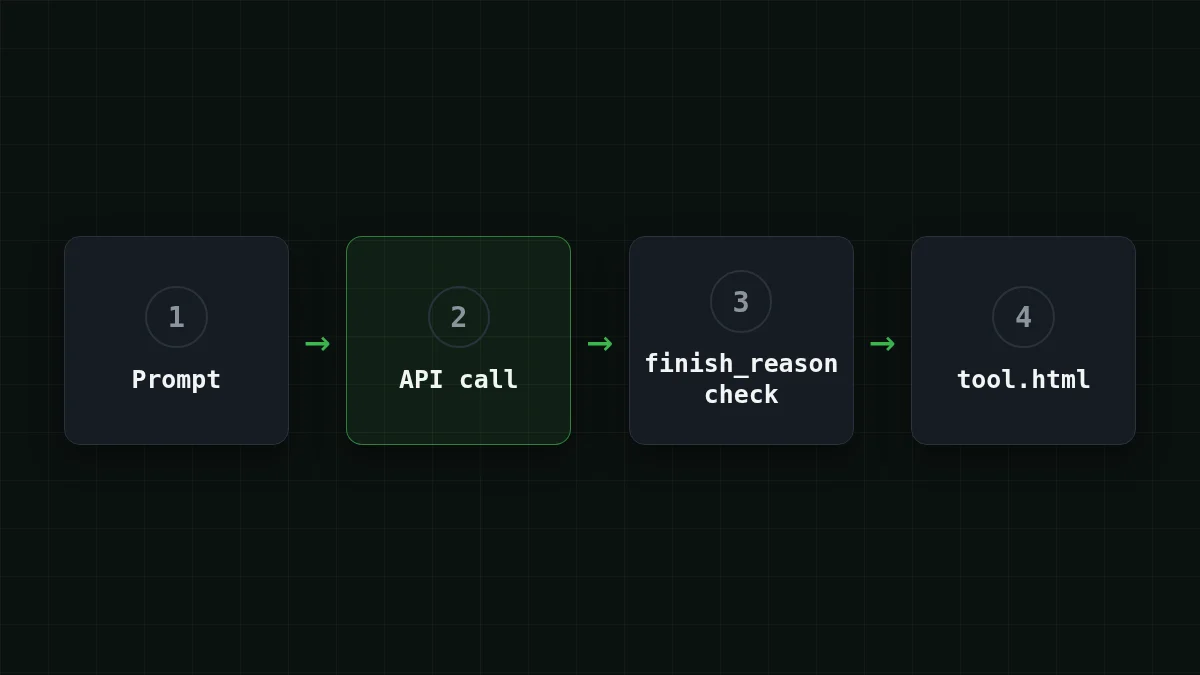
Die Reihenfolge der Schritte ist wichtig, und es ist leicht, sie falsch zu machen:
In die richtige Reihenfolge bringen
Bringen Sie die Schritte des Skripts in die Reihenfolge, in der es sie ausführt
Ziehe die Elemente oder benutze die Pfeile
- Senden Sie den Prompt mit einem großzügigen max_tokens
- Prüfen Sie finish_reason, bevor Sie den Text anfassen
- Ziehen Sie das HTML aus dem Code-Fence, falls es einen gibt
- Bestätigen Sie, dass das schließende </html> da ist
- Speichern Sie tool.html und geben Sie die Nutzung aus
Warum max_tokens entscheidet, ob die Seite funktioniert#
Eine vollständige interaktive Seite ist eine lange Antwort. HTML, CSS und JavaScript summieren sich schnell, und das Modell schreibt sie in dieser Reihenfolge: Wird die Antwort abgeschnitten, verlieren Sie zuerst das Ende des Skripts, also genau den Teil, der die Buttons zum Laufen bringt. Der Browser öffnet die Seite vielleicht trotzdem. Sie tut nur nichts.
Deshalb prüft das Skript finish_reason, bevor es den Text ansieht. stop bedeutet, das Modell ist von selbst fertig geworden. length bedeutet, es hat mitten in der Datei die max_tokens-Obergrenze erreicht. Die allgemeine Version dieses Problems wird in KI-Antwort abgeschnitten? finish_reason length beheben behandelt; hier ist die Regel kurz: Speichern Sie niemals eine Seite, deren finish_reason length ist.
Wenn Sie es doch sehen:
- erhöhen Sie
max_tokens(DeepSeek-V4-Flash erlaubt bis zu 32.768 pro Antwort); - oder verlangen Sie weniger: weniger Steuerelemente, ein Bildschirm, keine Animationen;
- bei GLM-5.3-Flash (
zai-) liegt die Obergrenze bei 8.192 Ausgabe-Tokens, also passt dieses Modell zu kleinen Tools wie dem Konverter oben.org/ GLM- 5. 3- Flash
Die zweite Prüfung, </html> im Text, fängt den leiseren Fehler ab, bei dem ein Modell die Antwort höflich beendet, ohne die Datei fertigzustellen. max_tokens zu setzen, lässt das Modell auch nicht mehr schreiben: Es ist nur eine Obergrenze, und Sie zahlen für tatsächlich erzeugte Tokens (mehr dazu in Ausgabe-Tokens kürzen).
Kurzer Check
Das Skript hat finish_reason = length ausgegeben. Was tun Sie?
Antwort anzeigen
Antwort: Nicht speichern; max_tokens erhöhen oder die Anfrage verkleinern
length bedeutet, die Antwort wurde an der Obergrenze abgeschnitten, also fehlt das Ende des Skripts. Eine niedrigere Obergrenze lässt den Schnitt früher kommen.
Öffnen und die Seite ansehen#
Öffnen Sie tool.html per Doppelklick oder im Terminal: open tool.html unter macOS, xdg- unter Linux, start tool.html unter Windows.
Das ist Code, den ein Modell für Sie geschrieben hat, also nehmen Sie sich eine Minute, bevor Sie ihm trauen. Öffnen Sie die Entwicklertools des Browsers (F12), sehen Sie sich den Network-Tab an und laden Sie neu: Mit der Constraint "no external requests" sollte er leer bleiben. Klicken Sie dann jedes Steuerelement aus dem "Controls"-Teil Ihres Prompts einmal an.
Wenn etwas nicht stimmt, generieren Sie nicht von Grund auf neu. Fügen Sie einen Satz zum Prompt hinzu, der die konkrete Sache beschreibt ("der Swap-Button muss auch die beiden Werte tauschen"), und führen Sie erneut aus. DeepSeeks eigene Seite merkt an, dass einige seiner Demos über mehrere Gesprächsrunden verfeinert wurden, also ist ein zweiter Durchlauf normal.
Probier es selbstProbieren Sie es: Was erwarten Sie im Network-Tab für den Konverter?Antwort anzeigen
Nichts: Die Seite ist eine einzelne Datei mit Inline-CSS und -JavaScript, also gibt es nach dem ersten Laden keine weiteren Anfragen. Wenn Sie eine Anfrage an ein CDN sehen, hat das Modell die Constraint ignoriert; schreiben Sie sie in Großbuchstaben in den Prompt und führen Sie erneut aus.
Was eine Generierung kostet#
Angenommen, der Prompt hat etwa 600 Eingabe-Tokens und die fertige Seite etwa 6.000 Ausgabe-Tokens (eine Annahme für ein mittelgroßes Tool; Ihre eigene usage-Zeile zeigt die echten Zahlen). Ein Lauf auf DeepSeek-V4-Flash kostet $0.00061, auf GLM-5.3-Flash $0.00025. Beides sind Live-Zahlen aus der aktuellen Preisliste, und insgesamt, mit Eingabe und Ausgabe zusammen gerechnet, sind beide günstiger als OpenRouter.
| Modell | Input $/1M | Output $/1M | Kosten | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
600 Input- und 6.000 Output-Tokens insgesamt. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
In der Praxis werden Sie das Tool nicht beim ersten Versuch richtig hinbekommen, also denken Sie in Iterationen: Zehn Anpassungen des Prompts sind zehnmal diese Zeile, immer noch eine kleine Summe für ein Tool, das Sie sonst von Hand schreiben würden. Fast alles davon ist die Ausgabeseite, die Seite selbst, weshalb eine kleinere Anfrage (weniger Steuerelemente) die Antwort und die Rechnung verkürzt.
Wenn es nicht funktioniert#
Tabelle nach rechts scrollen →
| Was Sie sehen | Wahrscheinliche Ursache | Was zu tun ist |
|---|---|---|
401 oder 404 von der API |
falscher Key, Basis-URL oder Modell-ID | prüfen Sie die drei, siehe API-Fehler 401 oder 404 |
Cut off at max_ |
Seite länger als die Obergrenze | max_tokens erhöhen oder weniger verlangen |
The reply has no closing </ |
das Modell hat früh gestoppt oder Text hinzugefügt | erneut ausführen; "end with </html>" zum Prompt hinzufügen |
| Die Seite öffnet sich, aber Buttons tun nichts | JavaScript-Fehler | Konsole öffnen (F12), den roten Fehler in einen Folge-Prompt einfügen |
Wenn Sie die Antwort des Modells als Daten statt als Seite parsen wollen, ist der Extraktions-Trick derselbe wie in json.JSONDecodeError bei einer LLM-Antwort. Neu bei der API? Beginnen Sie mit Ihrer ersten API-Anfrage.


