FehlerbehebungAnleitung
json.JSONDecodeError bei einer LLM-Antwort: das JSON in Python extrahieren
json.loads scheitert bei einer Modellantwort? Lesen Sie exc.pos und finish_reason, um die Ursache zu finden, extrahieren Sie dann das JSON mit raw_decode und wiederholen Sie einmal.
Auf dieser Seite
Ihr Skript fordert vom Modell JSON an, ruft json. auf und stirbt mit json.. Meistens hat das Modell geantwortet: Es hat das JSON in einen ```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder. und wiederholen Sie den Versuch einmal, wenn nichts gerettet werden kann.
Drei Wege, wie eine Antwort json.loads bricht#
Die Dokumentation zu Pythons json (Python-3.15-Docs, geprüft am 2. November 2026) sagt, dass JSONDecodeError eine Unterklasse von ValueError mit den Attributen msg, doc, pos, lineno und colno ist. Das hier relevante ist pos: der Index im String, an dem das Parsen fehlgeschlagen ist.
Angenommen, ein Skript zieht Felder aus Kunden-E-Mails und fragt nach {"name": .. Diese drei Strings sind die Antworten, die es brechen. Fügen Sie sie in eine Python-Shell ein:
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
Die ersten beiden scheitern bei pos 0: Der Parser hat sich das allererste Zeichen angesehen, ein Backtick oder ein S, und aufgegeben. Das dritte scheitert am Ende des Strings (pos ist gleich len(reply)): Alles, was es gelesen hat, war in Ordnung, dann ging der Text aus. Dieser Unterschied ist Ihre Diagnose. Position 0 bedeutet, das JSON ist wahrscheinlich da, nur eingewickelt. Position am Ende bedeutet, die Antwort wurde vorzeitig abgebrochen.
Abgeschnittene Antworten: finish_reason prüfen, bevor Sie parsen#
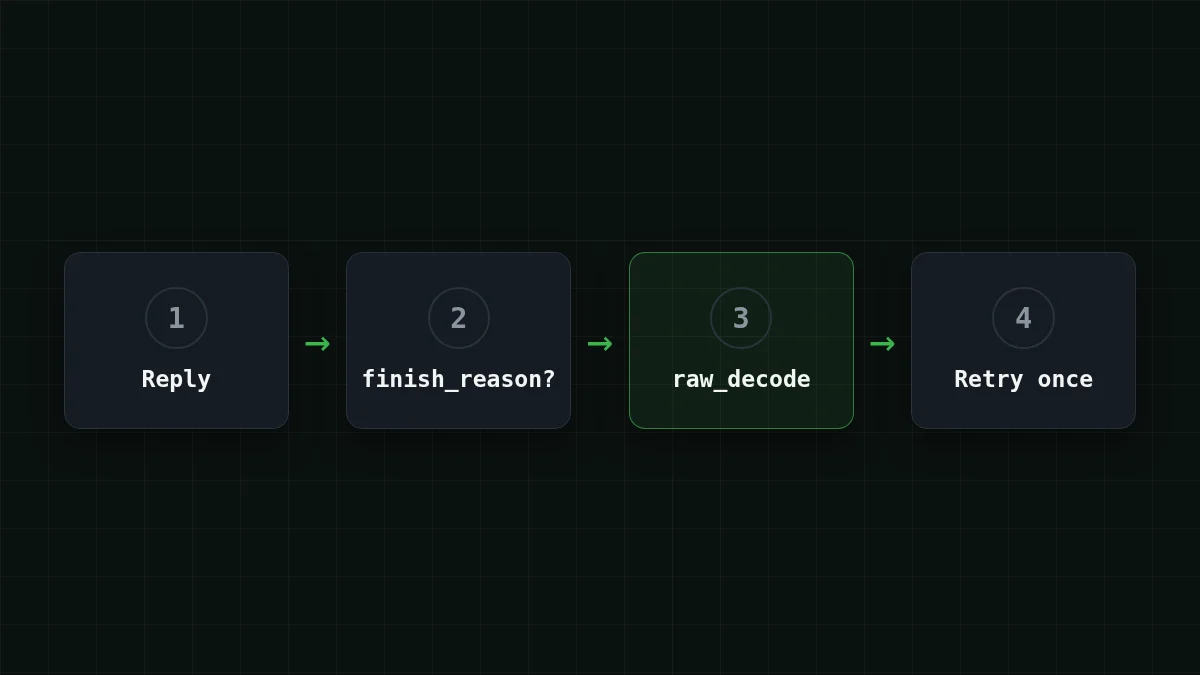
Eine Antwort, die mittendrin aufhört, ist kein Parsing-Problem, sondern ein Längenproblem. Die API sagt es Ihnen: Die Choice hat finish_reason, und "length" bedeutet, die Antwort wurde durch max_tokens abgeschnitten (die ganze Geschichte steht in AI answer cut off? Fix finish_reason "length" and max_tokens). Schauen Sie zuerst darauf, vor jeder Extraktion.
Es gibt eine üble Falle, wenn Sie diesen Schritt überspringen. Ein Scanner, der nach dem ersten parsebaren { sucht, kann ein vollständiges inneres Objekt aus einem halbfertigen äußeren aufschnappen, und Ihr Skript macht mit den falschen Daten weiter, ohne Fehler. Probieren Sie es:
Probier es selbstProbieren Sie es: Was gibt eine Funktion „finde das erste Objekt“ für diese abgeschnittene Antwort zurück?Antwort anzeigen
Nehmen Sie '{"user": {"name": "Anna"}, "age": 31'. Das äußere Objekt schließt nie, aber das innere {"name": "Anna"} ist vollständig, also gibt der Extraktor unten {'name': 'Anna'} zurück. Keine Exception, falsches Ergebnis. Deshalb kommt die finish_reason-Prüfung vor der Extraktion.
Die Lösung für einen echten Abbruch ist mehr Platz: Erhöhen Sie max_tokens. DeepSeek-V4-Flash erlaubt bis zu 32.768 Ausgabe-Tokens pro Antwort, GLM-5.3-Flash bis zu 8.192, also hat eine lange JSON-Liste beim ersten mehr Platz. Details zu den Modellen stehen auf der CheapTokens-Modellseite.
Ziehen Sie das JSON aus dem Text#
Für Fences und Geplauder hat die Standardbibliothek bereits das Werkzeug. Laut derselben Python-Seite dekodiert JSONDecoder. ein JSON-Dokument aus einem String, der damit beginnt, und gibt das Objekt plus den Index zurück, an dem das Dokument endete. Die Docs sagen, es kann auf einem String mit überflüssigen Daten am Ende verwendet werden. Es braucht, dass das Dokument beim ersten Zeichen beginnt, also schneiden Sie den führenden Text zuerst ab: Suchen Sie ein {, versuchen Sie von dort zu dekodieren, und gehen Sie zum nächsten { über, wenn das fehlschlägt.
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
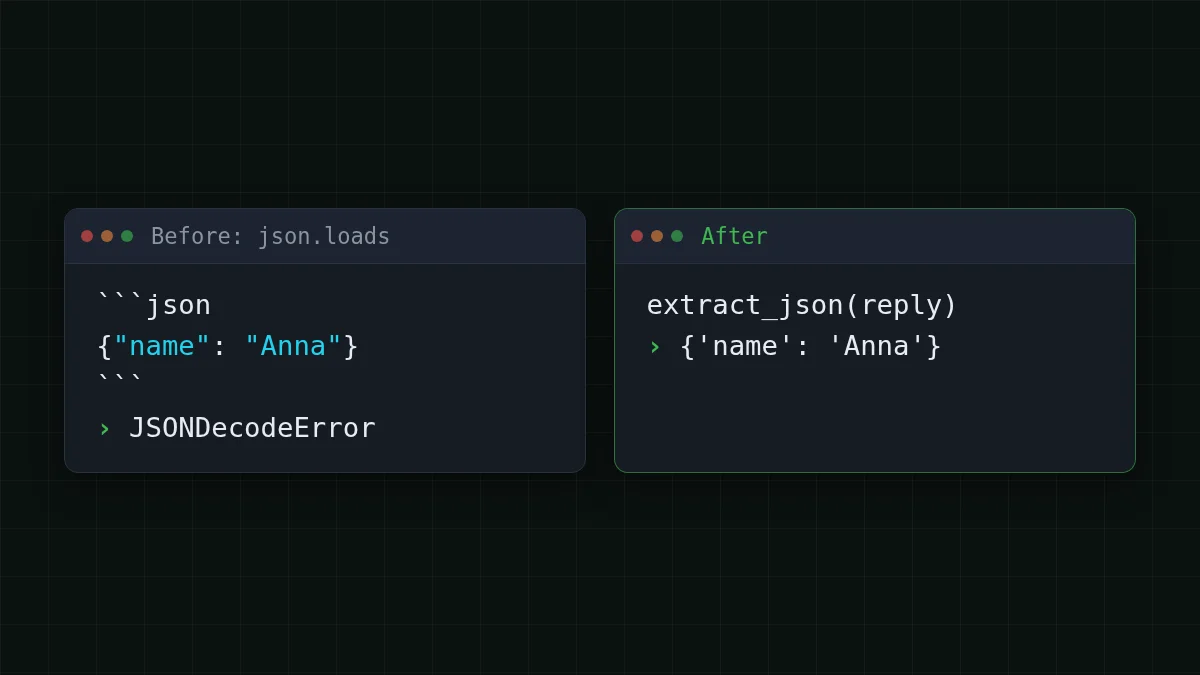
Es behandelt die Fence (das führende ```json is skipped because it is not a {), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1] in einem Satz wie „siehe Anmerkung [1]“ ist gültiges JSON und würde gewinnen.
Zwei Dinge tut es bewusst nicht. Es bearbeitet den Text nie (kein Regex, der Backticks löscht, kein Raten bei fehlenden Klammern), also können Sie eine kaputte Antwort nicht in gültige, aber falsche Daten verwandeln. Und es schlägt laut fehl, wenn nichts zu finden ist, was der Retry unten braucht.
Wiederholen Sie einmal mit einem strengeren Prompt#
Wenn die Antwort abgeschnitten war oder überhaupt kein Objekt enthält, fragen Sie erneut. Einmal, nicht in einer Endlosschleife. Bei einem Abbruch geben Sie dem zweiten Versuch mehr Platz; andernfalls sagen Sie klar, was Sie wollen. Dies nutzt das OpenAI-Python-SDK gegen die CheapTokens-Base-URL (https:/) und die vollständige Modell-ID aus den Docs; der Key liegt in einer Umgebungsvariable.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
Die Reihenfolge ist der Punkt: finish_reason zuerst, Extraktion zweitens, und erst dann ein Retry. Werfen Sie den Fehler nach dem zweiten Versuch, damit ein Batch-Job diesen Eintrag protokollieren und weitermachen kann.
Was ein Retry kostet, ist leicht zu schätzen. Nehmen Sie eine Anfrage mit 1.200 Eingabe-Tokens und 300 Ausgabe-Tokens an (eine Annahme, verwenden Sie Ihre eigenen Zahlen): $0.000048 bei DeepSeek-V4-Flash oder $0.000036 bei GLM-5.3-Flash. Wenn 30 von 1.000 Anfragen den zweiten Versuch brauchen, ist die zusätzliche Rechnung 30 × diese Anfrage, $0.0014 bei DeepSeek-V4-Flash. Preise sind live, sie stammen aus der aktuellen Preisliste.
In die richtige Reihenfolge bringen
Bringen Sie die Reparaturschritte in die richtige Reihenfolge
Ziehe die Elemente oder benutze die Pfeile
- finish_reason prüfen: hier aufhören, wenn length steht
- Das erste { finden und den Text davor abschneiden
- Mit raw_decode dekodieren und ignorieren, was folgt
- Wenn nichts gefunden wurde, einmal mit dem strengeren Prompt wiederholen
Welches Symptom, welche Lösung#
Die Schritte oben passen in Ihren Kopf, bis der nächste seltsame Fehler auftaucht. Das ist dasselbe wie ein Nachschlagewerk: Finden Sie, was Sie auf dem Bildschirm sehen, und lesen Sie die Lösung.
Wähle deinen Fall
Wählen Sie, was Sie sehen
Wähle eine Option, um die Antwort zu sehen
json.loads scheitert bei pos 0
Die Antwort beginnt mit einer Fence oder einem Satz. Lassen Sie sie durch extract_json laufen; ein Retry ist nicht nötig.
pos steht am Ende des Strings
Die Antwort wurde vorzeitig abgebrochen. Prüfen Sie finish_reason: Wenn es length ist, erhöhen Sie max_tokens und fragen Sie erneut.
Der Fehler liegt irgendwo in der Mitte
Das Modell hat selbst kaputtes JSON geschrieben (ein fehlendes Komma, ein abschließendes Komma, ein nicht escaptes Anführungszeichen). Flicken Sie es nicht: Wiederholen Sie einmal mit dem strengeren Prompt und protokollieren Sie die Antwort, wenn es erneut fehlschlägt.
json.loads funktioniert, aber ein Key fehlt
Das Parsen ist in Ordnung, der Inhalt nicht. Listen Sie die exakten Keys im Prompt auf und prüfen Sie sie nach dem Parsen im Code.
Kann die API gültiges JSON erzwingen?#
Manchmal. OpenAIs Structured-Outputs-Guide dokumentiert zwei Modi: den JSON-Modus (type: json_), der gültiges JSON zurückgibt, aber kein Schema befolgt, und Structured Outputs (type: json_, strict: true), die es tun; OpenAI empfiehlt den zweiten, wo möglich (Quelle: developers.openai.com, geprüft am 2. November 2026). Das sind OpenAIs eigene API-Optionen. Bevor Sie sich bei einem anderen Endpoint auf response_format verlassen, prüfen Sie die CheapTokens-Docs; die Extraktion und der Retry oben funktionieren mit einfachen Chat-Completions und brauchen keinen speziellen Parameter. Mehr zu den Optionen auf der Anfrageseite in Get valid JSON from an LLM API: response_format and retries.
Bevor Sie den Parser ausliefern, prüfen Sie vier Dinge: finish_reason wird gelesen, bevor der Text geparst wird, es gibt nur einen Retry (und der zweite Fehlschlag wird mit der Item-ID protokolliert), der Code prüft, dass die erwarteten Keys nach dem Parsen existieren, und max_tokens lässt Platz für das längste JSON, das Sie erwarten.
Wenn das nächste Mal json.loads geworfen wird, geben Sie zuerst exc.pos und finish_reason aus. Diese beiden Zahlen sagen Ihnen meistens, was passiert ist, bevor Sie eine Zeile der Antwort lesen.


