FehlerbehebungAnleitung
UnicodeEncodeError beim Ausgeben einer LLM-Antwort in Python: 3 Fixes
print(reply) stürzt bei Kyrillisch oder Emoji ab? Sieh, warum Python bei umgeleiteter Ausgabe oder einer Legacy-Codepage fehlschlägt, und behebe es mit UTF-8-Modus, reconfigure oder encoding=.
Auf dieser Seite
Deine Anfrage ging durch, das Modell hat geantwortet, und dann ist Python bei print(reply) gestorben. Die API ist nicht schuld. Die Antwort ist in Ordnung; die Stelle, an die du sie ausgibst, kann einige ihrer Zeichen nicht darstellen. Die schnellste Lösung ist, den UTF-8-Modus mit PYTHONUTF8=1 einzuschalten. Wenn du es lieber im Skript behalten willst, rufe sys. ganz oben auf, und wenn du eine Antwort in eine Datei speicherst, übergib encoding="utf-8" an open().
Wie der Fehler aussieht#
Angenommen, du stellst einem Modell eine Frage auf Russisch und gibst die Antwort aus. Das ist das ganze Skript, mit dem einfachen requests-Aufruf aus unserer Anleitung zur ersten Anfrage:
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
Wenn stdout in eine Datei oder Pipe umgeleitet wird oder Python mit einer Legacy-Codepage für seine Streams gestartet wurde, endet die letzte Zeile so:
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>Der Codec-Name in deiner Meldung hängt von der Kodierung des Streams ab (bei einer Windows-Codepage ist es meist charmap, bei ascii ist es ascii), und die Positionen hängen von der Antwort ab. Die Form ist immer dieselbe: Der Traceback zeigt auf print, nicht auf die Anfrage.
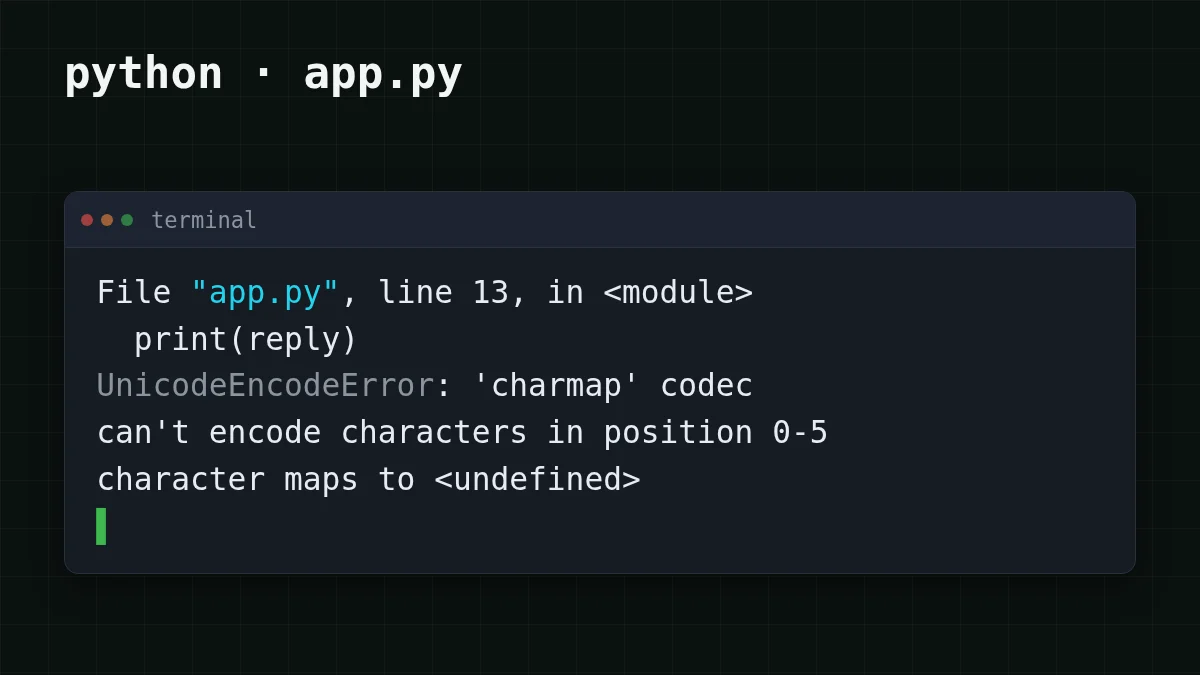
Warum passiert das? print wandelt den Text mit der Kodierung von sys.stdout in Bytes um. Wenn diese Kodierung eine Legacy-Codepage ist, hat jedes Zeichen außerhalb davon, etwa Kyrillisch in einer westlichen Codepage, ein Emoji, manchmal ein typografischer Gedankenstrich, kein Byte, in das es umgewandelt werden kann. Python löst einen Fehler aus, statt zu raten.
Es tritt in drei Situationen auf:
- stdout wird umgeleitet oder in eine Pipe geschrieben (
python app.,py > out. txt | another program), oder das Skript läuft aus einem Scheduler, CI oder Editor, wo stdout keine Konsole ist; PYTHONLEGACYWINDOWSSTDIOist gesetzt, oder der Stream bekommt anderweitig eine enge Kodierung;- du schreibst die Antwort mit
open(path, "w")und ohneencoding=in eine Datei.
Welches Python? Alles Folgende betrifft Python 3.7–3.14, wo die Stream- und Dateikodierung vom System kommen. Laut PEP 686 (Status Final, https://peps.python.org/pep-0686/, geprüft am 5. November 2026) ist der UTF-8-Modus ab Python 3.15 standardmäßig an, sodass open() und stdio dort bereits UTF-8 verwenden, es sei denn, jemand hat es mit PYTHONUTF8=0 oder -X utf8=0 abgeschaltet. Prüfe es mit python --version.
Prüfe, welche Kodierung du tatsächlich hast#
Bevor du etwas änderst, schau nach, was Python gewählt hat. Das dauert zehn Sekunden.
Probier es selbstProbier es aus: Was hält Python für deine stdout-Kodierung?Antwort anzeigen
Führe python - im selben Fenster aus, in dem das Skript fehlschlägt. In einer interaktiven Konsole gibt es meist utf-8 aus, das allein beweist also wenig. Führe es erneut mit > check.txt am Ende aus und öffne die Datei: Umgeleitete Ausgabe liefert häufiger einen cp…-Namen oder ascii, und das ist dein Übeltäter. Wenn alles utf-8 sagt, schau dir eine Datei an, in die du schreibst.
Willst du den Absturz sehen, ohne auf einen schlechten Tag zu warten? Erzwinge unter macOS oder Linux für einen Lauf eine enge Kodierung:
PYTHONIOENCODING=ascii python -c "print('Привет')"Das schlägt mit einer ascii-Codec-Meldung fehl, aus derselben Familie wie der obige Fehler. Unter Windows wird die Variable für eine interaktive Konsole ignoriert, funktioniert aber bei umgeleiteter Ausgabe: Führe in cmd set PYTHONIOENCODING=ascii aus, dann python - (in PowerShell: $env:PYTHONIOENCODING = "ascii").
Fix 1: UTF-8-Modus einschalten#
Python hat einen Modus, der UTF-8 zum Standard für Text macht. Laut den Python-Docs (Seite zur Kommandozeile, geprüft am 5. November 2026) schaltet PYTHONUTF8=1 ihn ein und -X utf8 bewirkt dasselbe; beides gibt es seit Python 3.7. Ein Haken aus derselben Quelle: Jeder andere nicht-leere Wert von PYTHONUTF8 verursacht einen Fehler beim Start, verwende also genau 1 (oder 0 zum Ausschalten). Unter 3.15 brauchst du das nur, um den Modus bei älteren Interpretern explizit einzuschalten; wenn er dort schon an ist, suche in deiner Umgebung nach PYTHONUTF8=0.
UTF-8-Modus für einen Lauf einschalten
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
PYTHONUTF8=1 python app.pyKeine Codeänderungen, und es deckt in diesem Lauf die Konsole, Umleitungen und Dateien ab. Wenn du nicht jedes Mal eine Variable setzen willst, liefert python - dasselbe Ergebnis von der Kommandozeile aus.
Es gibt auch PYTHONIOENCODING=utf-, das nur die Kodierung von stdin, stdout und stderr überschreibt. Lies den Docs-Eintrag dazu, bevor du dich unter Windows darauf verlässt: Seit Python 3.6 wird es für einen interaktiven Konsolenpuffer ignoriert, es sei denn, PYTHONLEGACYWINDOWSSTDIO ist gesetzt. Umgeleitete Dateien und Pipes sind von dieser Ausnahme nicht betroffen. Es kann also python app. beheben und im Konsolenfenster trotzdem nichts bewirken. Für stderr ist der Error-Handler immer backslashreplace.
Fix 2: stdout im Skript neu konfigurieren#
Wenn du nicht kontrollieren kannst, wie Leute das Skript starten, ändere den Stream selbst ganz oben:
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)
reconfigure ist für io.TextIOWrapper dokumentiert (hinzugefügt in 3.7). Wenn du encoding übergibst und errors weglässt, ist der Handler strict, sodass ein Zeichen, das nicht passt, weiterhin einen Fehler auslöst; im häufigen Fall von UTF-8 bleibt nichts übrig. Zwei Details aus den Docs: Die Kodierung kann nicht geändert werden, sobald Daten aus dem Stream gelesen wurden (nach einem Schreibvorgang geht es), und encoding="locale" wird seit 3.11 unterstützt.
Muss das Skript niemals abstürzen, selbst auf einem Terminal, das den Text wirklich nicht anzeigen kann? Füge errors="replace" hinzu. Unbekannte Zeichen erscheinen dann als ?, statt den Lauf zu stoppen. Das verdeckt das Problem, statt es zu beheben, also behalte es für Logs.
Fix 3: Dateien eine explizite Kodierung geben#
Eine Antwort zu speichern ist derselbe Fehler, nur im Code unauffälliger:
# before: on Python up to 3.14 this uses the system's default encoding
with open("reply.txt", "w") as f:
    f.write(reply)

# after: the file is UTF-8 on every machine
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
Verwende dieselbe encoding="utf-8", wenn du die Datei wieder einliest, sonst kann der Text stattdessen beim Einlesen kaputtgehen.
Welchen Fix solltest du verwenden?#
Wähle deinen Fall
Wähle deinen Fall
Wähle eine Option, um die Antwort zu sehen
Ich führe mein eigenes Skript in einem Terminal aus
Setze PYTHONUTF8=1 einmal in deiner Umgebung, oder starte mit python -. Am Code ändert sich nichts.
Ich gebe das Skript an andere weiter
Setze sys. ganz oben, damit es funktioniert, egal wie sie es starten.
Der Absturz betrifft eine Datei, nicht den Bildschirm
Füge encoding="utf-8" zu open() hinzu, zum Schreiben und Lesen.
Du kannst sie kombinieren. Ein Skript, das Antworten ausgibt und speichert, braucht Fix 2 oder Fix 1 für den Bildschirm und Fix 3 für die Datei.
Wenn es immer noch fehlschlägt#
- Der Fehler ist an eine andere Zeile gewandert. Dann ist der fehlschlagende Aufruf ein weiteres
printoderwrite; der Fix muss vor dessen Ausführung greifen, also setzereconfigureganz oben. - Der Fehler erwähnt
PYTHONUTF8. Die Variable hat einen anderen Wert als1oder0. Entferne sie und setze sie erneut. - Kein Absturz, aber du siehst Kästchen oder
?in der Konsole. Python hat gültiges UTF-8 geschrieben; die Konsolenschrift oder Codepage kann es nicht anzeigen. Leite in eine Datei um und öffne die Datei in einem Editor, um zu bestätigen, dass die Antwort intakt ist. - Der Fehler ist ein
JSONDecodeError, nichtUnicodeEncodeError. Anderes Problem: siehe wie man JSON aus einer Modellantwort extrahiert.
Der obige Anfragecode ist der einfache requests-Aufruf; die CheapTokens-Docs zeigen denselben Aufruf für das OpenAI SDK. Ein anderes Modell funktioniert mit demselben Fix: Ersetze das Feld model durch zai- (bis zu 8.192 Ausgabe-Tokens pro Antwort, 390K Kontext). Der Kodierungsfehler hat nichts mit dem Modell zu tun, nur damit, wohin der Text geht.


