Rozwiązywanie problemówPrzewodnik
UnicodeEncodeError przy wypisywaniu odpowiedzi LLM w Pythonie: 3 poprawki
print(reply) pada na cyrylicy lub emoji? Zobacz, dlaczego Python zawodzi przy przekierowanym wyjściu lub starszej stronie kodowej, i napraw to trybem UTF-8, reconfigure lub encoding=.
Na tej stronie
Twoje żądanie przeszło, model odpowiedział, a potem Python padł na print(reply). To nie wina API. Odpowiedź jest w porządku; miejsce, do którego ją wypisujesz, nie potrafi przedstawić niektórych jej znaków. Najszybsza poprawka to włączenie trybu UTF-8 przez PYTHONUTF8=1. Jeśli wolisz trzymać to w skrypcie, wywołaj sys. na górze, a gdy zapisujesz odpowiedź do pliku, przekaż encoding="utf-8" do open().
Jak wygląda błąd#
Załóżmy, że zadajesz modelowi pytanie po rosyjsku i wypisujesz odpowiedź. To cały skrypt, korzystający z zwykłego wywołania requests z naszego przewodnika po pierwszym żądaniu:
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
Gdy stdout jest przekierowany do pliku lub potoku, albo Python został uruchomiony ze starszą stroną kodową dla swoich strumieni, ostatnia linia kończy się tak:
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>Nazwa kodeka w komunikacie zależy od kodowania strumienia (dla strony kodowej Windows to zwykle charmap, dla ascii to ascii), a pozycje zależą od odpowiedzi. Kształt jest zawsze ten sam: traceback wskazuje na print, a nie na żądanie.
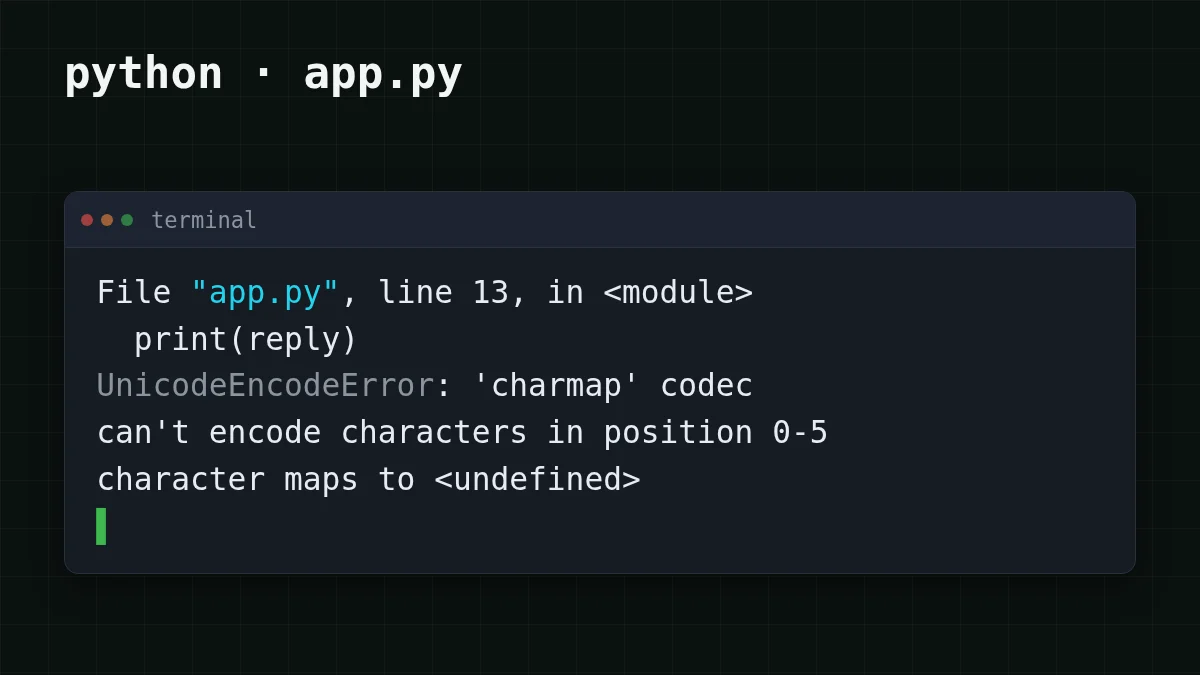
Dlaczego tak się dzieje? print konwertuje tekst na bajty, używając kodowania sys.stdout. Jeśli to kodowanie to starsza strona kodowa, każdy znak spoza niej, taki jak cyrylica w zachodniej stronie kodowej, emoji, czasem typograficzny myślnik, nie ma bajtu, w który można go zamienić. Python zgłasza wyjątek zamiast zgadywać.
Pojawia się w trzech sytuacjach:
- stdout jest przekierowany lub podłączony do potoku (
python app.,py > out. txt | another program), albo skrypt działa z harmonogramu, CI lub edytora, gdzie stdout nie jest konsolą; - ustawiono
PYTHONLEGACYWINDOWSSTDIO, albo strumień z innego powodu dostaje wąskie kodowanie; - zapisujesz odpowiedź do pliku przez
open(path, "w")bezencoding=.
Który Python? Wszystko poniżej dotyczy Pythona 3.7–3.14, gdzie kodowanie strumieni i plików pochodzi z systemu. Zgodnie z PEP 686 (status Final, https://peps.python.org/pep-0686/, sprawdzone 5 listopada 2026) tryb UTF-8 jest domyślnie włączony od Pythona 3.15, więc open() i stdio używają tam już UTF-8, chyba że ktoś go wyłączył przez PYTHONUTF8=0 lub -X utf8=0. Sprawdź przez python --version.
Sprawdź, jakie kodowanie faktycznie masz#
Zanim cokolwiek zmienisz, zobacz, co wybrał Python. To zajmuje dziesięć sekund.
Spróbuj samWypróbuj: jakie według Pythona jest kodowanie twojego stdout?Pokaż odpowiedź
Uruchom python - w tym samym oknie, w którym skrypt zawodzi. W konsoli interaktywnej zwykle wypisuje utf-8, więc samo to niewiele dowodzi. Uruchom to ponownie z > check.txt na końcu i otwórz plik: przekierowane wyjście to to, co częściej daje nazwę cp… lub ascii, i to jest twój winowajca. Jeśli wszystko mówi utf-8, sprawdź plik, do którego zapisujesz.
Chcesz zobaczyć awarię bez czekania na zły dzień? Na macOS lub Linuksie wymuś wąskie kodowanie dla jednego uruchomienia:
PYTHONIOENCODING=ascii python -c "print('Привет')"To kończy się komunikatem o kodeku ascii, z tej samej rodziny co błąd powyżej. W Windows zmienna jest ignorowana dla konsoli interaktywnej, ale działa, gdy wyjście jest przekierowane: w cmd uruchom set PYTHONIOENCODING=ascii, potem python - (w PowerShell: $env:PYTHONIOENCODING = "ascii").
Poprawka 1: włącz tryb UTF-8#
Python ma tryb, który czyni UTF-8 domyślnym dla tekstu. Zgodnie z dokumentacją Pythona (strona wiersza poleceń, sprawdzona 5 listopada 2026) PYTHONUTF8=1 go włącza, a -X utf8 robi to samo; oba istnieją od Pythona 3.7. Jeden haczyk z tej samej strony: każda inna niepusta wartość PYTHONUTF8 powoduje błąd przy starcie, więc używaj dokładnie 1 (albo 0, by go wyłączyć). W 3.15 potrzebujesz tego tylko, by jawnie włączyć tryb na starszych interpreterach; jeśli tam już jest włączony, poszukaj PYTHONUTF8=0 w swoim środowisku.
Włącz tryb UTF-8 dla jednego uruchomienia
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
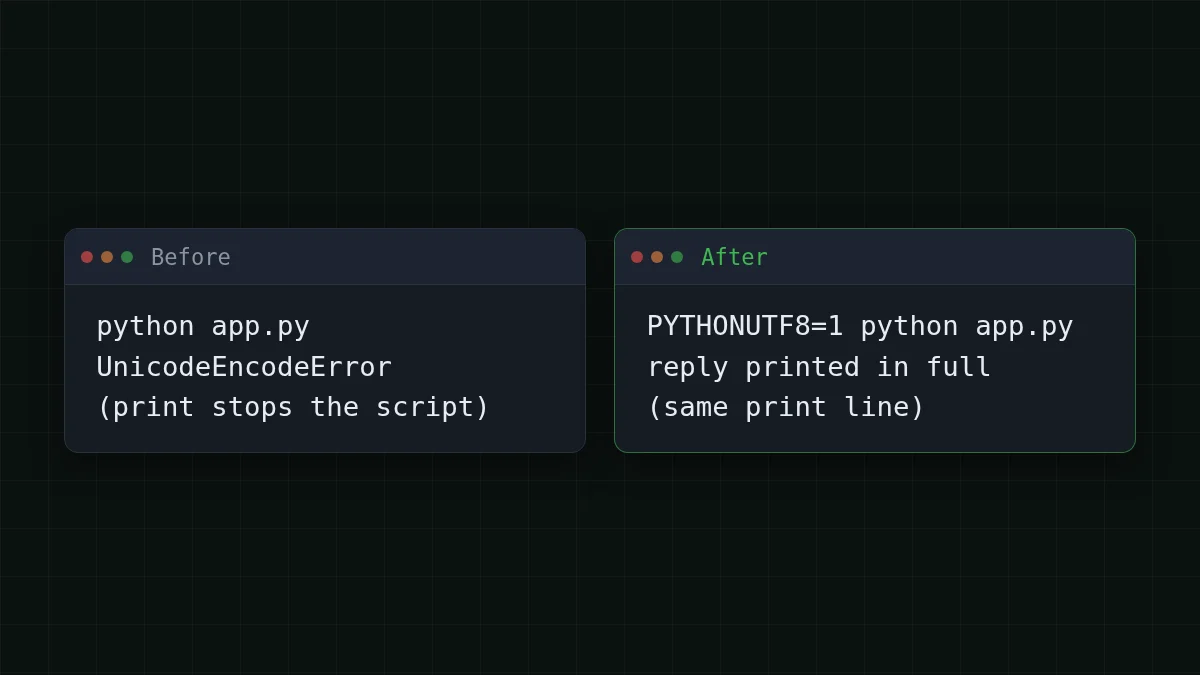
PYTHONUTF8=1 python app.pyBez zmian w kodzie, a obejmuje konsolę, przekierowania i pliki w tym uruchomieniu. Jeśli nie chcesz ustawiać zmiennej za każdym razem, python - daje ten sam wynik z wiersza poleceń.
Jest też PYTHONIOENCODING=utf-, który nadpisuje kodowanie tylko stdin, stdout i stderr. Przeczytaj jego wpis w dokumentacji, zanim polegasz na nim w Windows: od Pythona 3.6 jest ignorowany dla interaktywnego bufora konsoli, chyba że ustawiono PYTHONLEGACYWINDOWSSTDIO. Przekierowane pliki i potoki nie podlegają temu wyjątkowi. Więc może naprawić python app. i nadal nic nie robić w oknie konsoli. Dla stderr handler błędów to zawsze backslashreplace.
Poprawka 2: przekonfiguruj stdout wewnątrz skryptu#
Jeśli nie kontrolujesz, jak ludzie uruchamiają skrypt, zmień sam strumień na samym początku:
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)
reconfigure jest udokumentowany dla io.TextIOWrapper (dodany w 3.7). Gdy przekażesz encoding i pominiesz errors, handler to strict, więc znak, który się nie mieści, nadal zgłasza wyjątek; w typowym przypadku UTF-8 nic nie zostaje. Dwa szczegóły z dokumentacji: kodowania nie można zmienić po odczytaniu danych ze strumienia (można po zapisie), a encoding="locale" jest obsługiwany od 3.11.
Potrzebujesz, by skrypt nigdy nie padał, nawet na terminalu, który naprawdę nie potrafi pokazać tekstu? Dodaj errors="replace". Nieznane znaki pojawiają się wtedy jako ? zamiast zatrzymywać uruchomienie. To ukrywa problem, a nie go naprawia, więc trzymaj to dla logów.
Poprawka 3: nadaj plikom jawne kodowanie#
Zapisywanie odpowiedzi to ta sama awaria, tylko cichsza w kodzie:
# before: on Python up to 3.14 this uses the system's default encoding
with open("reply.txt", "w") as f:
    f.write(reply)

# after: the file is UTF-8 on every machine
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
Użyj tego samego encoding="utf-8", gdy odczytujesz plik z powrotem, inaczej tekst może się zepsuć przy wczytywaniu.
Której poprawki powinieneś użyć?#
Wybierz swój przypadek
Wybierz swój przypadek
Wybierz opcję, aby zobaczyć odpowiedź
Uruchamiam własny skrypt w terminalu
Ustaw PYTHONUTF8=1 raz w swoim środowisku albo uruchamiaj z python -. Nic w kodzie się nie zmienia.
Wysyłam skrypt innym ludziom
Umieść sys. na górze, żeby działał niezależnie od tego, jak go uruchomią.
Awaria dotyczy pliku, nie ekranu
Dodaj encoding="utf-8" do open(), przy zapisie i odczycie.
Możesz je łączyć. Skrypt, który wypisuje i zapisuje odpowiedzi, potrzebuje Poprawki 2 lub Poprawki 1 dla ekranu i Poprawki 3 dla pliku.
Jeśli nadal zawodzi#
- Błąd przeniósł się do innej linii. Wtedy zawodzące wywołanie to inne
printlubwrite; poprawka musi zadziałać przed nim, więc umieśćreconfigurena samym początku. - Błąd wspomina
PYTHONUTF8. Zmienna ma wartość inną niż1lub0. Usuń ją i ustaw ponownie. - Brak awarii, ale widzisz kwadraty lub
?w konsoli. Python zapisał poprawny UTF-8; czcionka lub strona kodowa konsoli nie potrafi go wyświetlić. Przekieruj do pliku i otwórz plik w edytorze, by potwierdzić, że odpowiedź jest nienaruszona. - Błąd to
JSONDecodeError, nieUnicodeEncodeError. Inny problem: zobacz jak wyodrębnić JSON z odpowiedzi modelu.
Powyższy kod żądania to zwykłe wywołanie requests; dokumentacja CheapTokens pokazuje to samo wywołanie dla OpenAI SDK. Inny model działa z tą samą poprawką: zamień pole model na zai- (do 8192 tokenów wyjściowych na odpowiedź, kontekst 390K). Błąd kodowania nie ma nic wspólnego z modelem, tylko z tym, dokąd trafia tekst.


