トラブルシューティングガイド
Python で LLM の返答を print すると UnicodeEncodeError: 3つの修正
print(reply) がキリル文字や絵文字でクラッシュ? リダイレクト出力やレガシーコードページで Python が失敗する理由と、UTF-8 モード、reconfigure、encoding= による修正方法を解説。
このページの内容
リクエストは通り、モデルも回答したのに、そのあと Python が print(reply) で落ちた。API 側の問題ではない。返答自体は正常で、出力先がその文字の一部を表現できないだけだ。最短の修正は PYTHONUTF8=1 で UTF-8 モードを有効にすること。スクリプト内で完結させたいなら先頭で sys. を呼び、返答をファイルに保存するときは open() に encoding="utf-8" を渡す。
エラーの見え方#
モデルにロシア語で質問して回答を print するとしよう。スクリプト全体はこうだ。最初のリクエストガイドの素の requests 呼び出しを使っている:
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
stdout がファイルやパイプにリダイレクトされている場合、または Python がストリームにレガシーコードページで起動された場合、最後の行はこう終わる:
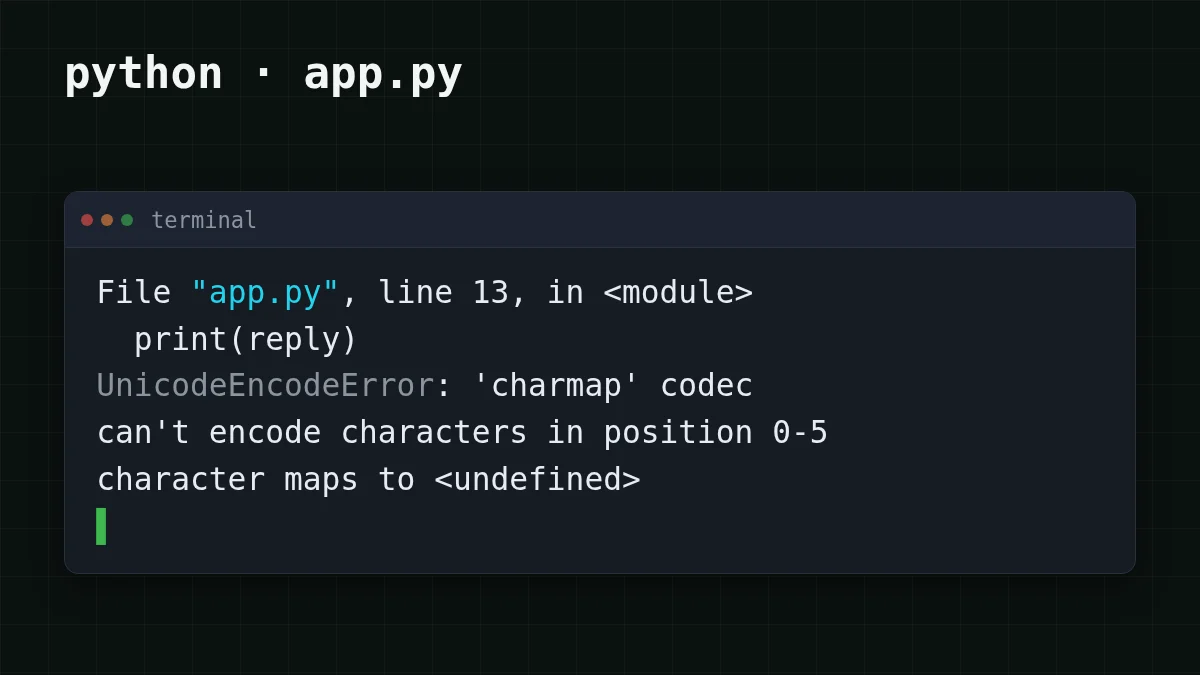
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>メッセージ中のコーデック名はストリームのエンコーディングに依存し(Windows のコードページなら通常 charmap、ascii なら ascii)、位置は返答次第だ。形はいつも同じで、トレースバックはリクエストではなく print を指す。
なぜ起きるのか? print は sys.stdout のエンコーディングを使ってテキストをバイトに変換する。そのエンコーディングがレガシーコードページなら、西欧のコードページにおけるキリル文字、絵文字、時にはタイポグラフィックなダッシュなど、その外側の文字は変換すべきバイトを持たない。Python は推測せずに例外を送出する。
現れるのは次の3つの状況だ:
- stdout がリダイレクトまたはパイプされている(
python app.、py > out. txt | another program)、あるいはスクリプトが stdout のコンソールでないスケジューラ、CI、エディタから実行されている; PYTHONLEGACYWINDOWSSTDIOが設定されている、またはストリームが何らかの理由で狭いエンコーディングになっている;open(path, "w")でencoding=なしに返答をファイルに書き込んでいる。
どの Python? 以下はすべて Python 3.7–3.14 の話で、ストリームとファイルのエンコーディングはシステムから来る。PEP 686(ステータス Final、https://peps.python.org/pep-0686/, 確認日 2026年11月5日)によれば、UTF-8 モードは Python 3.15 からデフォルトで有効なので、誰かが PYTHONUTF8=0 や -X utf8=0 で無効にしていない限り、そこでは open() と stdio はすでに UTF-8 を使う。python --version で確認できる。
実際のエンコーディングを確認する#
何かを変える前に、Python が何を選んだかを見よう。10秒で済む。
自分で試す試してみよう: Python は stdout のエンコーディングを何だと思っている?答えを表示
スクリプトが失敗するのと同じウィンドウで python - を実行する。対話型コンソールでは通常 utf-8 と表示されるので、それだけではほとんど証明にならない。末尾に > check.txt を付けて再度実行し、ファイルを開く: リダイレクトされた出力のほうが cp… 名や ascii になりやすく、それが犯人だ。すべてが utf-8 と言うなら、書き込むファイルを見よう。
悪い日を待たずにクラッシュを見たい? macOS や Linux なら、1回の実行だけ狭いエンコーディングを強制できる:
PYTHONIOENCODING=ascii python -c "print('Привет')"これは ascii コーデックのメッセージで失敗し、上のエラーと同じ系統だ。Windows では対話型コンソールではこの変数は無視されるが、出力がリダイレクトされていれば機能する: cmd で set PYTHONIOENCODING=ascii を実行し、次に python -(PowerShell では $env:PYTHONIOENCODING = "ascii")。
修正1: UTF-8 モードを有効にする#
Python にはテキストのデフォルトを UTF-8 にするモードがある。Python ドキュメント(コマンドラインのページ、確認日 2026年11月5日)によれば、PYTHONUTF8=1 で有効になり -X utf8 も同じ。どちらも Python 3.7 から存在する。同じページの注意点: PYTHONUTF8 の他の空でない値は起動時にエラーになるので、正確に 1(または無効にするなら 0)を使う。3.15 では古いインタプリタでモードを明示的に有効にする場合にだけ必要で、すでに有効なら環境に PYTHONUTF8=0 がないか探そう。
1回の実行で UTF-8 モードを有効にする
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
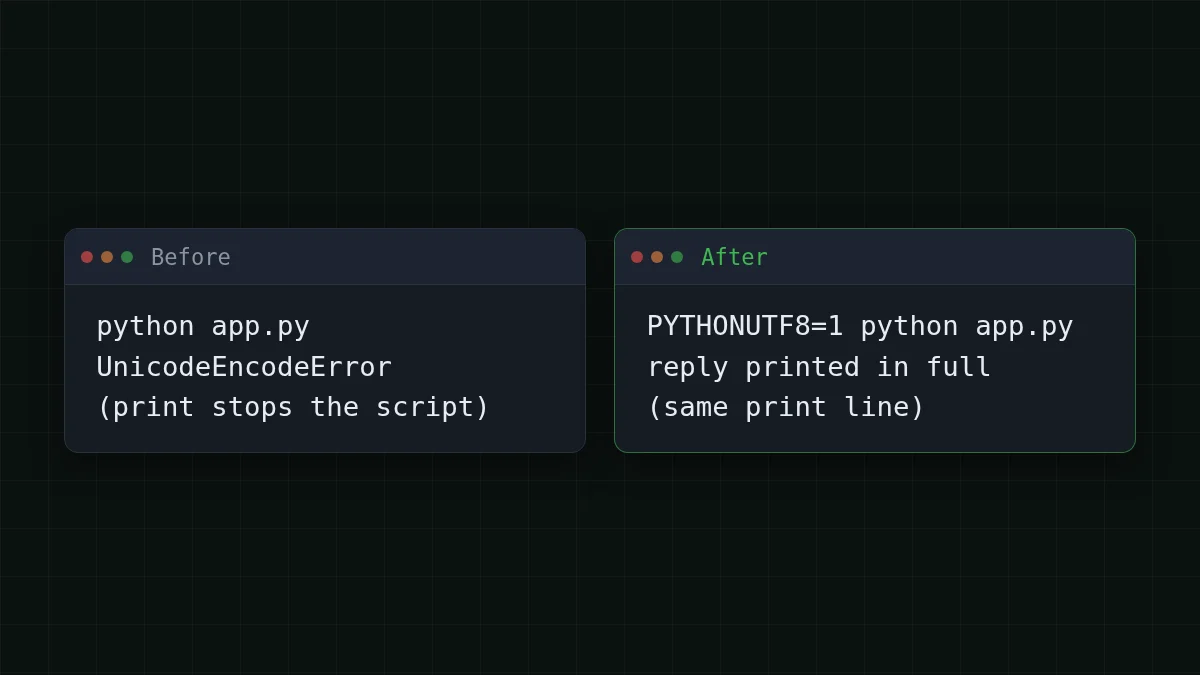
PYTHONUTF8=1 python app.pyコード変更は不要で、その実行におけるコンソール、リダイレクト、ファイルをカバーする。毎回変数を設定したくなければ、python - でコマンドラインから同じ結果が得られる。
stdin、stdout、stderr のエンコーディングだけを上書きする PYTHONIOENCODING=utf- もある。Windows で頼る前にドキュメントの項目を読もう: Python 3.6 以降、PYTHONLEGACYWINDOWSSTDIO が設定されていない限り対話型コンソールバッファでは無視される。リダイレクトされたファイルやパイプはこの例外の影響を受けない。つまり python app. は直せてもコンソールウィンドウでは何もしないことがある。stderr のエラーハンドラは常に backslashreplace だ。
修正2: スクリプト内で stdout を再設定する#
人々がスクリプトをどう起動するか制御できないなら、ストリーム自体を先頭で変える:
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)
reconfigure は io.TextIOWrapper 用にドキュメント化されている(3.7 で追加)。encoding を渡して errors を省略するとハンドラは strict になるので、収まらない文字は依然として例外を送出する。UTF-8 という一般的なケースでは残るものはない。ドキュメントの2つの詳細: エンコーディングはストリームからデータを読んだ後は変更できない(書き込み後なら可能)、encoding="locale" は 3.11 からサポートされている。
本当にテキストを表示できない端末でも、スクリプトを決してクラッシュさせたくない? errors="replace" を追加する。不明な文字は実行を止める代わりに ? として現れる。これは問題を直すのではなく隠すので、ログ用に取っておこう。
修正3: ファイルに明示的なエンコーディングを与える#
返答の保存も同じ失敗で、コード上はより静かなだけだ:
# before: on Python up to 3.14 this uses the system's default encoding
with open("reply.txt", "w") as f:
    f.write(reply)

# after: the file is UTF-8 on every machine
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
ファイルを読み戻すときも同じ encoding="utf-8" を使う。そうしないと、今度は読み込み側でテキストが壊れることがある。
どの修正を使うべきか?#
ケースを選ぶ
ケースを選ぶ
オプションを選択して答えを表示
自分のスクリプトをターミナルで実行する
環境に PYTHONUTF8=1 を一度設定するか、python - で起動する。コードは何も変わらない。
スクリプトを他の人に配布する
先頭に sys. を置けば、どう起動されても動く。
クラッシュが画面ではなくファイルで起きる
書き込みと読み込みの両方で open() に encoding="utf-8" を追加する。
組み合わせてもよい。返答を print して保存するスクリプトには、画面用に修正2か修正1、ファイル用に修正3が必要だ。
それでも失敗する場合#
- エラーが別の行に移った。 失敗している呼び出しは別の
printかwriteだ。修正はそれが実行される前に適用される必要があるので、reconfigureを先頭に置く。 - エラーが
PYTHONUTF8に言及している。 変数に1でも0でもない値が入っている。削除して設定し直す。 - クラッシュしないが、コンソールに四角や
?が見える。 Python は有効な UTF-8 を書き込んだが、コンソールのフォントやコードページが表示できない。ファイルにリダイレクトしてエディタで開き、返答が無傷であることを確認する。 - エラーが
UnicodeEncodeErrorではなくJSONDecodeErrorだ。 別の問題: モデルの返答から JSON を抽出する方法を参照。
上のリクエストコードは素の requests 呼び出しだ。CheapTokens ドキュメントには OpenAI SDK 用の同じ呼び出しが載っている。別のモデルでも同じ修正で動く: model フィールドを zai- に置き換える(回答あたり最大 8,192 出力トークン、390K コンテキスト)。エンコーディングエラーはモデルとは無関係で、テキストの行き先だけに関係する。


