トラブルシューティングガイド
LLMの返信でjson.JSONDecodeError: PythonでJSONを抽出する
モデルの返信でjson.loadsが失敗する? exc.posとfinish_reasonを読んで原因を特定し、raw_decodeでJSONを抽出して一度だけリトライする。
このページの内容
スクリプトがモデルにJSONを要求し、json.を呼び出してjson.で落ちる。たいていの場合、モデルは実際に答えている。JSONを```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder.で包み、何も救えなければ一度だけリトライする。
返信がjson.loadsを壊す3つのパターン#
Pythonのjsonドキュメント(Python 3.15 docs、2026年11月2日確認)によると、JSONDecodeErrorはValueErrorのサブクラスで、属性msg、doc、pos、lineno、colnoを持つ。ここで重要なのはposだ。文字列内でパースが失敗したインデックスを表す。
スクリプトが顧客メールからフィールドを抽出し、{"name": .を要求するとしよう。次の3つの文字列が、それを壊す返信だ。Pythonシェルに貼り付けてみてほしい:
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
print(exc.pos, len(reply))最初の2つはpos 0で失敗する。パーサーは最初の文字、つまりバッククォートかSを見て諦めたのだ。3つ目は文字列の末尾で失敗する(posがlen(reply)と等しい)。読んだ内容はすべて正しかったが、そこでテキストが尽きた。この違いが診断になる。位置0ならJSONはおそらくそこにあり、単に包まれているだけだ。末尾なら回答が途中で止まっている。
途中で切れた回答: パースする前にfinish_reasonを確認する#
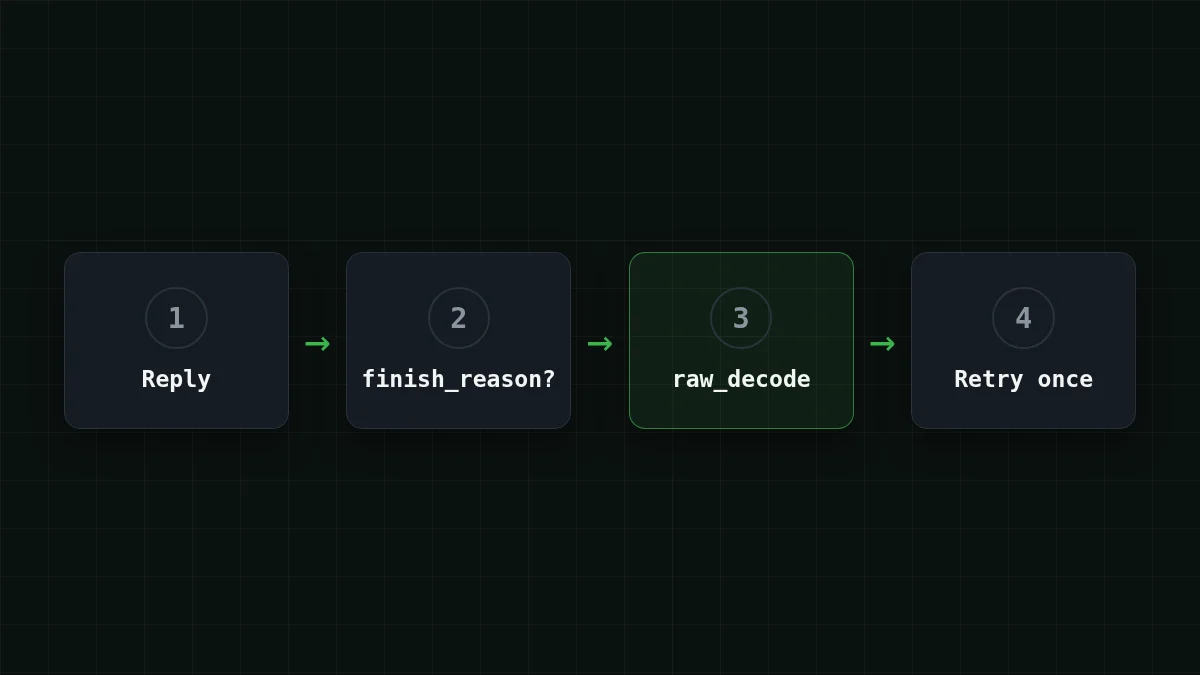
途中で止まった返信はパースの問題ではなく、長さの問題だ。APIが教えてくれる。choiceにfinish_reasonがあり、"length"は回答がmax_tokensで切られたことを意味する(詳細はAIの回答が途中で切れた? finish_reason "length"とmax_tokensを修正するを参照)。抽出の前に、まずこれを確認しよう。
この手順を飛ばすと厄介な罠がある。最初にパース可能な{を探すスキャナーは、半分しか完成していない外側のオブジェクトから完全な内側のオブジェクトを拾い上げてしまい、スクリプトはエラーも出さずに間違ったデータで処理を続けてしまう。試してみよう:
自分で試す試してみよう: この切れた返信に対して「最初のオブジェクトを見つける」関数は何を返すだろうか?答えを表示
'{"user": {"name": "Anna"}, "age": 31'を取る。外側のオブジェクトは決して閉じないが、内側の{"name": "Anna"}は完全なので、下の抽出器は{'name': 'Anna'}を返す。例外は出ず、結果は間違いだ。だからこそfinish_reasonのチェックを抽出の前に置く。
本当に切れた場合の修正は余裕を増やすこと、つまりmax_tokensを上げることだ。DeepSeek-V4-Flashは回答あたり最大32,768出力トークン、GLM-5.3-Flashは最大8,192なので、長いJSONリストは前者のほうが余裕がある。モデルの詳細はCheapTokensのモデルページにある。
テキストからJSONを取り出す#
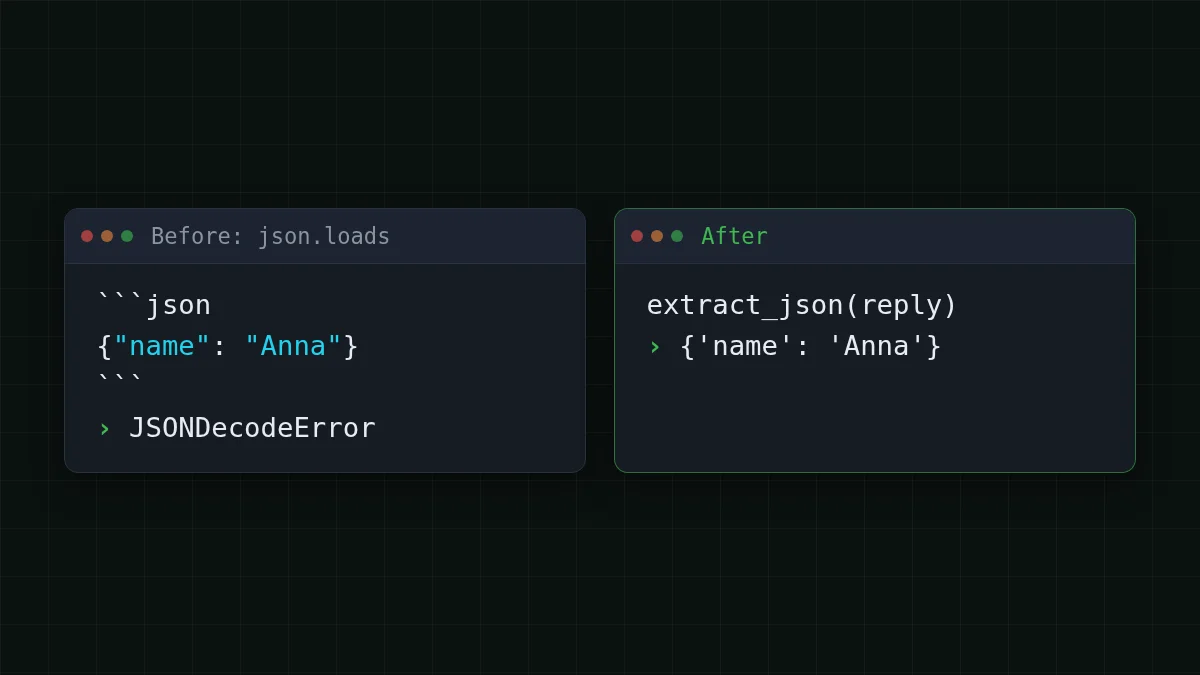
フェンスや余計な文言には、標準ライブラリにすでに道具がある。同じPythonのページによると、JSONDecoder.はJSONドキュメントで始まる文字列からドキュメントをデコードし、オブジェクトとドキュメントが終わったインデックスを返す。ドキュメントには、末尾に余計なデータがある文字列にも使えると書かれている。ドキュメントが最初の文字から始まる必要があるので、先頭のテキストをまず切り落とす。{を探し、そこからデコードを試み、失敗したら次の{へ進む。
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
これはフェンス(先頭の```json is skipped because it is not a {), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1]は「see note [1]」のような文では有効なJSONであり、勝ってしまう。
意図的にやらないことが2つある。テキストを決して編集しない(バッククォートを削除する正規表現も、欠けた括弧を推測することもしない)ので、壊れた返信を有効だが間違ったデータに変えることはできない。そして見つけるものが何もないときは大きな音を立てて失敗する。これが下のリトライに必要なことだ。
より厳しいプロンプトで一度だけリトライする#
返信が切れていたり、オブジェクトがまったく含まれていなければ、もう一度尋ねる。一度だけであり、無限ループにはしない。切れている場合は2回目の試行に余裕を持たせ、そうでなければ欲しいものをはっきり伝える。これはOpenAI Python SDKをCheapTokensのベースURL(https:/)に対して使い、ドキュメントにある完全なモデルIDを使う。キーは環境変数に入っている。
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
raise ValueError('no valid JSON after one retry')順序が要点だ。まずfinish_reason、次に抽出、そしてようやくリトライだ。2回目の試行の後にエラーを送出すれば、バッチジョブはその項目をログに残して次へ進める。
リトライのコストは簡単に見積もれる。入力1,200トークン、出力300トークンのリクエストを仮定しよう(あくまで仮定なので自分の数値を使うこと): DeepSeek-V4-Flashで$0.000048、GLM-5.3-Flashで$0.000036。1,000件のうち30件が2回目の試行を必要とするなら、追加の請求は30 × そのリクエスト分、DeepSeek-V4-Flashで$0.0014だ。価格は変動するので、現在の価格表から取得している。
順番に並べる
修復手順を順番に並べる
項目をドラッグするか矢印を使う
- finish_reasonを確認する: lengthならここで止める
- 最初の{を見つけ、その前のテキストを切り落とす
- raw_decodeでデコードし、後続は無視する
- 何も見つからなければ、より厳しいプロンプトで一度だけリトライする
どの症状にどの修正#
上の手順は次の奇妙なエラーが出るまで頭に入る。これは調べ表と同じだ。画面に見えるものを見つけ、修正を読む。
ケースを選ぶ
見えるものを選ぶ
オプションを選択して答えを表示
json.loadsがpos 0で失敗する
返信がフェンスか文章で始まっている。extract_jsonを通せばよく、リトライは不要だ。
posが文字列の末尾にある
回答が途中で止まっている。finish_reasonを確認する: lengthならmax_tokensを上げて、もう一度尋ねる。
エラーが途中のどこかにある
モデル自身が壊れたJSONを書いている(カンマの欠落、末尾のカンマ、エスケープされていない引用符)。修正せず、より厳しいプロンプトで一度だけリトライし、また失敗したら返信をログに残す。
json.loadsは通るがキーが欠けている
パースは問題なく、内容が問題だ。プロンプトに正確なキーを列挙し、パース後にコードで確認する。
APIは有効なJSONを強制できるか?#
できることもある。OpenAIのstructured outputsガイドには2つのモードが記載されている: JSONモード(type: json_)は有効なJSONを返すがスキーマには従わず、Structured Outputs(type: json_、strict: true)はスキーマに従う。OpenAIは可能な限り後者を推奨している(出典: developers.openai.com、2026年11月2日確認)。これらはOpenAI自身のAPIオプションだ。別のエンドポイントでresponse_formatに頼る前に、CheapTokensのドキュメントを確認しよう。上の抽出とリトライは通常のchat completionsで動作し、特別なパラメータは不要だ。リクエスト側のオプションについてはLLM APIから有効なJSONを得る: response_formatとリトライで詳しく扱っている。
パーサーを出荷する前に4つ確認しよう: テキストをパースする前にfinish_reasonを読んでいるか、リトライは一度だけか(そして2回目の失敗は項目IDとともにログに残しているか)、パース後に期待するキーが存在することをコードで確認しているか、max_tokensが想定する最長のJSONに余裕を残しているか。
次にjson.loadsが投げられたら、まずexc.posとfinish_reasonを出力しよう。この2つの数値は、返信を一行読む前に何が起きたかをたいてい教えてくれる。


