문제 해결가이드
LLM 응답에서 json.JSONDecodeError: Python에서 JSON 추출하기
모델 응답에서 json.loads가 실패하나요? exc.pos와 finish_reason을 읽어 원인을 찾고, raw_decode로 JSON을 추출한 뒤 한 번 재시도하세요.
이 페이지의 내용
스크립트가 모델에 JSON을 요청하고, json.를 호출했다가 json.로 죽습니다. 보통은 모델이 답을 했습니다. 다만 JSON을 ```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder.로 감쌌을 뿐이고, 아무것도 살릴 수 없으면 한 번 재시도하세요.
응답이 json.loads를 깨뜨리는 세 가지 방식#
Python의 json 문서(Python 3.15 문서, 2026년 11월 2일 확인)에 따르면 JSONDecodeError은 ValueError의 서브클래스이며 msg, doc, pos, lineno, colno 속성을 가집니다. 여기서 중요한 것은 pos입니다. 문자열에서 파싱이 실패한 인덱스입니다.
스크립트가 고객 이메일에서 필드를 뽑아내고 {"name": .를 요청한다고 해봅시다. 다음 세 문자열이 그것을 깨뜨리는 응답입니다. Python 셸에 붙여 넣어 보세요:
import json

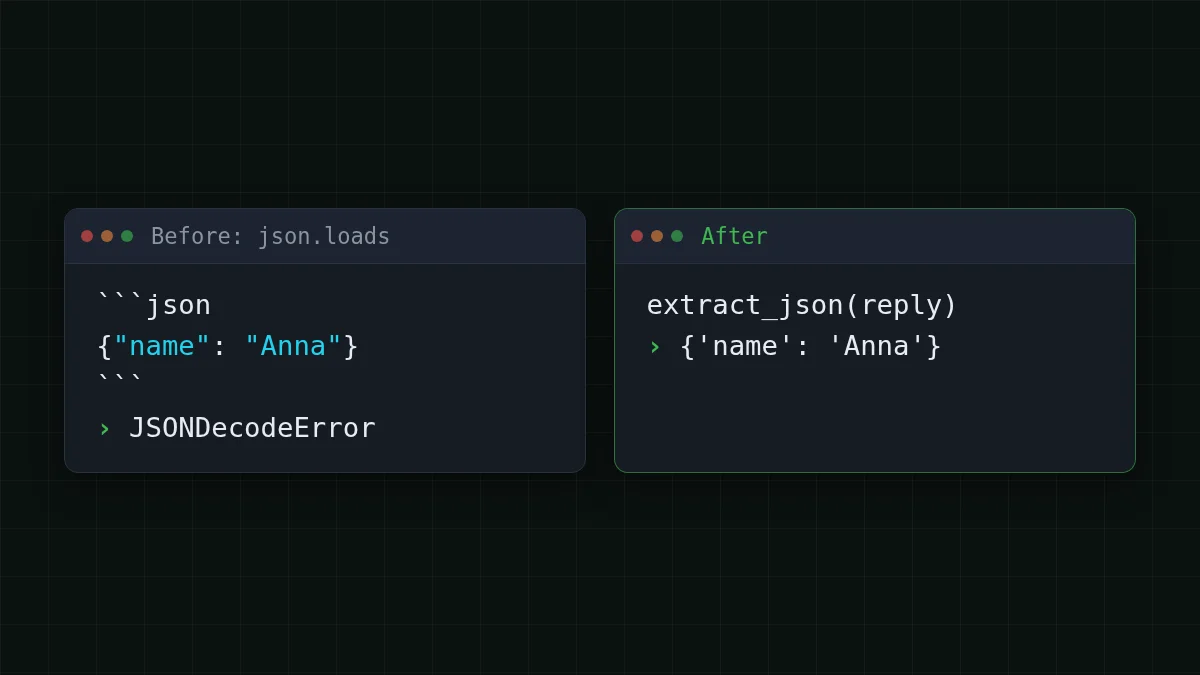
fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
처음 두 개는 pos 0에서 실패합니다. 파서가 맨 첫 글자, 즉 백틱이나 S를 보고 포기한 것입니다. 세 번째는 문자열 끝에서 실패합니다(pos가 len(reply)와 같음). 읽은 것은 모두 정상이었는데 텍스트가 바닥난 것입니다. 이 차이가 진단입니다. 위치 0은 JSON이 아마 거기 있지만 감싸여 있다는 뜻입니다. 끝 위치는 답변이 일찍 멈췄다는 뜻입니다.
잘린 답변: 파싱 전에 finish_reason을 확인하세요#
중간에 멈춘 응답은 파싱 문제가 아니라 길이 문제입니다. API가 알려줍니다. choice에 finish_reason가 있고, "length"는 답변이 max_tokens에 의해 잘렸다는 뜻입니다(자세한 내용은 AI 답변이 잘렸나요? finish_reason "length"와 max_tokens 수정 참고). 추출 전에 먼저 확인하세요.
이 단계를 건너뛰면 까다로운 함정이 있습니다. 첫 번째 파싱 가능한 {를 찾는 스캐너는 반쯤 완성된 바깥 객체에서 완전한 안쪽 객체를 집어낼 수 있고, 스크립트는 오류 없이 잘못된 데이터로 계속 진행합니다. 해보세요:
직접 해보기해보기: "첫 번째 객체 찾기" 함수는 이 잘린 응답에 대해 무엇을 반환할까요?정답 보기
'{"user": {"name": "Anna"}, "age": 31'를 봅시다. 바깥 객체는 절대 닫히지 않지만 안쪽 {"name": "Anna"}는 완전하므로, 아래 추출기는 {'name': 'Anna'}를 반환합니다. 예외도 없고 결과도 틀립니다. 그래서 finish_reason 검사가 추출보다 먼저 와야 합니다.
진짜 잘림에 대한 해결책은 공간을 늘리는 것입니다. max_tokens를 높이세요. DeepSeek-V4-Flash는 답변당 최대 32,768 출력 토큰, GLM-5.3-Flash는 최대 8,192를 허용하므로 긴 JSON 목록은 첫 번째 모델에서 공간이 더 많습니다. 모델 세부 정보는 CheapTokens 모델 페이지에 있습니다.
텍스트에서 JSON을 뽑아내기#
펜스와 잡담에는 표준 라이브러리에 이미 도구가 있습니다. 같은 Python 페이지에 따르면 JSONDecoder.는 JSON 문서로 시작하는 문자열에서 문서를 디코딩하고, 객체와 문서가 끝난 인덱스를 반환합니다. 문서에 따르면 끝에 불필요한 데이터가 있는 문자열에도 사용할 수 있습니다. 문서가 첫 글자에서 시작해야 하므로 앞의 텍스트를 먼저 잘라내세요. {를 찾고, 거기서 디코딩을 시도하고, 실패하면 다음 {로 넘어가세요.
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
펜스(앞의 ```json is skipped because it is not a {), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1]는 "see note [1]" 같은 문장에서 유효한 JSON이며 이길 것입니다.
의도적으로 하지 않는 두 가지가 있습니다. 텍스트를 절대 편집하지 않습니다(백틱을 지우는 정규식도, 빠진 괄호를 추측하는 것도 없음). 따라서 깨진 응답을 유효하지만 틀린 데이터로 바꿀 수 없습니다. 그리고 찾을 것이 없으면 크게 실패하며, 이것이 아래 재시도에 필요한 동작입니다.
더 엄격한 프롬프트로 한 번 재시도#
응답이 잘렸거나 객체가 전혀 없으면 다시 요청하세요. 끝없는 루프가 아니라 한 번만입니다. 잘린 경우에는 두 번째 시도에 공간을 더 주고, 그렇지 않으면 원하는 것을 분명히 말하세요. 이것은 CheapTokens base URL(https:/)에 대해 OpenAI Python SDK를 사용하며, 문서의 전체 모델 id를 씁니다. 키는 환경 변수에 있습니다.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
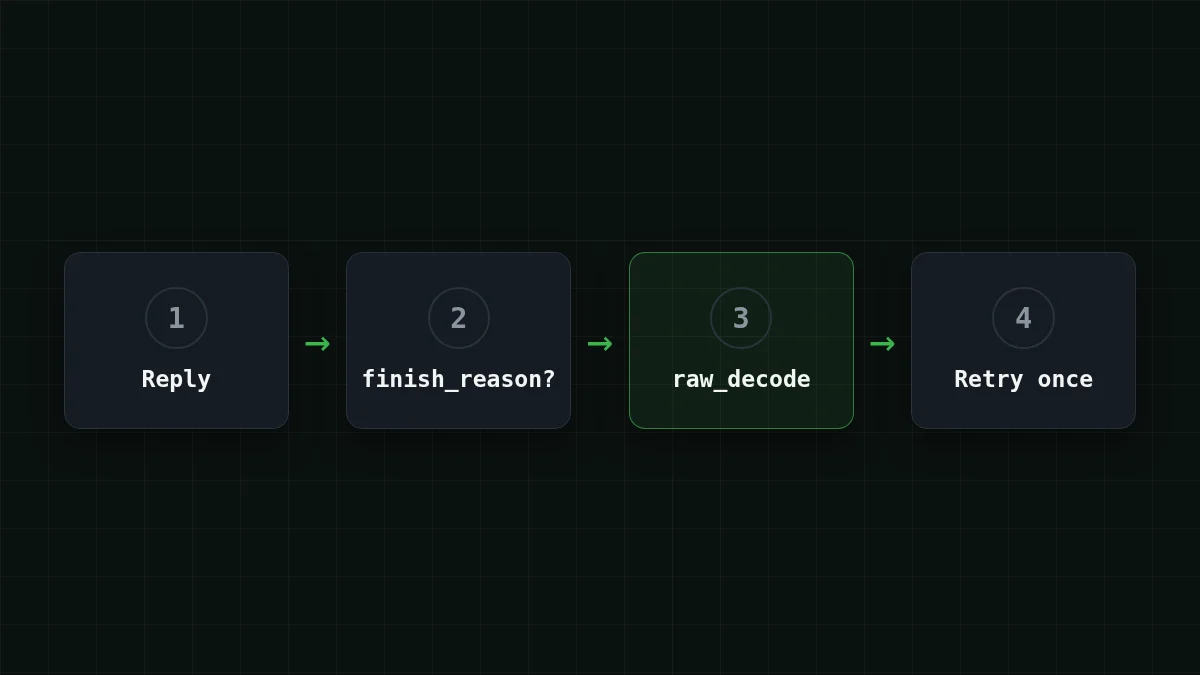
순서가 핵심입니다. finish_reason 먼저, 추출은 그다음, 그리고 나서야 재시도입니다. 두 번째 시도 후에 오류를 발생시켜 배치 작업이 해당 항목을 기록하고 넘어갈 수 있게 하세요.
재시도 비용은 추정하기 쉽습니다. 입력 1,200 토큰, 출력 300 토큰의 요청을 가정해 봅시다(가정일 뿐이니 자신의 숫자를 쓰세요): DeepSeek-V4-Flash에서 $0.000048 또는 GLM-5.3-Flash에서 $0.000036입니다. 1,000건 중 30건이 두 번째 시도를 필요로 하면 추가 청구액은 30 × 해당 요청, 즉 DeepSeek-V4-Flash에서 $0.0014입니다. 가격은 실시간이며 현재 가격표에서 가져옵니다.
순서대로 배열하기
복구 단계를 순서대로 정리하기
항목을 드래그하거나 화살표를 사용하세요
- finish_reason 확인: length면 여기서 중단
- 첫 번째 {를 찾아 그 앞의 텍스트를 잘라내기
- raw_decode로 디코딩하고 뒤따르는 것은 무시
- 아무것도 찾지 못하면 더 엄격한 프롬프트로 한 번 재시도
어떤 증상에 어떤 수정#
위 단계는 다음 이상한 오류가 나타날 때까지 머릿속에 들어옵니다. 이것은 조회표와 같습니다. 화면에서 보이는 것을 찾아 수정을 읽으세요.
사례 선택하기
보이는 것을 고르세요
답을 보려면 옵션을 선택하세요
json.loads가 pos 0에서 실패
응답이 펜스나 문장으로 시작합니다. extract_json를 통과시키세요. 재시도는 필요 없습니다.
pos가 문자열 끝에 있음
답변이 일찍 멈췄습니다. finish_reason를 확인하세요. length이면 max_tokens를 높이고 다시 요청하세요.
오류가 중간 어딘가에 있음
모델이 스스로 깨진 JSON을 썼습니다(빠진 쉼표, 끝 쉼표, 이스케이프되지 않은 따옴표). 고치지 마세요. 더 엄격한 프롬프트로 한 번 재시도하고, 또 실패하면 응답을 기록하세요.
json.loads는 되는데 키가 빠짐
파싱은 정상이고 내용이 문제입니다. 프롬프트에 정확한 키를 나열하고 파싱 후 코드에서 확인하세요.
API가 유효한 JSON을 강제할 수 있나요?#
때로는 가능합니다. OpenAI의 구조화된 출력 가이드는 두 가지 모드를 문서화합니다. 유효한 JSON을 반환하지만 스키마를 따르지 않는 JSON 모드(type: json_)와, 스키마를 따르는 Structured Outputs(type: json_, strict: true)입니다. OpenAI는 가능하면 두 번째를 권장합니다(출처: developers.openai.com, 2026년 11월 2일 확인). 이는 OpenAI 자체 API 옵션입니다. 다른 엔드포인트에서 response_format에 의존하기 전에 CheapTokens 문서를 확인하세요. 위의 추출과 재시도는 일반 채팅 완성과 함께 작동하며 특별한 파라미터가 필요 없습니다. 요청 측 옵션에 대해서는 LLM API에서 유효한 JSON 받기: response_format과 재시도를 참고하세요.
파서를 배포하기 전에 네 가지를 확인하세요. 텍스트를 파싱하기 전에 finish_reason를 읽는지, 재시도가 한 번뿐인지(그리고 두 번째 실패는 항목 id와 함께 기록되는지), 파싱 후 예상 키가 존재하는지 코드에서 확인하는지, max_tokens가 예상하는 가장 긴 JSON을 위한 공간을 남기는지입니다.
다음에 json.loads가 발생하면 exc.pos와 finish_reason를 먼저 출력하세요. 이 두 숫자가 보통 응답을 한 줄 읽기도 전에 무슨 일이 있었는지 알려줍니다.


