json.JSONDecodeError en una respuesta de LLM: extrae el JSON en Python
¿json.loads falla en una respuesta de modelo? Lee exc.pos y finish_reason para encontrar la causa, luego extrae el JSON con raw_decode y reintenta una vez.
En esta página
Tu script le pide JSON al modelo, llama a json. y muere con json.. Normalmente el modelo sí respondió: envolvió el JSON en un ```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder., y reintenta una vez si no se puede salvar nada.
Tres formas en que una respuesta rompe json.loads#
La documentación de json de Python (docs de Python 3.15, consultadas el 2 de noviembre de 2026) dice que JSONDecodeError es una subclase de ValueError con los atributos msg, doc, pos, lineno y colno. El que importa aquí es pos: el índice en la cadena donde falló el parseo.
Supón que un script extrae campos de correos de clientes y pide {"name": .. Estas tres cadenas son las respuestas que lo rompen. Pégalas en un shell de Python:
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
Las dos primeras fallan en pos 0: el parser miró el primerísimo carácter, un backtick o un S, y se rindió. La tercera falla al final de la cadena (pos es igual a len(reply)): todo lo que leyó estaba bien, y luego se acabó el texto. Esa diferencia es tu diagnóstico. La posición 0 significa que el JSON probablemente está ahí, solo envuelto. La posición al final significa que la respuesta se cortó antes de tiempo.
Respuestas cortadas: comprueba finish_reason antes de parsear#
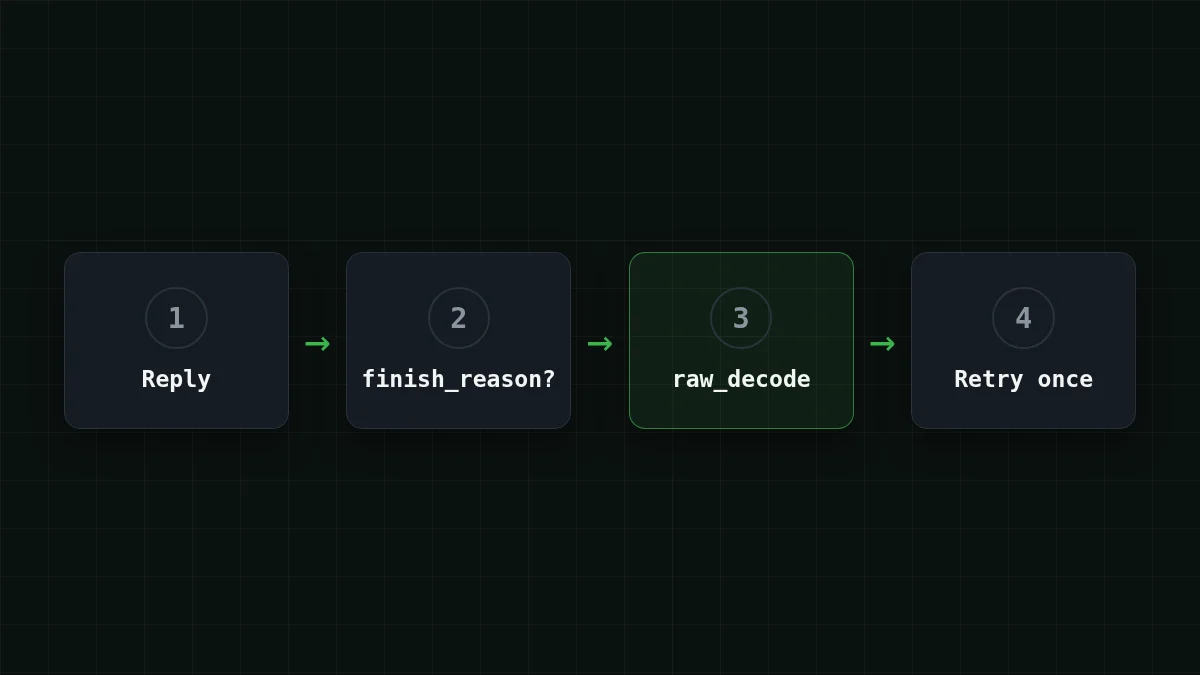
Una respuesta que se detiene a medias no es un problema de parseo, es un problema de longitud. La API te lo dice: la elección tiene finish_reason, y "length" significa que la respuesta fue cortada por max_tokens (la historia completa está en ¿Respuesta de IA cortada? Arregla finish_reason "length" y max_tokens). Míralo primero, antes de cualquier extracción.
Hay una trampa desagradable si te saltas ese paso. Un escáner que busca el primer { parseable puede capturar un objeto interno completo de uno externo a medio terminar, y tu script continúa con los datos equivocados y sin error. Pruébalo:
Pruébalo tú mismoPruébalo: ¿qué devuelve una función "encuentra el primer objeto" para esta respuesta cortada?Mostrar respuesta
Toma '{"user": {"name": "Anna"}, "age": 31'. El objeto externo nunca se cierra, pero el {"name": "Anna"} interno está completo, así que el extractor de abajo devuelve {'name': 'Anna'}. Sin excepción, resultado equivocado. Por eso la comprobación de finish_reason va antes de la extracción.
El arreglo para un corte real es más espacio: sube max_tokens. DeepSeek-V4-Flash permite hasta 32.768 tokens de salida por respuesta, GLM-5.3-Flash hasta 8.192, así que una lista JSON larga tiene más espacio en el primero. Los detalles de los modelos están en la página de modelos de CheapTokens.
Extrae el JSON del texto#
Para las vallas y la cháchara, la biblioteca estándar ya tiene la herramienta. Según la misma página de Python, JSONDecoder. decodifica un documento JSON desde una cadena que empieza con uno y devuelve el objeto más el índice donde terminó el documento. Los docs dicen que se puede usar en una cadena con datos sobrantes al final. Necesita que el documento empiece en el primer carácter, así que corta primero el texto inicial: busca un {, intenta decodificar desde ahí y pasa al siguiente { si falla.
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
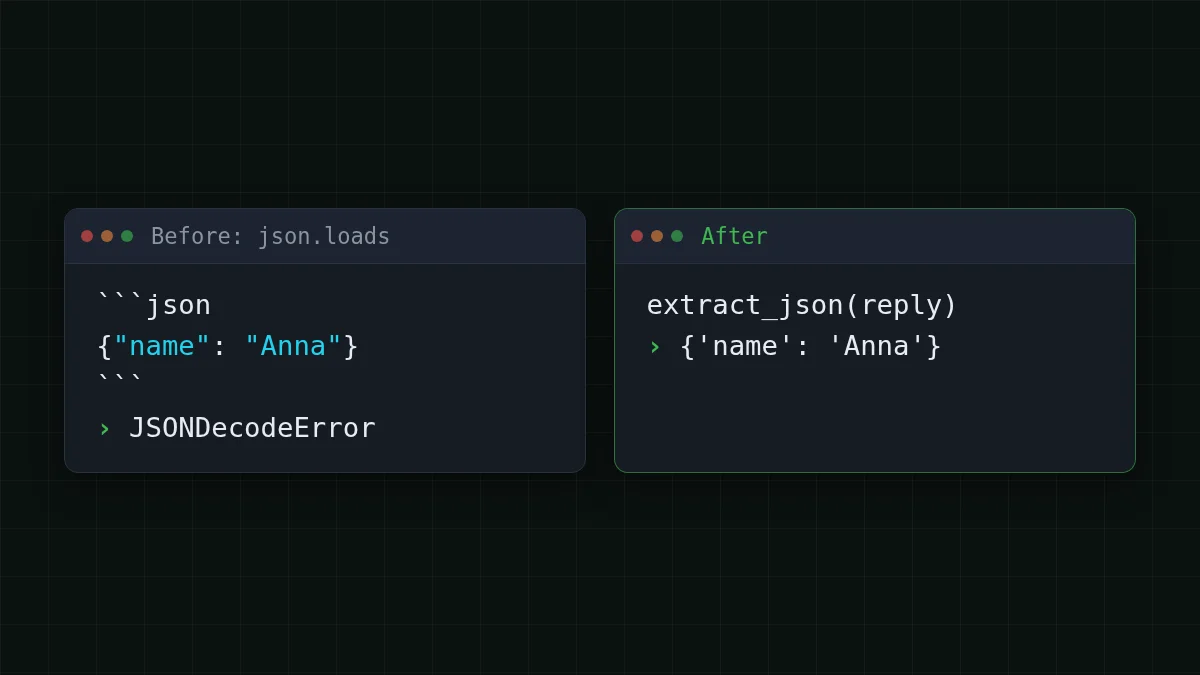
Maneja la valla (el ```json is skipped because it is not a {), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1] en una frase como "ver nota [1]" es JSON válido y ganaría.
Dos cosas que deliberadamente no hace. Nunca edita el texto (ni regex que borren backticks, ni adivinar corchetes que faltan), así que no puedes convertir una respuesta rota en datos válidos pero equivocados. Y falla ruidosamente cuando no hay nada que encontrar, que es lo que necesita el reintento de abajo.
Reintenta una vez con un prompt más estricto#
Si la respuesta se cortó o no contiene ningún objeto, pregunta otra vez. Una vez, no en un bucle infinito. En un corte, dale más espacio al segundo intento; si no, di claramente lo que quieres. Esto usa el SDK de Python de OpenAI contra la URL base de CheapTokens (https:/) y el id de modelo completo de los docs; la clave está en una variable de entorno.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
El orden es lo importante: finish_reason primero, la extracción después, y solo entonces un reintento. Lanza el error tras el segundo intento para que un trabajo por lotes pueda registrar ese elemento y continuar.
Lo que cuesta un reintento es fácil de estimar. Supón una petición de 1.200 tokens de entrada y 300 de salida (una suposición, usa tus propias cifras): $0.000048 en DeepSeek-V4-Flash o $0.000036 en GLM-5.3-Flash. Si 30 de 1.000 peticiones necesitan el segundo intento, la factura extra es 30 × esa petición, $0.0014 en DeepSeek-V4-Flash. Los precios están en vivo, vienen de la lista de precios actual.
Poner en orden
Pon los pasos de reparación en orden
Arrastra los elementos o usa las flechas
- Comprueba finish_reason: detente aquí si dice length
- Encuentra el primer { y corta el texto antes de él
- Decodifica con raw_decode e ignora lo que sigue
- Si no se encontró nada, reintenta una vez con el prompt más estricto
Qué síntoma, qué arreglo#
Los pasos de arriba caben en tu cabeza hasta que aparece el siguiente error raro. Esto es lo mismo que una tabla de consulta: encuentra lo que ves en pantalla y lee el arreglo.
Elige tu caso
Elige lo que ves
Elige una opción para ver la respuesta
json.loads falla en pos 0
La respuesta empieza con una valla o una frase. Pásala por extract_json; no hace falta reintentar.
pos está al final de la cadena
La respuesta se cortó antes de tiempo. Comprueba finish_reason: si es length, sube max_tokens y pregunta otra vez.
El error está en algún punto intermedio
El modelo escribió JSON roto él mismo (una coma que falta, una coma final, una comilla sin escapar). No lo parchees: reintenta una vez con el prompt más estricto y registra la respuesta si vuelve a fallar.
json.loads funciona pero falta una clave
El parseo está bien, el contenido no. Lista las claves exactas en el prompt y compruébalas en el código tras el parseo.
¿Puede la API forzar JSON válido?#
A veces. La guía de salidas estructuradas de OpenAI documenta dos modos: el modo JSON (type: json_), que devuelve JSON válido pero no sigue un esquema, y las salidas estructuradas (type: json_, strict: true), que sí lo hacen; OpenAI recomienda el segundo cuando sea posible (fuente: developers.openai.com, consultado el 2 de noviembre de 2026). Esas son opciones de la propia API de OpenAI. Antes de confiar en response_format con otro endpoint, consulta los docs de CheapTokens; la extracción y el reintento de arriba funcionan con chat completions normales y no necesitan ningún parámetro especial. Más sobre las opciones del lado de la petición en Obtén JSON válido de una API de LLM: response_format y reintentos.
Antes de publicar el parser, comprueba cuatro cosas: se lee finish_reason antes de parsear el texto, solo hay un reintento (y el segundo fallo se registra con el id del elemento), el código comprueba que las claves esperadas existen tras el parseo, y max_tokens deja espacio para el JSON más largo que esperas.
La próxima vez que json.loads lance una excepción, imprime primero exc.pos y finish_reason. Esos dos números suelen decirte qué pasó antes de que leas una línea de la respuesta.


