Решение проблемИнструкция
json.JSONDecodeError на ответе модели: достаём JSON в Python
json.loads падает на ответе модели? Смотрим exc.pos и finish_reason, достаём JSON через raw_decode и повторяем запрос один раз.
Содержание
Скрипт просит у модели JSON, вызывает json. и падает с json.. Чаще всего модель ответила: она завернула JSON в блок ```json, поставила перед ним строчку разговора или упёрлась в max_tokens на полпути. По exc.pos и finish_reason видно, какой случай ваш; объект достаёт JSONDecoder., а если спасать нечего — один повторный запрос.
Три способа сломать json.loads#
Документация Python по json (Python 3.15, сверено 2 ноября 2026) говорит: JSONDecodeError — подкласс ValueError с атрибутами msg, doc, pos, lineno и colno. Нам нужен pos — индекс в строке, где разбор остановился.
Допустим, скрипт вытаскивает поля из писем клиентов и просит {"name": .. Вот три ответа, на которых он ломается. Вставьте их в оболочку Python:
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
Первые два падают на pos 0: парсер посмотрел на самый первый символ — обратную кавычку или букву S — и сдался. Третий падает в конце строки (pos равен len(reply)): всё прочитанное было верным, потом текст кончился. В этой разнице и состоит диагноз. Позиция 0 — JSON, скорее всего, на месте, просто обёрнут. Позиция в конце — ответ оборвался.
Обрезанный ответ: сначала finish_reason, потом разбор#
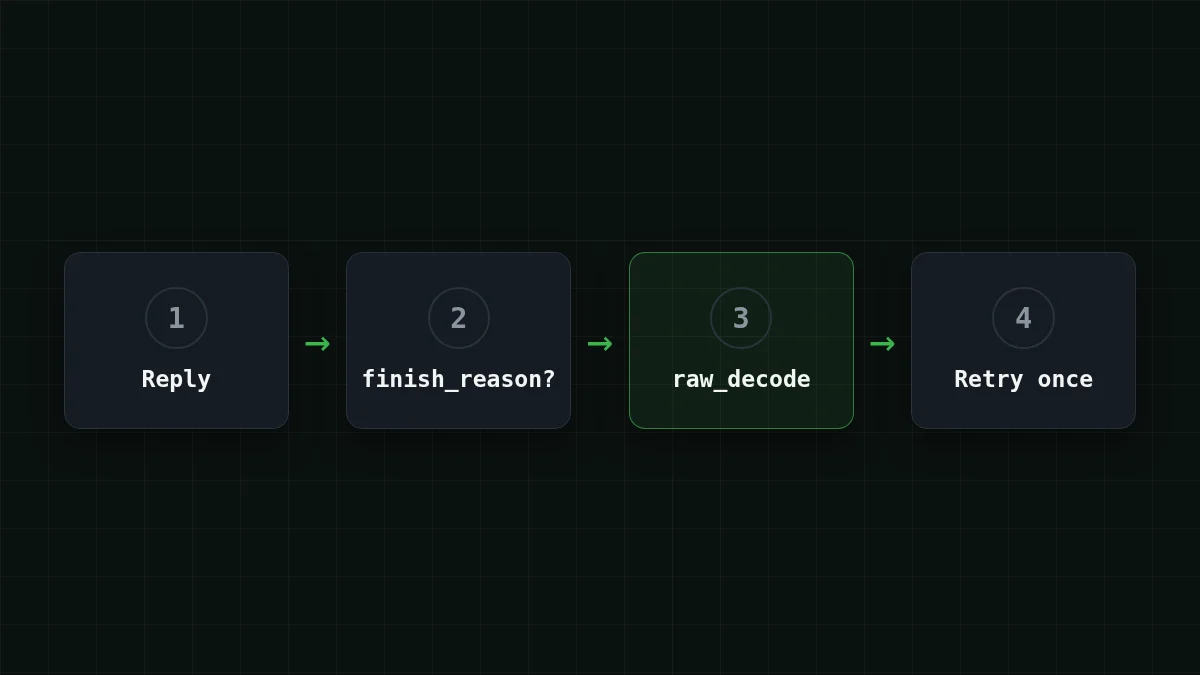
Ответ, оборванный на середине, — это не проблема разбора, а проблема длины. API говорит об этом сам: у варианта ответа есть finish_reason, и "length" значит, что ответ остановил max_tokens (подробно — в статье Ответ ИИ обрывается? finish_reason «length» и max_tokens). Смотрите его раньше любого извлечения.
Если пропустить этот шаг, есть неприятная ловушка. Функция, которая ищет первую разбираемую {, может подобрать целый внутренний объект из недописанного внешнего, и скрипт пойдёт дальше с неверными данными и без ошибки. Проверьте:
Попробуйте самиПопробуйте: что вернёт функция «найти первый объект» на этом обрезанном ответе?Показать ответ
Возьмём '{"user": {"name": "Anna"}, "age": 31'. Внешний объект не закрыт, но внутренний {"name": "Anna"} целый, поэтому функция ниже вернёт {'name': 'Anna'}. Исключения нет, результат неверный. Вот почему проверка finish_reason идёт до извлечения.
При настоящем обрыве помогает запас места: поднимите max_tokens. DeepSeek-V4-Flash отдаёт до 32 768 токенов в ответе, GLM-5.3-Flash — до 8 192, так что длинному JSON-списку на первой модели просторнее. Описание моделей — на странице моделей CheapTokens.
Достаём JSON из текста#
Для блоков кода и болтовни нужный инструмент уже есть в стандартной библиотеке. Та же страница Python: JSONDecoder. декодирует JSON-документ из строки, которая с него начинается, и возвращает объект и индекс, где документ закончился. Документация отмечает, что так можно разобрать строку с лишними данными в конце. Документ должен начинаться с первого символа, поэтому лишнее в начале сначала отрезаем: ищем {, пробуем декодировать с неё, при неудаче идём к следующей {.
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
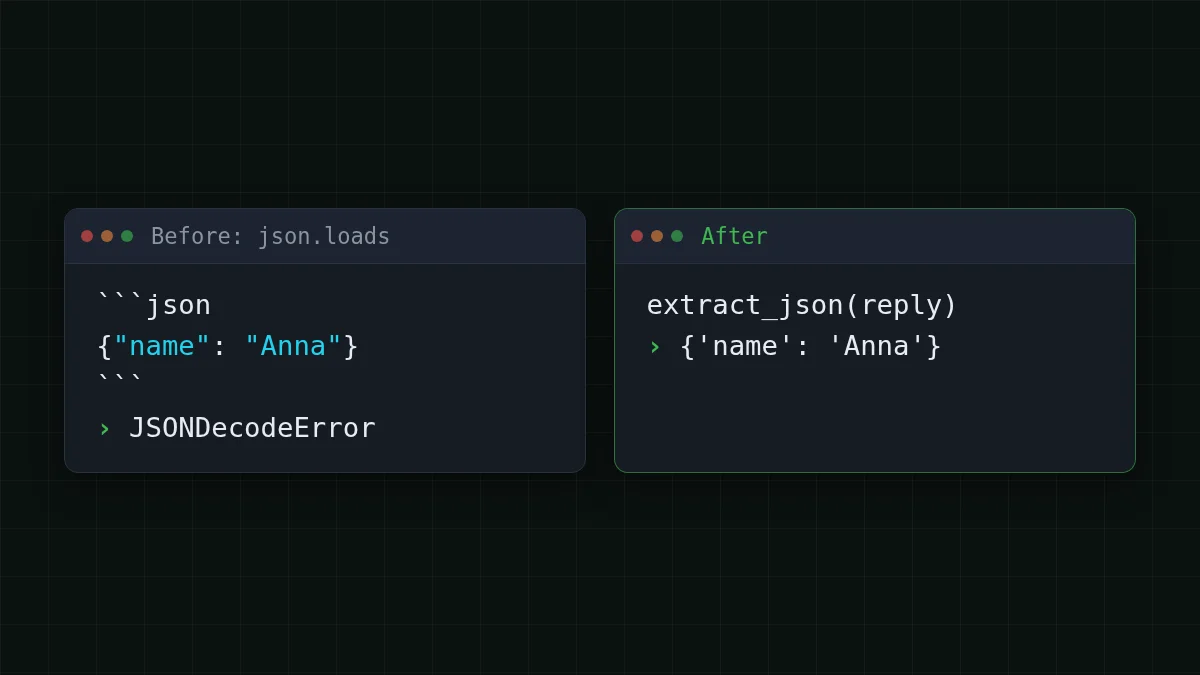
Функция справляется с блоком кода (начальный ```json пропускается: это не {), с фразой перед объектом и с текстом после закрывающей скобки. Ждёте список — ищите '['. Обе скобки сразу не ищите: случайное [1] во фразе «см. примечание [1]» — тоже валидный JSON и победит.
Две вещи она делает намеренно не так, как хочется. Она не правит текст (никаких регулярок, которые вырезают кавычки, и никаких догадок о недостающих скобках), поэтому сломанный ответ не превратится в валидные, но неверные данные. И она громко падает, когда искать нечего: именно это нужно повтору ниже.
Повтор один раз и строже#
Если ответ оборван или объекта в нём нет совсем, спросите ещё раз. Один раз, не в бесконечном цикле. При обрыве дайте второй попытке больше места; иначе прямо скажите, чего хотите. Пример на OpenAI Python SDK с адресом CheapTokens (https:/) и полным id модели из документации; ключ лежит в переменной окружения.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
Важен порядок: сначала finish_reason, потом извлечение и только потом повтор. После второй попытки бросайте ошибку, чтобы пакетная задача записала этот элемент в лог и пошла дальше.
Стоимость повтора прикинуть просто. Допустим, запрос — 1 200 токенов на входе и 300 на выходе (это допущение, подставьте свои числа): $0.000048 на DeepSeek-V4-Flash или $0.000036 на GLM-5.3-Flash. Если второй попытки требуют 30 запросов из 1 000, лишний счёт — 30 таких запросов, $0.0014 на DeepSeek-V4-Flash. Цены живые, берутся из текущего прайса.
Расставьте по порядку
Расставьте шаги починки по порядку
Перетащите элементы или используйте стрелки
- Проверить finish_reason: если там length, остановиться
- Найти первую { и отрезать текст перед ней
- Декодировать через raw_decode и проигнорировать остаток
- Если ничего не нашлось, один раз повторить со строгим промптом
Какой симптом — какое лекарство#
Шаги выше легко держать в голове, пока не встретится странная ошибка. То же самое в виде справочника: найдите то, что видите на экране, и прочтите, что делать.
Выберите свой случай
Выберите, что видите
Выберите вариант, чтобы увидеть ответ
json.loads падает на pos 0
Ответ начинается с блока кода или фразы. Пропустите его через extract_json; повтор не нужен.
pos в конце строки
Ответ оборвался. Проверьте finish_reason: если там length, поднимите max_tokens и спросите снова.
Ошибка где-то посередине
Модель сама написала сломанный JSON (пропущенная запятая, лишняя запятая в конце, неэкранированная кавычка). Не чините вручную: один раз повторите со строгим промптом, а при второй неудаче запишите ответ в лог.
json.loads работает, но нет ключа
Разбор прошёл, содержимое нет. Перечислите точные ключи в промпте и проверяйте их в коде после разбора.
Может ли API гарантировать валидный JSON?#
Иногда. В руководстве OpenAI по структурированным выводам описаны два режима: JSON mode (type: json_) — возвращает валидный JSON, но не следует схеме, и Structured Outputs (type: json_, strict: true) — следует; где возможно, OpenAI советует второй (источник: developers.openai.com, сверено 2 ноября 2026). Это параметры собственного API OpenAI. Прежде чем опираться на response_format на другом адресе, загляните в документацию CheapTokens; извлечение и повтор выше работают на обычных chat completions и не требуют особых параметров. О настройках на стороне запроса — в статье Get valid JSON from an LLM API: response_format and retries.
Перед выкаткой разбора проверьте четыре вещи: finish_reason читается до разбора текста, повтор только один (а вторая неудача пишется в лог с id элемента), код проверяет наличие нужных ключей после разбора, а max_tokens оставляет место для самого длинного JSON, какой вы ждёте.
В следующий раз, когда json.loads упадёт, сначала выведите exc.pos и finish_reason. Эти два значения обычно говорят, что случилось, ещё до того, как вы прочтёте ответ.


