トラブルシューティングガイド
HTTP 200後のストリーム失敗:Pythonでストリーム途中のエラーをキャッチする
200ステータス後にストリームが壊れる理由、event: errorの見つけ方、回答を重複させずに部分テキストを保持するPythonリトライ。
チャットUIが回答を途中までストリーミングした後フリーズし、ログには200 OKと表示されている。これは矛盾ではない:200はストリームが開始したことだけを示し、完了したことは示さない。 後から何かが壊れた場合、サーバーはエラーをストリームの内部にしか送れないため、ステータスコードのチェックではそれを検出できない。修正方法は、ストリームが終了シグナルで終わった場合にのみ成功とみなし、そうでなければクリーンなバッファからリトライすることだ。
このページの残りでは、壊れたストリームがどのように見えるか、2つのPythonハンドラ(Anthropic MessagesとOpenAI SDK)、そして回答の冒頭を二重に出力しないリトライを紹介する。どちらのハンドラもAPIエンドポイントとしてCheapTokensを使用する:ドキュメントにベースURLがあり、サンプルモデルはDeepSeek-V4-Flash(id deepseek-、380Kコンテキスト、回答あたり最大32,768出力トークン、時間帯に関係なく同一価格 — モデルページを参照)。
200が本当に約束するもの#
荷物の受け取り時に玄関でサインする宅配便業者を考えてみよう。サインは彼が到着したことを証明するが、荷物が無傷であることは証明しない。HTTPも同じように動作する。サーバーはまずステータス行とヘッダーを送信し、その後ボディが少しずつ届く。モデルバックエンドが途中で過負荷になった場合、ステータス行はすでに送信済みだ。
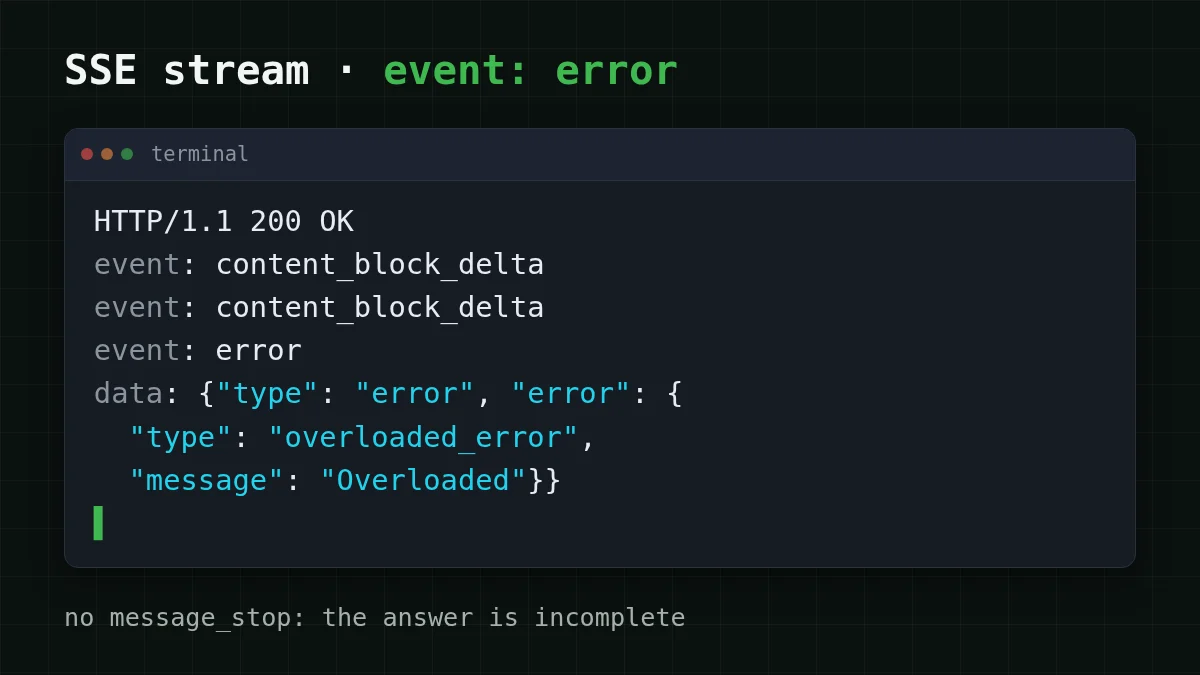
AnthropicのAPIエラーページ(2026年11月1日確認)にはこう明記されている:SSE経由でストリーミングレスポンスを受信する場合、APIが200を返した後にエラーが発生することがあり、その場合標準のエラーハンドリングは適用されない。ストリーミングのドキュメントにはそのイベントの形が示されている:
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}overloaded_errorは通常、非ストリーミング呼び出しでのHTTP 529に対応する(高トラフィックによる一時的な過負荷)。同じページには500 api_error(指数バックオフでリトライ)と504 timeout_error(長いリクエストにはストリーミングを使用)が記載されている。ワイヤー上では、壊れたストリームは次のように見える:
ドキュメントはまた、新しいイベントタイプが追加される可能性があると警告しているため、コードは未知のイベントを適切に処理すべきだ。だから以下のハンドラはすべてのエラーバイトを認識しようとはしない。1つの質問をするだけだ:ストリームは終了シグナルで終わったか?
- Anthropic Messages:最後のイベントは
message_stopで、message_delta内のstop_reasonが終了理由を示す(end_turn、max_tokens、stop_sequence)。 - OpenAI Chat Completions:最後のチャンクは空でない
finish_reasonを持つ(stop、length、…)。
終了シグナルがない、または途中で例外が発生した — ステータスが何と言っていても、回答は不完全だ。
Pythonでキャッチする#
ブラウザに返信をストリーミングするサポートボットを考えよう。ループはテキストをバッファに集め、3つのことを報告する:これまでのテキスト、ストリームが完了したかどうか、エラーがあればそのエラー。使用するSDKのタブを選んでほしい。
1つのハンドラ、2つのSDK
Anthropic SDK
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
OpenAI SDK
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
return ''.join(parts), finish is not None, None2つの詳細に注目する価値がある。第一に、両方のハンドラはSDKの基底エラークラス(anthropic.、openai.APIError)をキャッチするので、特定の失敗に対してSDKがどのサブクラスを発生させるかは問題にならない。第二に、finishedフラグは例外とは別だ:ストリームは例外なしで単に早期に終了することもあり、そのケースも失敗としてカウントする必要がある。
openai-pythonのREADMEにはOpenAI側で予想されることが追加されている(2026年11月1日確認):ストリーム内の読み取りタイムアウトはAPITimeoutErrorを発生させ、その他のHTTPXの失敗は__cause__に元の例外を含むAPIConnectionErrorを発生させる。ストリームが失敗せずに停止する場合は、OpenAI Python SDKのタイムアウトとリトライを参照。
回答を二重に出力せずにリトライする#
出荷しやすいバグがある。最初の試行が「返金ポリシーは…」と出力し、失敗し、リトライが最初からやり直して再び「返金ポリシーは…」と出力する — ユーザーには冒頭が二度見えるか、文が自分の再開に繋がって見える。よくある原因は共有バッファだ:answer += textが試行の外にあるため、2回目の試行が1回目に追加してしまう。
治療法は退屈だ。1回の試行が1つのバッファを所有し、失敗した試行のテキストは捨てられ(またはログ用にのみ保持され)、リトライはゼロから始まる:
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
raise RuntimeError('stream failed after all attempts')on_restartが重複を止める部分だ。Web UIでは次の試行がストリーミングされる前にメッセージバブルを空にする。プレーンなターミナルでは出力を取り消せないので、finishedが真になってから出力するか、目に見える--- retrying ---行を出力する。ゼロからのリトライはプロンプト全体を再送信するため、新しい試行に対して入力が再度課金される;ほとんどのチャット返信では、クリーンな回答に対する妥当な価格だ。
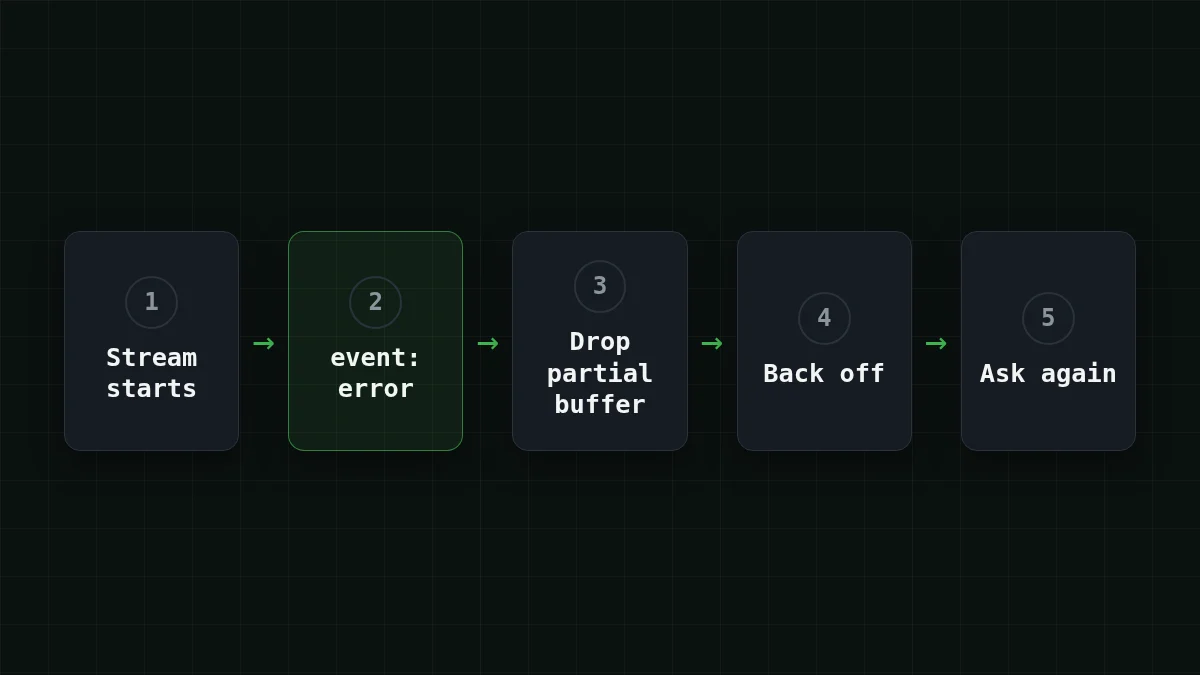
順番に並べる
リトライの手順をコードが実行すべき順に並べよう
項目をドラッグするか矢印を使う
- 壊れたストリームの読み取りを停止し、部分的なテキストをログ用に保持する
- エラーを確認する:408、409、429以外の4xxはリトライではなく停止を意味する
- メッセージボックスをクリアし、新しいバッファを開始する
- 指数バックオフで待機する(1秒、次に2秒)
- リクエスト全体を再送信し、新しい回答のみを表示する
AnthropicのSDKはすでに一時的な失敗 — 接続エラー、レート制限、5xx — を指数バックオフでリトライし、デフォルトで2回、retry-afterを尊重し、max_retriesでそれを変更できる。これはリクエストをカバーする。200の後に死ぬストリームは別の話だ:ドキュメントには標準のエラーハンドリングが適用されないとあるので、上記のループは自分で維持する必要がある。429単体については、別のウォークスルーがある:429 Too Many Requests:バックオフ付きリトライ。
早期停止がすべてエラーとは限らない#
リトライする前に、回答がなぜ終了したかを確認しよう。stop_(Anthropic)またはfinish_(OpenAI)で終わるストリームは実際に完了している — 設定した制限に達しただけだ。それをリトライすると同じ打ち切られたテキストと同じ請求が返ってくる。代わりに制限を上げよう;打ち切られた回答のガイドで詳しく説明している。
第三のグループがある:ネットワークだ。アイドル接続が途中で切断されることがあり、接続エラーまたはイベントなしで停止するストリームとして現れる。ストリーム途中のエラーと同じように処理し、頻発する場合は一般的な接続エラーを参照。長い生成では、Anthropicは巨大な非ストリーミングmax_tokensよりもストリーミングを推奨しているので、すでに正しい側にいる。
出荷前に#
失敗したすべての試行のリクエストIDを保存しよう。Anthropicのエラーボディにはrequest_idフィールドとrequest-idレスポンスヘッダーが含まれ、Python SDKはmessage.を公開する;そのIDがあれば、失敗は逸話ではなく追跡可能になる。
チェックリスト
ストリーミングエラーハンドリング、正しくやる
ハンドラの実行を見たい場合は、自分のキーを指定しよう:ドキュメントでAPIキーを作成し、CHEAPTOKENS_を設定して、ask_を呼び出す。Pythonでのストリーミングの基本はPythonでのストリーミングレスポンスから始めよう;Anthropic側はCheapTokensを使ったAnthropic Python SDKでカバーされている。