Решение проблемИнструкция
Стрим оборвался после HTTP 200: ловим ошибку в потоке на Python
Почему поток ломается после статуса 200, как заметить event: error и как повторить запрос в Python, не получив ответ дважды.
Содержание
Чат начал отвечать, замер на полуслове, а в логе красуется 200 OK. Тут нет противоречия: 200 говорит лишь о том, что поток начался, а не о том, что он закончился. Если что-то ломается позже, сервер может отправить ошибку только внутри самого потока, и проверка статуса её не увидит. Решение: считать стрим успешным, только когда он завершился своим финальным сигналом, а при его отсутствии повторять запрос с чистого буфера.
Ниже — как выглядит оборванный поток, два обработчика на Python (Anthropic Messages и OpenAI SDK) и повтор, который не печатает начало ответа дважды. В обоих обработчиках адрес API — CheapTokens: адреса есть в документации, а в примерах — модель DeepSeek-V4-Flash (id deepseek-, контекст 380K, до 32 768 токенов в ответе, одна цена в любое время суток; подробнее на странице модели).
Что на самом деле обещает 200#
Представьте курьера, который расписался за посылку у двери: подпись доказывает, что он приехал, но не что посылка цела. С HTTP так же. Сначала сервер отправляет строку статуса и заголовки, а тело приходит по кусочкам. Если бэкенд модели перегрузился на полпути, строка статуса уже ушла.
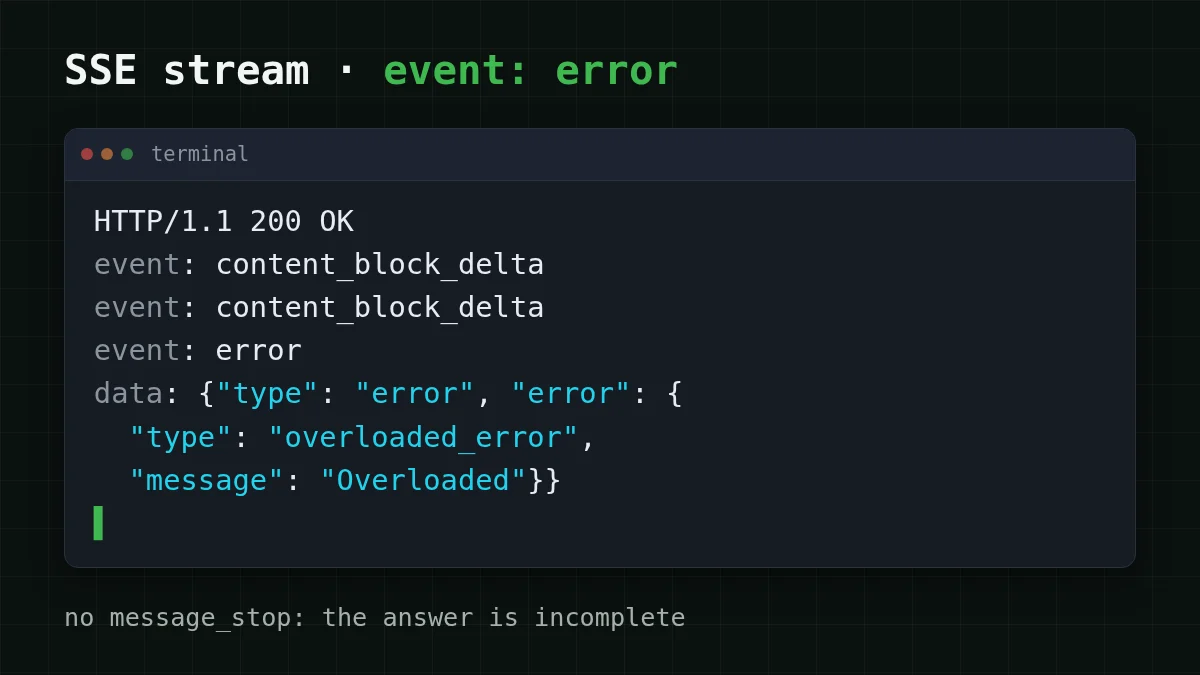
Страница Anthropic об ошибках API (сверено 1 ноября 2026) говорит об этом прямо: при потоковом ответе по SSE ошибка может случиться после того, как API вернул 200, и тогда обычная обработка ошибок не работает. Форму такого события описывает документация по стримингу:
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
overloaded_error обычно соответствует HTTP 529 у обычного запроса (временная перегрузка при большом трафике). На той же странице есть 500 api_error (повторяйте с экспоненциальной задержкой) и 504 timeout_error (для долгих запросов используйте стриминг). На проводе оборванный поток выглядит так:
Документация также предупреждает, что могут появиться новые типы событий, поэтому код должен спокойно переживать незнакомые. Поэтому обработчики ниже не пытаются узнать каждый байт ошибки. Они задают один вопрос: закончился ли поток своим финальным сигналом?
- Anthropic Messages: последнее событие —
message_stop, аstop_reasonвmessage_deltaобъясняет причину конца (end_turn,max_tokens,stop_sequence). - OpenAI Chat Completions: последний чанк содержит непустой
finish_reason(stop,length, …).
Нет финального сигнала или по пути вылетело исключение — ответ неполный, что бы ни показывал статус.
Ловим ошибку на Python#
Возьмём бота поддержки, который стримит ответы в браузер. Цикл собирает текст в буфер и возвращает три вещи: накопленный текст, признак завершения и ошибку, если она была. Выберите вкладку с вашим SDK.
Один обработчик, два SDK
Anthropic SDK
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
OpenAI SDK
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finish is not None, None
На две детали стоит взглянуть повнимательнее. Во-первых, оба обработчика ловят базовый класс ошибок SDK (anthropic., openai.APIError), поэтому неважно, какой именно подкласс SDK бросит в конкретном случае. Во-вторых, флаг finished живёт отдельно от исключения: поток может просто закончиться раньше времени без всякого исключения, и это тоже считается сбоем.
README openai-python добавляет, чего ждать на стороне OpenAI (сверено 1 ноября 2026): таймаут чтения в потоке поднимает APITimeoutError, остальные сбои HTTPX — APIConnectionError с исходным исключением в __cause__. Если поток не падает, а зависает, смотрите таймауты и повторы в OpenAI Python SDK.
Повтор без двойного ответа#
Вот ошибка, которую легко выпустить в продакшен. Первая попытка печатает «Политика возврата такова…», падает, повтор начинает заново и печатает «Политика возврата такова…» ещё раз — пользователь видит начало дважды или фразу, склеенную с собственным перезапуском. Обычная причина — общий буфер: answer += text живёт вне попытки, и вторая попытка дописывает к первой.
Лекарство скучное. Одна попытка — один буфер, текст неудачной попытки выбрасывается (или остаётся только для лога), а повтор начинается с нуля:
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
    raise RuntimeError('stream failed after all attempts')
Именно on_restart убирает дубль. В веб-интерфейсе он очищает пузырь сообщения перед следующей попыткой. В обычном терминале уже напечатанное не убрать, поэтому либо выводите текст только после finished, либо печатайте заметную строку --- retrying ---. Повтор с нуля отправляет весь промпт заново, так что вход тарифицируется ещё раз; для большинства ответов чата это нормальная цена за чистый результат.
Расставьте по порядку
Расставьте шаги повтора в том порядке, в каком их выполняет код
Перетащите элементы или используйте стрелки
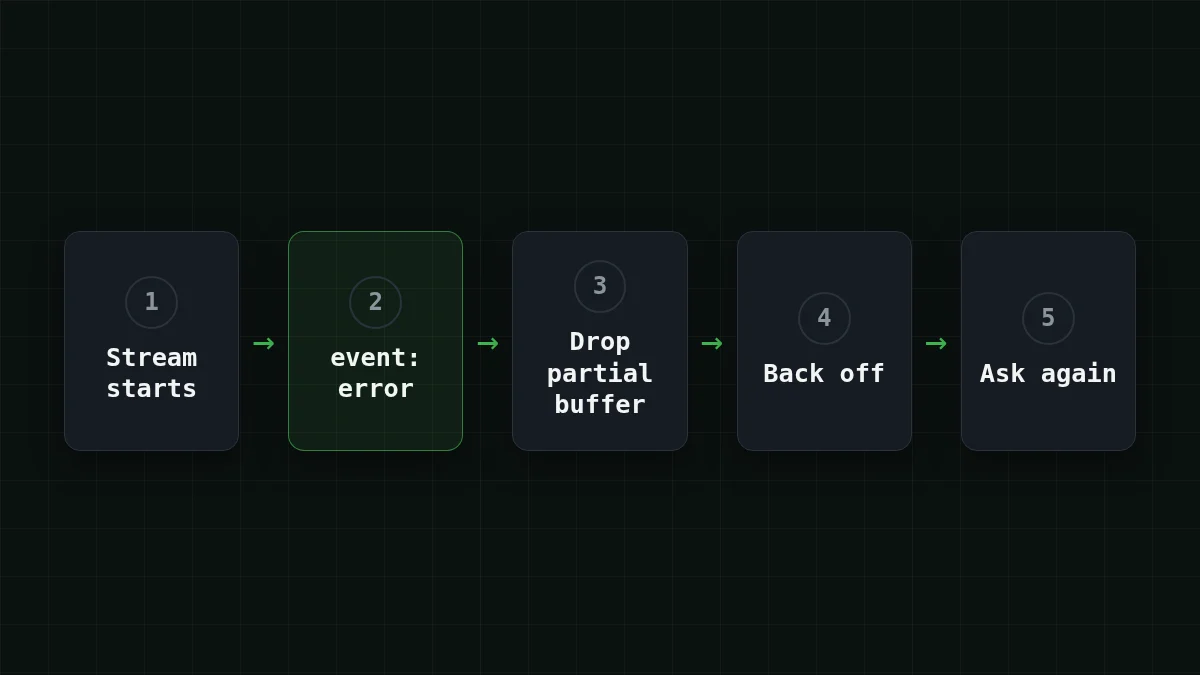
- Перестать читать оборванный поток и сохранить частичный текст для лога
- Проверить ошибку: 4xx, кроме 408, 409 и 429, значит «остановиться», а не повторять
- Очистить окно сообщения и завести новый буфер
- Подождать с экспоненциальной задержкой (1 с, затем 2 с)
- Отправить запрос целиком ещё раз и показать только новый ответ
SDK Anthropic уже повторяет временные сбои — ошибки соединения, лимиты, 5xx — с экспоненциальной задержкой, по умолчанию 2 раза, с учётом retry-after; max_retries это меняет. Но это относится к самому запросу. Поток, умерший после 200, — другая история: по документации, обычная обработка ошибок там не работает, так что цикл выше остаётся за вами. Про 429 отдельно есть разбор: 429 Too Many Requests: повторы с задержкой.
Не всякая ранняя остановка — ошибка#
Прежде чем повторять, посмотрите, почему ответ закончился. Поток, завершившийся с stop_ (Anthropic) или finish_ (OpenAI), именно завершился — просто упёрся в заданный вами лимит. Повтор вернёт тот же обрезанный текст и выставит тот же счёт. Поднимите лимит; как это сделать, показано в разборе обрезанного ответа.
Есть и третья группа — сеть. Простаивающие соединения по дороге могут рваться: это выглядит как ошибка соединения или поток, который замолкает без единого события. Обрабатывайте это так же, как ошибку в потоке, а если повторяется часто — загляните в частые ошибки соединения. Для длинных генераций Anthropic советует стриминг вместо огромного max_tokens без него, так что вы уже на правильной стороне.
Перед выпуском#
Сохраняйте request id каждой неудачной попытки. В теле ошибок Anthropic есть поле request_id и заголовок ответа request-id, а Python SDK отдаёт message.; по такому id сбой можно проследить, а не пересказывать на словах.
Чек-лист
Обработка ошибок стриминга: что проверить
Чтобы увидеть обработчик в деле, подставьте свой ключ: создайте ключ API по документации, задайте CHEAPTOKENS_ и вызовите ask_. Основы стриминга на Python — в статье стриминг ответов в Python, а про Anthropic-сторону — в Anthropic Python SDK с CheapTokens.