Rozwiązywanie problemówPrzewodnik
Strumień zawiódł po HTTP 200: łapanie błędów w środku strumienia w Pythonie
Dlaczego strumień może się zepsuć po statusie 200, jak rozpoznać event: error i ponawianie w Pythonie, które zachowuje częściowy tekst bez duplikowania odpowiedzi.
Na tej stronie
Twoje UI czatu streamowało połowę odpowiedzi, zamarło, a log mówi 200 OK. To nie sprzeczność: 200 mówi tylko, że strumień się rozpoczął, a nie że się zakończył. Jeśli coś zepsuje się później, serwer może wysłać błąd tylko wewnątrz strumienia, więc sprawdzenie kodu statusu nigdy go nie zobaczy. Rozwiązaniem jest traktowanie strumienia jako udanego tylko wtedy, gdy kończy się sygnałem zakończenia, i ponawianie z czystego bufora, gdy tak się nie stanie.
Reszta tej strony pokazuje, jak wygląda uszkodzony strumień, dwa handlery w Pythonie (Anthropic Messages i OpenAI SDK) oraz ponawianie, które nie drukuje początku odpowiedzi dwa razy. Oba handlery używają CheapTokens jako punktu końcowego API: dokumentacja zawiera bazowe adresy URL, a przykładowy model to DeepSeek-V4-Flash (id deepseek-, kontekst 380K, do 32 768 tokenów wyjściowych na odpowiedź, jedna cena o każdej porze — zobacz stronę modelu).
Co naprawdę obiecuje 200#
Pomyśl o kurierze, który podpisuje odbiór paczki pod drzwiami: podpis dowodzi, że dotarł, a nie że paczka jest nienaruszona. HTTP działa tak samo. Serwer najpierw wysyła linię statusu i nagłówki, potem ciało przychodzi kawałek po kawałku. Jeśli backend modelu przeciąży się w połowie, linia statusu już poszła.
Strona błędów API Anthropic (sprawdzona 1 listopada 2026) mówi to wprost: gdy otrzymujesz odpowiedź strumieniową przez SSE, błąd może wystąpić po tym, jak API zwróci 200, i wtedy standardowa obsługa błędów nie ma zastosowania. Dokumentacja streamingu podaje kształt tego zdarzenia:
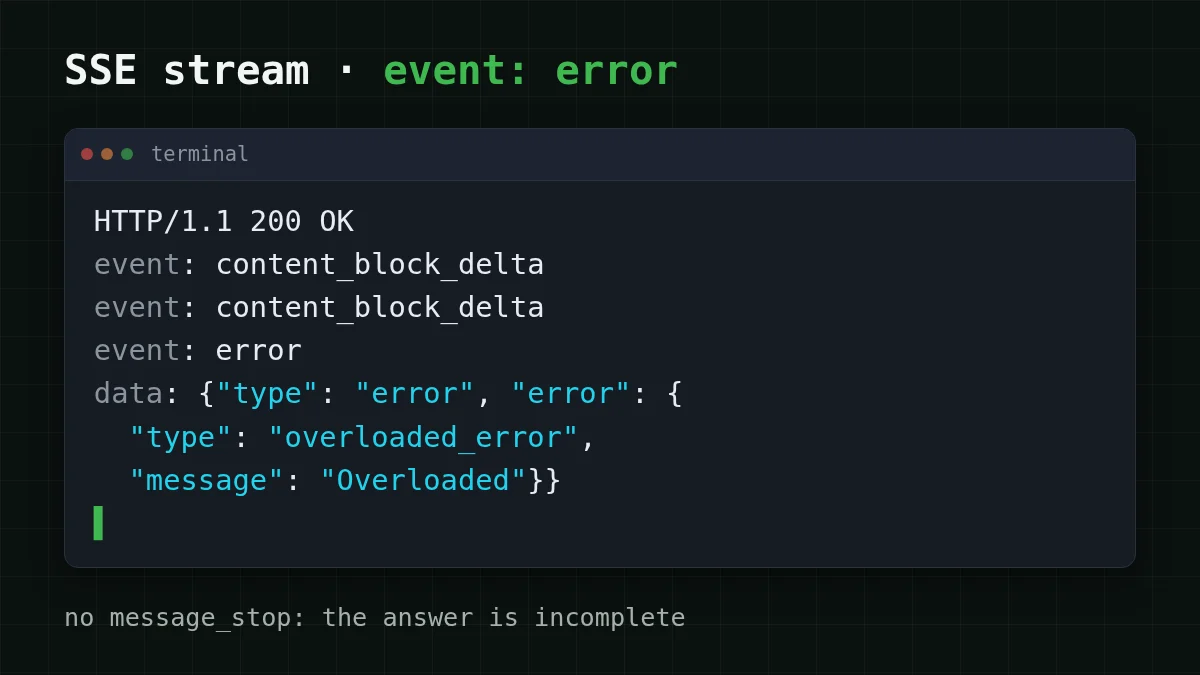
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
overloaded_error zwykle odpowiada HTTP 529 przy wywołaniu niestrumieniowym (tymczasowe przeciążenie z powodu dużego ruchu). Ta sama strona wymienia 500 api_error (ponów z wykładniczym backoffem) i 504 timeout_error (używaj streamingu dla długich żądań). W transmisji uszkodzony strumień wygląda tak:
Dokumentacja ostrzega też, że mogą pojawić się nowe typy zdarzeń, więc kod powinien obsługiwać nieznane zdarzenia z gracją. Dlatego poniższe handlery nie próbują rozpoznać każdego bajtu błędu. Zadają jedno pytanie: czy strumień zakończył się swoim sygnałem zakończenia?
- Anthropic Messages: ostatnie zdarzenie to
message_stop, astop_reasonwmessage_deltamówi, dlaczego się zakończyło (end_turn,max_tokens,stop_sequence). - OpenAI Chat Completions: ostatni fragment niesie niepuste
finish_reason(stop,length, …).
Brak sygnału zakończenia albo wyjątek po drodze — odpowiedź jest niekompletna, niezależnie od tego, co mówił status.
Złap to w Pythonie#
Weź bota wsparcia, który streamuje odpowiedzi do przeglądarki. Pętla zbiera tekst do bufora i zwraca trzy rzeczy: dotychczasowy tekst, czy strumień się zakończył oraz błąd, jeśli wystąpił. Wybierz kartę dla używanego SDK.
Jeden handler, dwa SDK
Anthropic SDK
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
OpenAI SDK
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finish is not None, None
Dwa szczegóły warte drugiego spojrzenia. Po pierwsze, oba handlery łapią bazową klasę błędów SDK (anthropic., openai.APIError), więc nie ma znaczenia, którą podklasę SDK zgłosi dla danego błędu. Po drugie, flaga finished jest oddzielona od wyjątku: strumień może też po prostu zakończyć się wcześniej, bez żadnego wyjątku, i ten przypadek również musi być liczony jako błąd.
README openai-python dodaje, czego oczekiwać po stronie OpenAI (sprawdzone 1 listopada 2026): przekroczenie limitu czasu odczytu w strumieniu zgłasza APITimeoutError, inne błędy HTTPX zgłaszają APIConnectionError z oryginalnym wyjątkiem w __cause__. Jeśli strumień się zawiesza zamiast kończyć błędem, zobacz limity czasu i ponawianie w OpenAI Python SDK.
Ponów bez drukowania odpowiedzi dwa razy#
Oto błąd, który łatwo wdrożyć. Pierwsza próba drukuje „Polityka zwrotów to…”, umiera, ponowienie zaczyna od nowa i znowu drukuje „Polityka zwrotów to…” — teraz użytkownik widzi początek dwa razy albo zdanie sklejone z własnym restartem. Zwykłą przyczyną jest jeden współdzielony bufor: answer += text żyje poza próbą, więc druga próba dopisuje do pierwszej.
Lekarstwo jest nudne. Jedna próba ma jeden bufor, tekst nieudanej próby jest wyrzucany (albo zachowywany tylko do logu), a ponowienie zaczyna od zera:
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
    raise RuntimeError('stream failed after all attempts')
on_restart to część, która powstrzymuje duplikat. W UI webowym opróżnia bąbelek wiadomości przed napływem następnej próby. W zwykłym terminalu nie można cofnąć wydruku, więc albo drukuj dopiero po tym, jak finished będzie prawdziwe, albo wypisz widoczną linię --- retrying ---. Ponawianie od zera wysyła cały prompt ponownie, więc wejście jest rozliczane jeszcze raz dla nowej próby; dla większości odpowiedzi czatu to uczciwa cena za czystą odpowiedź.
Ustaw w kolejności
Ułóż kroki ponawiania w kolejności, w jakiej powinien je wykonać kod
Przeciągnij elementy lub użyj strzałek
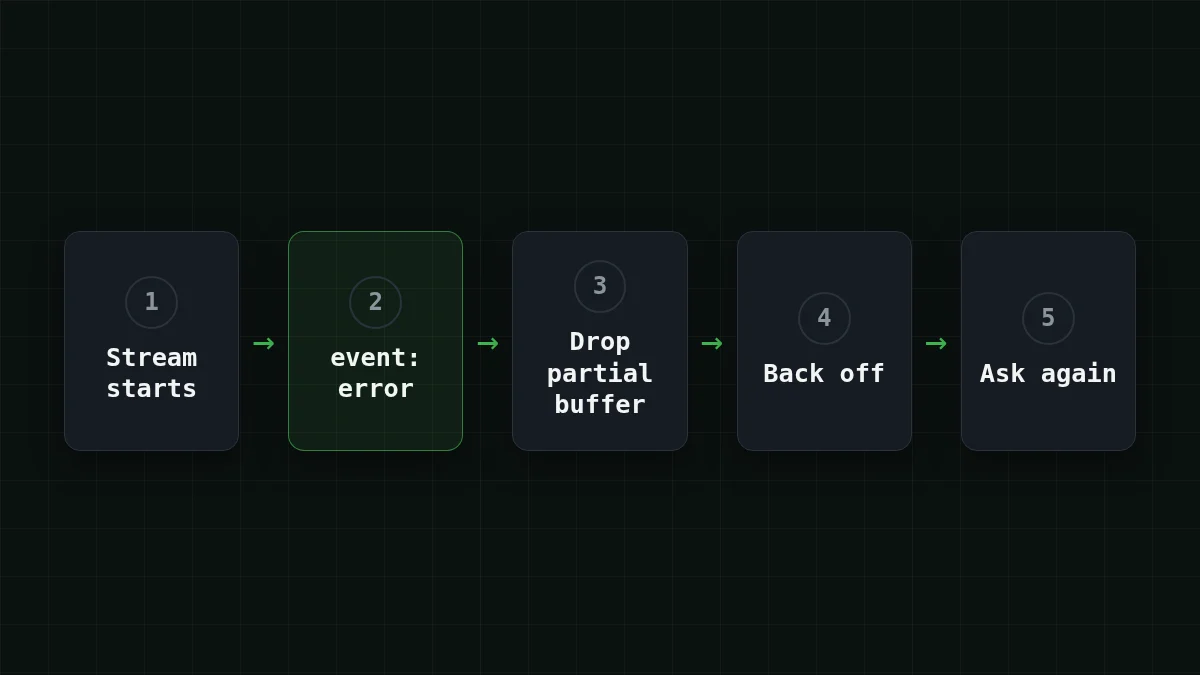
- Przestań czytać uszkodzony strumień i zachowaj jego częściowy tekst do logu
- Sprawdź błąd: 4xx inny niż 408, 409 i 429 oznacza stop, nie ponawianie
- Wyczyść pole wiadomości i zacznij nowy bufor
- Poczekaj z wykładniczym backoffem (1 s, potem 2 s)
- Wyślij pełne żądanie ponownie i pokaż tylko nową odpowiedź
SDK Anthropic już ponawia przejściowe błędy — błędy połączenia, limity szybkości, 5xx — z wykładniczym backoffem, domyślnie 2 razy, respektując retry-after, a max_retries to zmienia. To obejmuje żądanie. Strumień, który umiera po 200, to inna historia: dokumentacja mówi, że standardowa obsługa błędów tam nie ma zastosowania, więc powyższa pętla jest twoja. Dla samego 429 jest osobny przewodnik: 429 Too Many Requests: ponawianie z backoffem.
Nie każde wczesne zatrzymanie to błąd#
Zanim ponowisz, sprawdź, dlaczego odpowiedź się zakończyła. Strumień, który kończy się stop_ (Anthropic) lub finish_ (OpenAI), zakończył się — po prostu osiągnął ustawiony limit. Ponowienie zwróci ten sam ucięty tekst i ten sam rachunek. Zamiast tego podnieś limit; przewodnik po uciętych odpowiedziach omawia to krok po kroku.
Jest trzecia grupa: sieć. Bezczynne połączenia mogą zostać zerwane po drodze, co objawia się błędem połączenia lub strumieniem, który zatrzymuje się bez żadnego zdarzenia. Obsługuj to tak samo jak błąd w środku strumienia, a jeśli powtarza się to często, zobacz typowe błędy połączenia. Dla długich generacji Anthropic zaleca streaming zamiast ogromnego niestrumieniowego max_tokens, więc jesteś już po właściwej stronie.
Zanim wdrożysz#
Zapisuj id żądania każdej nieudanej próby. Ciała błędów Anthropic zawierają pole request_id i nagłówek odpowiedzi request-id, a SDK Pythona udostępnia message.; z tym id błąd jest możliwy do prześledzenia, a nie anegdotyczny.
Lista kontrolna
Obsługa błędów streamingu, zrobiona dobrze
Jeśli chcesz zobaczyć handler w akcji, skieruj go na własny klucz: utwórz klucz API w dokumentacji, ustaw CHEAPTOKENS_ i wywołaj ask_. Podstawy streamingu w Pythonie znajdziesz w odpowiedziach strumieniowych w Pythonie; strona Anthropic jest omówiona w Anthropic Python SDK z CheapTokens.