समस्या निवारणगाइड
HTTP 200 के बाद स्ट्रीम विफल: Python में मिड-स्ट्रीम त्रुटियाँ पकड़ें
200 स्टेटस के बाद स्ट्रीम क्यों टूट सकती है, event: error को कैसे पहचानें, और एक Python पुनः प्रयास जो उत्तर को डुप्लिकेट किए बिना आंशिक टेक्स्ट रखता है।
इस पृष्ठ पर
आपके चैट UI ने आधा उत्तर स्ट्रीम किया, फ्रीज़ हो गया, और लॉग कहता है 200 OK। यह विरोधाभास नहीं है: 200 केवल यह बताता है कि स्ट्रीम शुरू हुई, यह नहीं कि वह पूरी हुई। अगर बाद में कुछ टूटता है, तो सर्वर केवल स्ट्रीम के अंदर त्रुटि भेज सकता है, इसलिए स्टेटस कोड की जाँच उसे कभी नहीं देखती। समाधान यह है कि स्ट्रीम को केवल तब सफल मानें जब वह अपने फिनिश सिग्नल के साथ समाप्त हो, और जब ऐसा न हो तो साफ़ बफ़र से पुनः प्रयास करें।
इस पृष्ठ का शेष भाग दिखाता है कि टूटी हुई स्ट्रीम कैसी दिखती है, दो Python हैंडलर (Anthropic Messages और OpenAI SDK), और एक पुनः प्रयास जो उत्तर की शुरुआत दो बार नहीं छापता। दोनों हैंडलर CheapTokens को API एंडपॉइंट के रूप में उपयोग करते हैं: दस्तावेज़ में बेस URL हैं, और नमूना मॉडल DeepSeek-V4-Flash है (id deepseek-, 380K संदर्भ, प्रति उत्तर अधिकतम 32,768 आउटपुट टोकन, किसी भी समय एक मूल्य — देखें मॉडल पृष्ठ)।
200 वास्तव में क्या वादा करता है#
एक कूरियर की सोचें जो दरवाज़े पर पार्सल के लिए हस्ताक्षर करता है: हस्ताक्षर साबित करता है कि वह पहुँचा, यह नहीं कि पार्सल सुरक्षित है। HTTP उसी तरह काम करता है। सर्वर पहले स्टेटस लाइन और हेडर भेजता है, फिर बॉडी टुकड़े-टुकड़े में आती है। अगर मॉडल बैकएंड बीच में ओवरलोड हो जाता है, तो स्टेटस लाइन पहले ही जा चुकी होती है।
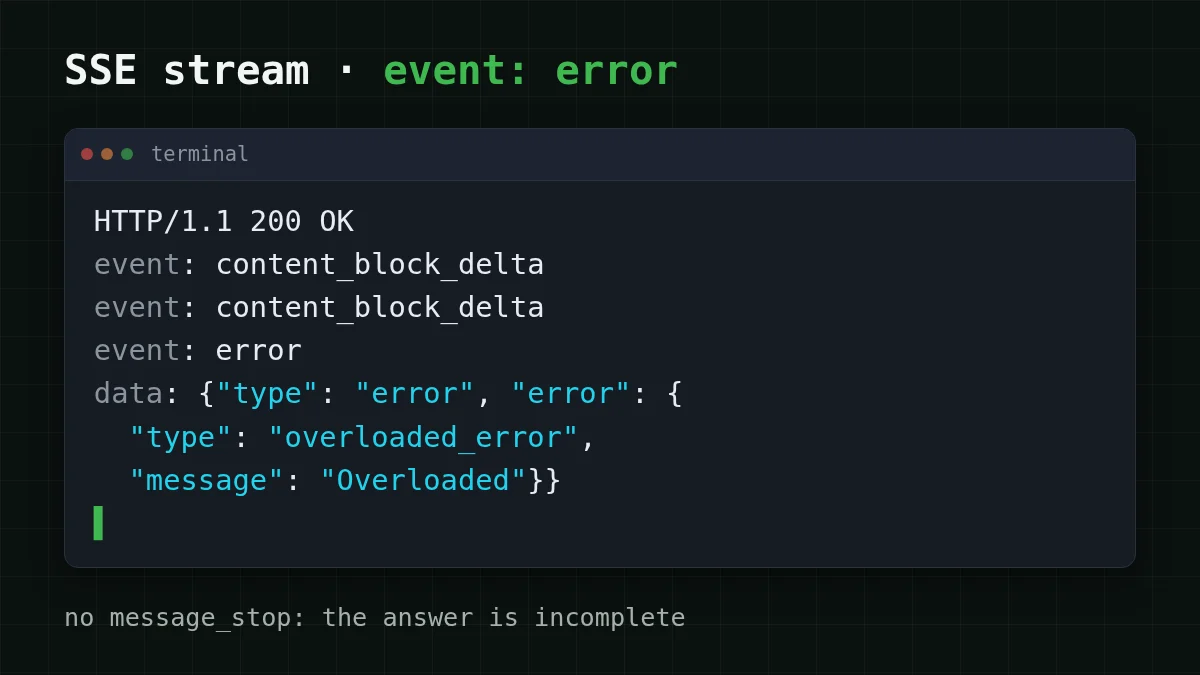
Anthropic का API त्रुटि पृष्ठ (1 नवंबर 2026 को जाँचा गया) सीधे कहता है: जब आप SSE पर स्ट्रीमिंग प्रतिक्रिया प्राप्त करते हैं, तो API के 200 लौटाने के बाद त्रुटि हो सकती है, और तब मानक त्रुटि प्रबंधन लागू नहीं होता। इसके स्ट्रीमिंग दस्तावेज़ उस घटना का आकार देते हैं:
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
overloaded_error सामान्यतः गैर-स्ट्रीमिंग कॉल पर HTTP 529 के अनुरूप होता है (उच्च ट्रैफ़िक से अस्थायी ओवरलोड)। वही पृष्ठ 500 api_error (एक्सपोनेंशियल बैकऑफ़ के साथ पुनः प्रयास) और 504 timeout_error (लंबे अनुरोधों के लिए स्ट्रीमिंग का उपयोग करें) सूचीबद्ध करता है। वायर पर टूटी हुई स्ट्रीम ऐसी दिखती है:
दस्तावेज़ यह भी चेतावनी देते हैं कि नए इवेंट प्रकार जोड़े जा सकते हैं, इसलिए आपके कोड को अज्ञात इवेंट को सहजता से संभालना चाहिए। इसीलिए नीचे दिए गए हैंडलर हर त्रुटि बाइट को पहचानने की कोशिश नहीं करते। वे एक प्रश्न पूछते हैं: क्या स्ट्रीम अपने फिनिश सिग्नल के साथ समाप्त हुई?
- Anthropic Messages: अंतिम इवेंट
message_stopहै, औरmessage_deltaमेंstop_reasonबताता है कि यह क्यों समाप्त हुआ (end_turn,max_tokens,stop_sequence)। - OpenAI Chat Completions: अंतिम चंक में एक गैर-रिक्त
finish_reasonहोता है (stop,length, …)।
कोई फिनिश सिग्नल नहीं, या रास्ते में अपवाद — उत्तर अधूरा है, चाहे स्टेटस कुछ भी कहता हो।
इसे Python में पकड़ें#
एक सपोर्ट बॉट लें जो ब्राउज़र को उत्तर स्ट्रीम करता है। लूप टेक्स्ट को बफ़र में एकत्र करता है और तीन चीज़ें रिपोर्ट करता है: अब तक का टेक्स्ट, क्या स्ट्रीम पूरी हुई, और यदि कोई त्रुटि थी तो वह। आप जो SDK उपयोग करते हैं उसके लिए टैब चुनें।
एक हैंडलर, दो SDK
Anthropic SDK
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
OpenAI SDK
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finish is not None, None
दो विवरण दूसरी नज़र के लायक हैं। पहला, दोनों हैंडलर SDK की बेस त्रुटि क्लास को पकड़ते हैं (anthropic., openai.APIError), इसलिए इससे कोई फ़र्क नहीं पड़ता कि SDK किसी दिए गए विफलता के लिए कौन सा सबक्लास उठाता है। दूसरा, finished फ़्लैग अपवाद से अलग है: एक स्ट्रीम बिना किसी अपवाद के भी जल्दी समाप्त हो सकती है, और उस स्थिति को भी विफलता माना जाना चाहिए।
openai-python README जोड़ता है कि OpenAI पक्ष पर क्या अपेक्षा करें (1 नवंबर 2026 को जाँचा गया): स्ट्रीम में रीड टाइमआउट APITimeoutError उठाता है, अन्य HTTPX विफलताएँ APIConnectionError उठाती हैं जिसमें मूल अपवाद __cause__ में होता है। यदि स्ट्रीम विफल होने के बजाय रुक जाती है, तो देखें OpenAI Python SDK में टाइमआउट और पुनः प्रयास।
उत्तर को दो बार छापे बिना पुनः प्रयास करें#
यहाँ एक बग है जिसे शिप करना आसान है। पहला प्रयास "रिफंड नीति है…" छापता है, मर जाता है, पुनः प्रयास फिर से शुरू होता है और फिर "रिफंड नीति है…" छापता है — अब उपयोगकर्ता शुरुआत दो बार देखता है, या एक वाक्य अपने ही पुनःआरंभ से चिपका हुआ देखता है। सामान्य कारण एक साझा बफ़र है: answer += text प्रयास के बाहर रहता है, इसलिए दूसरा प्रयास पहले में जोड़ता है।
इलाज उबाऊ है। एक प्रयास एक बफ़र का मालिक है, विफल प्रयास का टेक्स्ट फेंक दिया जाता है (या केवल लॉग के लिए रखा जाता है), और पुनः प्रयास शुरू से शुरू होता है:
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
    raise RuntimeError('stream failed after all attempts')
on_restart वह हिस्सा है जो डुप्लिकेट को रोकता है। वेब UI में यह अगले प्रयास के स्ट्रीम होने से पहले संदेश बबल को खाली कर देता है। सादे टर्मिनल में आप अन-प्रिंट नहीं कर सकते, इसलिए या तो finished सत्य होने के बाद ही छापें, या एक दृश्यमान --- retrying --- पंक्ति छापें। शुरू से पुनः प्रयास करने पर पूरा प्रॉम्प्ट फिर से भेजा जाता है, इसलिए नए प्रयास के लिए इनपुट का फिर से बिल लगता है; अधिकांश चैट उत्तरों के लिए यह साफ़ उत्तर के लिए उचित मूल्य है।
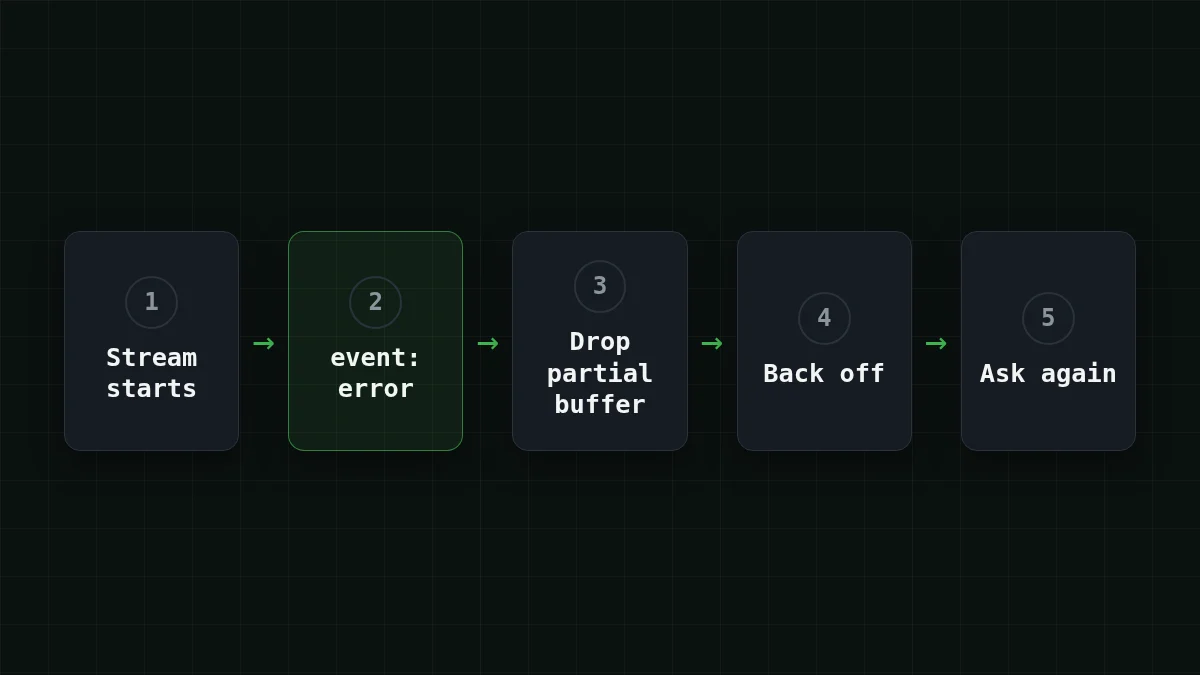
क्रम में लगाएँ
पुनः प्रयास चरणों को उस क्रम में रखें जिसमें आपके कोड को उन्हें चलाना चाहिए
आइटम खींचें या तीरों का उपयोग करें
- टूटी हुई स्ट्रीम पढ़ना बंद करें और उसका आंशिक टेक्स्ट लॉग के लिए रखें
- त्रुटि जाँचें: 408, 409 और 429 के अलावा 4xx का अर्थ है रुकें, पुनः प्रयास नहीं
- संदेश बॉक्स साफ़ करें और नया बफ़र शुरू करें
- एक्सपोनेंशियल बैकऑफ़ के साथ प्रतीक्षा करें (1 सेकंड, फिर 2 सेकंड)
- पूरा अनुरोध फिर से भेजें और केवल नया उत्तर दिखाएँ
Anthropic का SDK पहले से ही क्षणिक विफलताओं — कनेक्शन त्रुटियाँ, दर सीमाएँ, 5xx — को एक्सपोनेंशियल बैकऑफ़ के साथ पुनः प्रयास करता है, डिफ़ॉल्ट रूप से 2 बार, retry-after का सम्मान करते हुए, और max_retries इसे बदलता है। यह अनुरोध को कवर करता है। 200 के बाद मरने वाली स्ट्रीम एक अलग कहानी है: दस्तावेज़ कहते हैं कि मानक त्रुटि प्रबंधन वहाँ लागू नहीं होता, इसलिए ऊपर दिया गया लूप आपका है। केवल 429 के लिए, एक अलग वॉकथ्रू है: 429 Too Many Requests: बैकऑफ़ के साथ पुनः प्रयास।
हर जल्दी रुकना त्रुटि नहीं है#
पुनः प्रयास करने से पहले, जाँचें कि उत्तर क्यों समाप्त हुआ। stop_ (Anthropic) या finish_ (OpenAI) के साथ समाप्त होने वाली स्ट्रीम वास्तव में पूरी हुई — उसने बस आपकी निर्धारित सीमा को छुआ। उसे पुनः प्रयास करने पर वही कटा हुआ टेक्स्ट और वही बिल मिलता है। इसके बजाय सीमा बढ़ाएँ; कटे हुए उत्तर की मार्गदर्शिका इसे समझाती है।
एक तीसरा समूह है: नेटवर्क। निष्क्रिय कनेक्शन रास्ते में गिराए जा सकते हैं, जो कनेक्शन त्रुटि या बिना किसी इवेंट के रुकने वाली स्ट्रीम के रूप में दिखता है। इसे मिड-स्ट्रीम त्रुटि की तरह ही संभालें, और यदि यह बार-बार होता रहे तो सामान्य कनेक्शन त्रुटियाँ देखें। लंबे जनरेशन के लिए, Anthropic एक विशाल गैर-स्ट्रीमिंग max_tokens के बजाय स्ट्रीमिंग की सिफारिश करता है, इसलिए आप पहले से ही उसके सही पक्ष में हैं।
शिप करने से पहले#
प्रत्येक विफल प्रयास की अनुरोध आईडी सहेजें। Anthropic त्रुटि बॉडी में एक request_id फ़ील्ड और एक request-id प्रतिक्रिया हेडर होता है, और Python SDK message. को उजागर करता है; उस आईडी के साथ विफलता ट्रेस करने योग्य होती है, किस्सागोई नहीं।
चेकलिस्ट
स्ट्रीमिंग त्रुटि प्रबंधन, सही ढंग से
यदि आप हैंडलर को चलते देखना चाहते हैं, तो इसे अपनी कुंजी पर इंगित करें: दस्तावेज़ों में API कुंजी बनाएँ, CHEAPTOKENS_ सेट करें, और ask_ कॉल करें। Python में स्ट्रीमिंग की मूल बातें के लिए, Python में स्ट्रीमिंग प्रतिक्रियाएँ से शुरू करें; Anthropic पक्ष CheapTokens के साथ Anthropic Python SDK में कवर किया गया है।