DépannageGuide
Échec du flux après HTTP 200 : attraper les erreurs en cours de flux en Python
Pourquoi un flux peut casser après un statut 200, comment repérer event: error, et une nouvelle tentative Python qui conserve le texte partiel sans dupliquer la réponse.
Sur cette page
Votre interface de chat a diffusé la moitié d'une réponse, s'est figée, et le journal indique 200 OK. Ce n'est pas une contradiction : le 200 indique seulement que le flux a démarré, pas qu'il s'est terminé. Si quelque chose casse plus tard, le serveur ne peut envoyer une erreur qu'à l'intérieur du flux, donc une vérification du code de statut ne la verra jamais. La solution consiste à considérer un flux comme réussi uniquement lorsqu'il se termine par son signal de fin, et à réessayer depuis un tampon propre lorsqu'il ne le fait pas.
Le reste de cette page montre à quoi ressemble le flux cassé, deux gestionnaires Python (Anthropic Messages et OpenAI SDK), et une nouvelle tentative qui n'affiche pas deux fois le début de la réponse. Les deux gestionnaires utilisent CheapTokens comme point de terminaison API : la documentation contient les URL de base, et le modèle d'exemple est DeepSeek-V4-Flash (id deepseek-, contexte de 380K, jusqu'à 32 768 jetons de sortie par réponse, un prix à toute heure — voir la page du modèle).
Ce qu'un 200 promet vraiment#
Pensez à un livreur qui signe un colis à la porte : la signature prouve qu'il est arrivé, pas que le colis est intact. HTTP fonctionne de la même manière. Le serveur envoie d'abord la ligne de statut et les en-têtes, puis le corps arrive morceau par morceau. Si le backend du modèle est surchargé à mi-parcours, la ligne de statut est déjà partie.
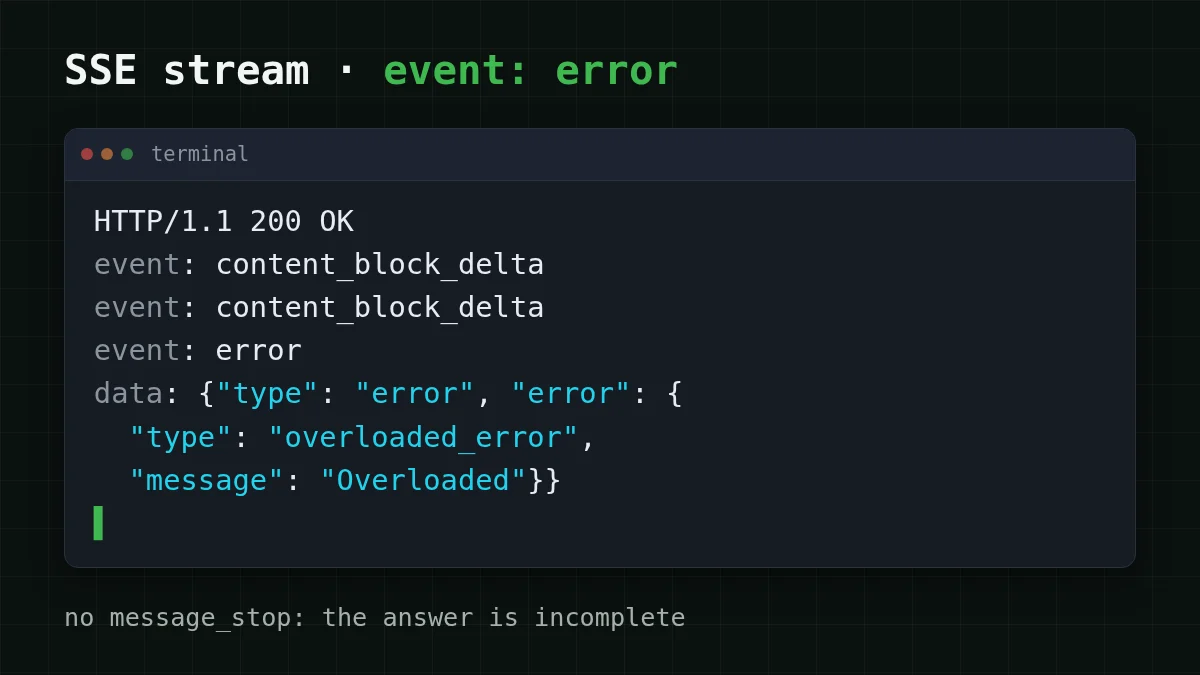
La page d'erreurs de l'API Anthropic (consultée le 1er novembre 2026) le dit directement : lorsque vous recevez une réponse en streaming via SSE, une erreur peut survenir après que l'API a renvoyé un 200, et la gestion standard des erreurs ne s'applique alors pas. Sa documentation sur le streaming donne la forme de cet événement :
event: error
data: {"type": "error", "error": {"type": "overloaded_error", "message": "Overloaded"}}
overloaded_error correspond normalement à un HTTP 529 sur un appel non-streaming (surcharge temporaire due à un trafic élevé). La même page liste 500 api_error (réessayer avec un backoff exponentiel) et 504 timeout_error (utiliser le streaming pour les requêtes longues). Sur le fil, un flux cassé ressemble à ceci :
La documentation avertit également que de nouveaux types d'événements peuvent être ajoutés, donc votre code doit gérer les événements inconnus avec élégance. C'est pourquoi les gestionnaires ci-dessous n'essaient pas de reconnaître chaque octet d'erreur. Ils posent une seule question : le flux s'est-il terminé par son signal de fin ?
- Anthropic Messages : le dernier événement est
message_stop, etstop_reasondansmessage_deltaindique pourquoi il s'est terminé (end_turn,max_tokens,stop_sequence). - OpenAI Chat Completions : le dernier chunk porte un
finish_reasonnon vide (stop,length, …).
Pas de signal de fin, ou une exception en cours de route — la réponse est incomplète, quel que soit le statut indiqué.
L'attraper en Python#
Prenez un bot de support qui diffuse des réponses au navigateur. La boucle collecte le texte dans un tampon et renvoie trois choses : le texte jusqu'ici, si le flux s'est terminé, et l'erreur s'il y en a une. Choisissez l'onglet du SDK que vous utilisez.
Un gestionnaire, deux SDK
SDK Anthropic
import os
import anthropic

client = anthropic.Anthropic(
    base_url='https://api.cheaptokens.dev',  # no /v1 for the Anthropic SDK
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finished = [], False
    try:
        with client.messages.stream(
            model=MODEL,
            max_tokens=1024,
            messages=[{'role': 'user', 'content': prompt}],
        ) as stream:
            for event in stream:
                if event.type == 'content_block_delta' and event.delta.type == 'text_delta':
                    parts.append(event.delta.text)
                    on_text(event.delta.text)
                elif event.type == 'message_stop':
                    finished = True
    except anthropic.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finished, None
SDK OpenAI
import os
import openai

client = openai.OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'

def ask_once(prompt, on_text=lambda t: None):
    parts, finish = [], None
    try:
        stream = client.chat.completions.create(
            model=MODEL,
            max_tokens=1024,
            stream=True,
            messages=[{'role': 'user', 'content': prompt}],
        )
        for chunk in stream:
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            if choice.delta.content:
                parts.append(choice.delta.content)
                on_text(choice.delta.content)
            if choice.finish_reason:
                finish = choice.finish_reason
    except openai.APIError as err:
        return ''.join(parts), False, err
    return ''.join(parts), finish is not None, None
Deux détails méritent un second regard. Premièrement, les deux gestionnaires attrapent la classe d'erreur de base du SDK (anthropic., openai.APIError), donc peu importe quelle sous-classe le SDK lève pour un échec donné. Deuxièmement, l'indicateur finished est distinct de l'exception : un flux peut aussi simplement se terminer tôt, sans aucune exception, et ce cas doit aussi compter comme un échec.
Le README d'openai-python ajoute ce à quoi s'attendre côté OpenAI (consulté le 1er novembre 2026) : un délai de lecture dans un flux lève APITimeoutError, les autres échecs HTTPX lèvent APIConnectionError avec l'exception d'origine dans __cause__. Si le flux se bloque au lieu d'échouer, voir timeouts et retries dans le SDK Python OpenAI.
Réessayer sans afficher la réponse deux fois#
Voici un bug facile à livrer. Une première tentative affiche « La politique de remboursement est… », meurt, la nouvelle tentative recommence et affiche « La politique de remboursement est… » à nouveau — l'utilisateur voit maintenant le début deux fois, ou une phrase collée à son propre redémarrage. La cause habituelle est un tampon partagé : answer += text vit en dehors de la tentative, donc la seconde tentative s'ajoute à la première.
Le remède est ennuyeux. Une tentative possède un tampon, le texte d'une tentative échouée est jeté (ou conservé uniquement pour le journal), et la nouvelle tentative repart de zéro :
import time

def ask_with_retry(prompt, attempts=3, on_text=lambda t: None, on_restart=lambda: None):
    for attempt in range(attempts):
        text, finished, err = ask_once(prompt, on_text)
        if finished:
            return text
        status = getattr(err, 'status_code', None)
        if status is not None and 400 <= status < 500 and status not in (408, 409, 429):
            raise err  # a 400/401/404 will not fix itself
        print(f'attempt {attempt + 1} failed after {len(text)} chars: {err!r}')
        if attempt == attempts - 1:
            break
        on_restart()  # clear the message box in your UI
        time.sleep(2 ** attempt)  # 1 s, 2 s
    raise RuntimeError('stream failed after all attempts')
on_restart est la partie qui empêche le doublon. Dans une interface web, elle vide la bulle de message avant que la tentative suivante ne diffuse. Dans un terminal simple, vous ne pouvez pas annuler l'affichage, donc soit n'affichez qu'après que finished est vrai, soit affichez une ligne --- retrying --- visible. Réessayer depuis zéro renvoie tout le prompt, donc l'entrée est facturée à nouveau pour la nouvelle tentative ; pour la plupart des réponses de chat, c'est un prix raisonnable pour une réponse propre.
Remettre en ordre
Mettez les étapes de nouvelle tentative dans l'ordre où votre code doit les exécuter
Faites glisser les éléments ou utilisez les flèches
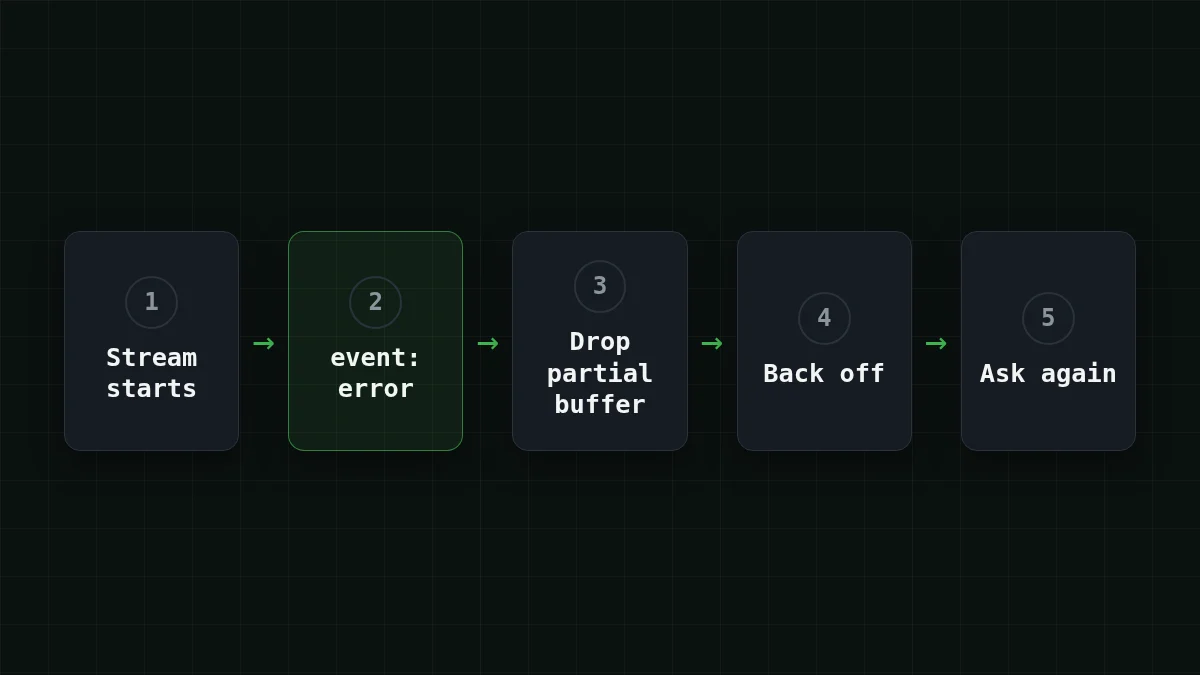
- Arrêter de lire le flux cassé et conserver son texte partiel pour le journal
- Vérifier l'erreur : un 4xx autre que 408, 409 et 429 signifie arrêter, pas réessayer
- Vider la boîte de message et démarrer un nouveau tampon
- Attendre avec un backoff exponentiel (1 s, puis 2 s)
- Renvoyer la requête complète et n'afficher que la nouvelle réponse
Le SDK d'Anthropic réessaie déjà les échecs transitoires — erreurs de connexion, limites de débit, 5xx — avec un backoff exponentiel, 2 fois par défaut, en respectant retry-after, et max_retries modifie cela. Cela couvre la requête. Un flux qui meurt après le 200 est une autre histoire : la documentation indique que la gestion standard des erreurs ne s'applique pas là, donc la boucle ci-dessus est à conserver. Pour le 429 seul, il existe un guide séparé : 429 Too Many Requests : retries avec backoff.
Tout arrêt précoce n'est pas une erreur#
Avant de réessayer, vérifiez pourquoi la réponse s'est terminée. Un flux qui se termine par stop_ (Anthropic) ou finish_ (OpenAI) s'est bien terminé — il a juste atteint la limite que vous avez fixée. Réessayer renvoie le même texte tronqué et la même facture. Augmentez plutôt la limite ; le guide sur les réponses tronquées explique comment.
Il existe un troisième groupe : le réseau. Les connexions inactives peuvent être coupées en route, ce qui se manifeste par une erreur de connexion ou un flux qui s'arrête sans aucun événement. Traitez-le comme une erreur en cours de flux, et voir erreurs de connexion courantes si cela se reproduit. Pour les générations longues, Anthropic recommande le streaming plutôt qu'un énorme max_tokens non-streaming, donc vous êtes déjà du bon côté.
Avant de livrer#
Enregistrez l'id de requête de chaque tentative échouée. Les corps d'erreur d'Anthropic portent un champ request_id et un en-tête de réponse request-id, et le SDK Python expose message. ; avec cet id, un échec est traçable au lieu d'être anecdotique.
Liste de contrôle
Gestion des erreurs de streaming, bien faite
Si vous voulez voir le gestionnaire fonctionner, pointez-le vers votre propre clé : créer une clé API dans la documentation, définir CHEAPTOKENS_, et appeler ask_. Pour les bases du streaming en Python, commencez par réponses en streaming en Python ; le côté Anthropic est couvert dans le SDK Python Anthropic avec CheapTokens.