DépannageGuide
UnicodeEncodeError lors de l'affichage d'une réponse LLM en Python : 3 correctifs
print(reply) plante sur du cyrillique ou un emoji ? Découvrez pourquoi Python échoue avec une sortie redirigée ou une page de code héritée, et corrigez-le avec le mode UTF-8, reconfigure ou encoding=.
Sur cette page
Votre requête a abouti, le modèle a répondu, puis Python a planté sur print(reply). L'API n'est pas en cause. La réponse est correcte ; l'endroit où vous l'affichez ne peut pas représenter certains de ses caractères. Le correctif le plus rapide consiste à activer le mode UTF-8 avec PYTHONUTF8=1. Si vous préférez le garder dans le script, appelez sys. en haut, et lorsque vous enregistrez une réponse dans un fichier, passez encoding="utf-8" à open().
À quoi ressemble l'erreur#
Supposez que vous posiez une question à un modèle en russe et que vous affichiez la réponse. Voici le script complet, utilisant l'appel requests simple de notre guide de première requête :
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
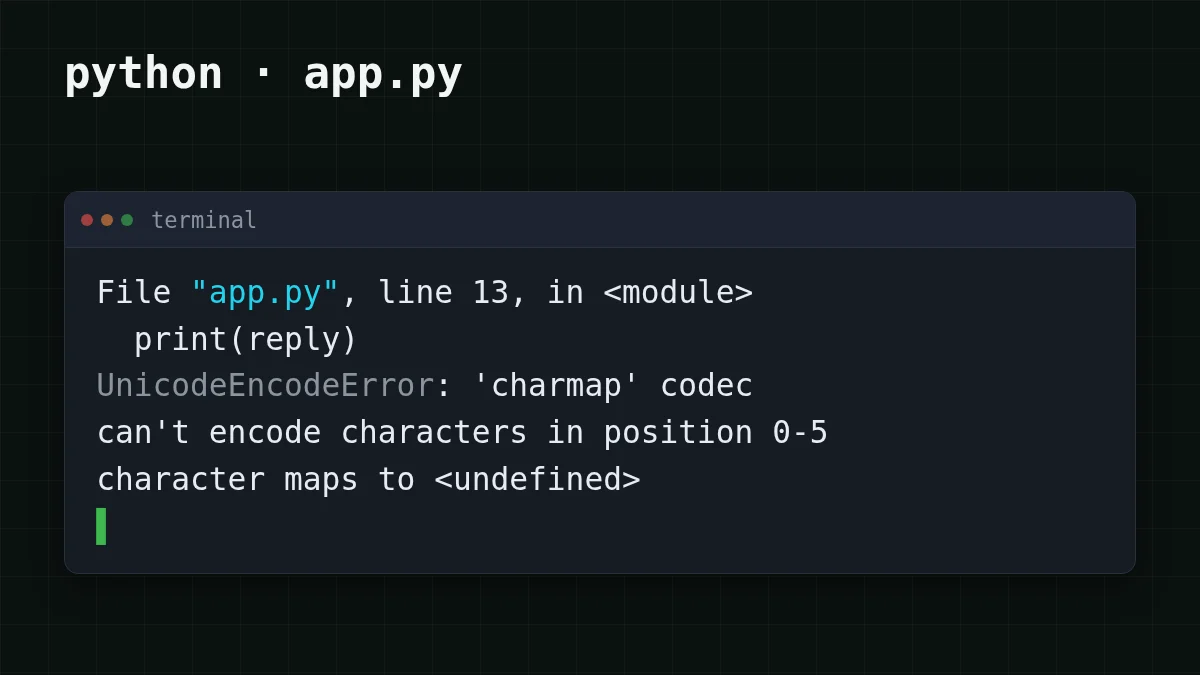
Lorsque stdout est redirigé vers un fichier ou un pipe, ou que Python a été démarré avec une page de code héritée pour ses flux, la dernière ligne se termine ainsi :
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>Le nom du codec dans votre message dépend de l'encodage du flux (pour une page de code Windows, c'est généralement charmap, pour ascii c'est ascii), et les positions dépendent de la réponse. La forme est toujours la même : la traceback pointe vers print, pas vers la requête.
Pourquoi cela se produit-il ? print convertit le texte en octets en utilisant l'encodage de sys.stdout. Si cet encodage est une page de code héritée, tout caractère hors de celle-ci, comme le cyrillique dans une page de code occidentale, un emoji, parfois un tiret typographique, n'a pas d'octet correspondant. Python lève une exception au lieu de deviner.
Cela se manifeste dans trois situations :
- stdout est redirigé ou piped (
python app.,py > out. txt | another program), ou le script s'exécute depuis un planificateur, une CI ou un éditeur où stdout n'est pas une console ; PYTHONLEGACYWINDOWSSTDIOest défini, ou le flux reçoit autrement un encodage étroit ;- vous écrivez la réponse dans un fichier avec
open(path, "w")et sansencoding=.
Quel Python ? Tout ce qui suit concerne Python 3.7–3.14, où l'encodage des flux et des fichiers provient du système. Selon le PEP 686 (statut Final, https://peps.python.org/pep-0686/, vérifié le 5 novembre 2026), le mode UTF-8 est activé par défaut à partir de Python 3.15, donc open() et stdio utilisent déjà UTF-8 à cet endroit, sauf si quelqu'un l'a désactivé avec PYTHONUTF8=0 ou -X utf8=0. Vérifiez avec python --version.
Vérifiez l'encodage que vous avez réellement#
Avant de changer quoi que ce soit, regardez ce que Python a choisi. Cela prend dix secondes.
Essayez vous-mêmeEssayez : quel est, selon Python, l'encodage de votre stdout ?Afficher la réponse
Exécutez python - dans la même fenêtre où le script échoue. Dans une console interactive, il affiche généralement utf-8, donc cela seul ne prouve pas grand-chose. Relancez avec > check.txt à la fin et ouvrez le fichier : c'est la sortie redirigée qui donne le plus souvent un nom cp… ou ascii, et c'est votre coupable. Si tout indique utf-8, regardez un fichier dans lequel vous écrivez.
Vous voulez voir le plantage sans attendre un mauvais jour ? Sous macOS ou Linux, forcez un encodage étroit pour une exécution :
PYTHONIOENCODING=ascii python -c "print('Привет')"Cela échoue avec un message de codec ascii, de la même famille que l'erreur ci-dessus. Sous Windows, la variable est ignorée pour une console interactive, mais elle fonctionne lorsque la sortie est redirigée : dans cmd, exécutez set PYTHONIOENCODING=ascii, puis python - (dans PowerShell : $env:PYTHONIOENCODING = "ascii").
Correctif 1 : activer le mode UTF-8#
Python dispose d'un mode qui fait d'UTF-8 l'encodage par défaut pour le texte. Selon la documentation Python (page ligne de commande, vérifiée le 5 novembre 2026), PYTHONUTF8=1 l'active et -X utf8 fait de même ; les deux existent depuis Python 3.7. Un piège signalé sur la même page : toute autre valeur non vide de PYTHONUTF8 provoque une erreur au démarrage, donc utilisez exactement 1 (ou 0 pour le désactiver). Sur 3.15, vous n'avez besoin de cela que pour activer explicitement le mode sur des interpréteurs plus anciens ; s'il y est déjà actif, cherchez PYTHONUTF8=0 dans votre environnement.
Activer le mode UTF-8 pour une exécution
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
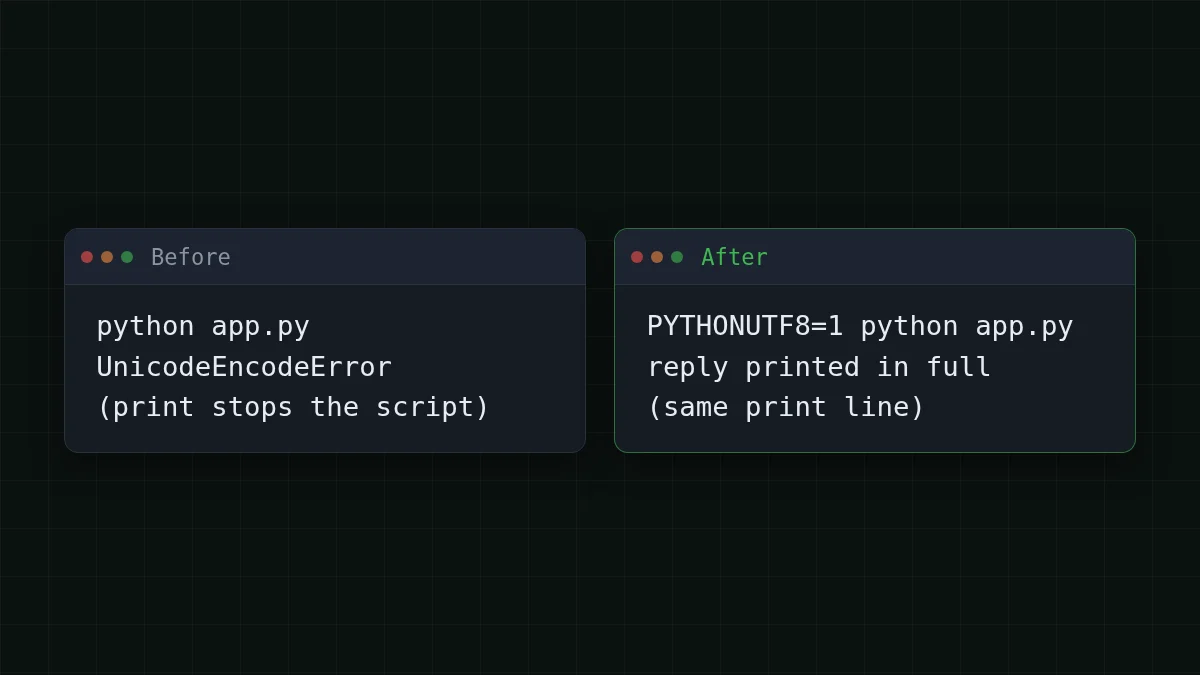
PYTHONUTF8=1 python app.pyAucune modification de code, et cela couvre la console, les redirections et les fichiers de cette exécution. Si vous ne voulez pas définir une variable à chaque fois, python - donne le même résultat depuis la ligne de commande.
Il existe aussi PYTHONIOENCODING=utf-, qui ne remplace que l'encodage de stdin, stdout et stderr. Lisez son entrée de documentation avant de vous y fier sous Windows : depuis Python 3.6, il est ignoré pour un tampon de console interactive sauf si PYTHONLEGACYWINDOWSSTDIO est défini. Les fichiers et pipes redirigés ne sont pas concernés par cette exception. Il peut donc corriger python app. et ne rien faire dans la fenêtre de console. Pour stderr, le gestionnaire d'erreurs est toujours backslashreplace.
Correctif 2 : reconfigurer stdout dans le script#
Si vous ne contrôlez pas la façon dont les gens lancent le script, modifiez le flux lui-même tout en haut :
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)
reconfigure est documenté pour io.TextIOWrapper (ajouté en 3.7). Lorsque vous passez encoding et omettez errors, le gestionnaire est strict, donc un caractère qui ne passe pas lève toujours une exception ; dans le cas courant d'UTF-8, il ne reste rien. Deux détails de la documentation : l'encodage ne peut pas être modifié une fois que des données ont été lues depuis le flux (il peut l'être après une écriture), et encoding="locale" est pris en charge depuis 3.11.
Besoin que le script ne plante jamais, même sur un terminal qui ne peut vraiment pas afficher le texte ? Ajoutez errors="replace". Les caractères inconnus apparaissent alors sous forme de ? au lieu d'arrêter l'exécution. Cela masque le problème plutôt que de le corriger, donc réservez-le aux logs.
Correctif 3 : donner un encodage explicite aux fichiers#
Enregistrer une réponse, c'est la même défaillance, juste plus discrète dans le code :
# before: on Python up to 3.14 this uses the system's default encoding
with open("reply.txt", "w") as f:
    f.write(reply)

# after: the file is UTF-8 on every machine
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
Utilisez le même encoding="utf-8" lorsque vous relisez le fichier, sinon le texte peut se casser à l'entrée à la place.
Quel correctif utiliser ?#
Choisissez votre cas
Choisissez votre cas
Choisissez une option pour voir la réponse
J'exécute mon propre script dans un terminal
Définissez PYTHONUTF8=1 une fois dans votre environnement, ou démarrez avec python -. Rien ne change dans le code.
Je distribue le script à d'autres personnes
Placez sys. en haut, pour qu'il fonctionne quelle que soit leur façon de le lancer.
Le plantage concerne un fichier, pas l'écran
Ajoutez encoding="utf-8" à open(), pour l'écriture et la lecture.
Vous pouvez les combiner. Un script qui affiche et enregistre des réponses a besoin du correctif 2 ou du correctif 1 pour l'écran et du correctif 3 pour le fichier.
Si cela échoue encore#
- L'erreur s'est déplacée vers une autre ligne. L'appel fautif est alors un autre
printouwrite; le correctif doit s'appliquer avant son exécution, donc placezreconfiguretout en haut. - L'erreur mentionne
PYTHONUTF8. La variable a une valeur autre que1ou0. Supprimez-la et redéfinissez-la. - Pas de plantage, mais vous voyez des carrés ou
?dans la console. Python a écrit de l'UTF-8 valide ; la police ou la page de code de la console ne peut pas l'afficher. Redirigez vers un fichier et ouvrez-le dans un éditeur pour confirmer que la réponse est intacte. - L'erreur est une
JSONDecodeError, pas uneUnicodeEncodeError. Problème différent : voir comment extraire du JSON d'une réponse de modèle.
Le code de requête ci-dessus est l'appel requests simple ; la documentation CheapTokens montre le même appel pour le SDK OpenAI. Un autre modèle fonctionne avec le même correctif : remplacez le champ model par zai- (jusqu'à 8 192 jetons de sortie par réponse, 390K de contexte). L'erreur d'encodage n'a rien à voir avec le modèle, seulement avec l'endroit où va le texte.


