Вирішення проблемПосібник
UnicodeEncodeError під час друку відповіді LLM у Python: 3 виправлення
print(reply) падає на кирилиці або емодзі? Дізнайтеся, чому Python зазнає невдачі з перенаправленим виводом або застарілою кодовою сторінкою, і виправте це за допомогою режиму UTF-8, reconfigure або encoding=.
На цій сторінці
Ваш запит пройшов, модель відповіла, а потім Python впав на print(reply). API тут не винне. Відповідь нормальна; місце, куди ви її виводите, не може представити деякі її символи. Найшвидше виправлення — увімкнути режим UTF-8 за допомогою PYTHONUTF8=1. Якщо ви хочете залишити це всередині скрипта, викличте sys. на початку, а коли зберігаєте відповідь у файл, передайте encoding="utf-8" у open().
Як виглядає помилка#
Припустімо, ви ставите моделі запитання російською і друкуєте відповідь. Ось весь скрипт, який використовує звичайний виклик requests з нашого посібника з першого запиту:
import os, requests

r = requests.post(
    "https://api.cheaptokens.dev/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"},
    json={
        "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "messages": [{"role": "user", "content": "Ответь одним предложением: что такое токен?"}],
        "max_tokens": 200,
    },
)
reply = r.json()["choices"][0]["message"]["content"]
print(reply)
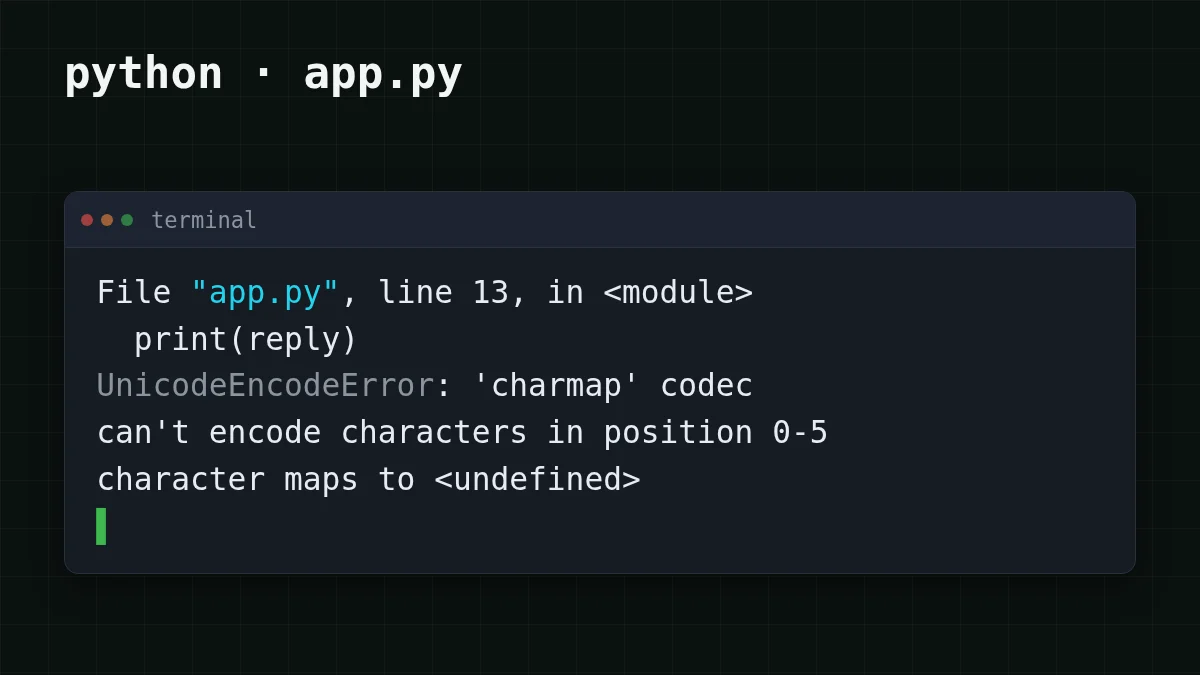
Коли stdout перенаправлено у файл або канал, або Python запущено з застарілою кодовою сторінкою для його потоків, останній рядок закінчується так:
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-5: character maps to <undefined>Назва кодека у вашому повідомленні залежить від кодування потоку (для кодової сторінки Windows це зазвичай charmap, для ascii — ascii), а позиції залежать від відповіді. Форма завжди однакова: трасування вказує на print, а не на запит.
Чому це відбувається? print перетворює текст у байти, використовуючи кодування sys.stdout. Якщо це кодування є застарілою кодовою сторінкою, будь-який символ поза нею, наприклад кирилиця в західній кодовій сторінці, емодзі, іноді типографське тире, не має байта для перетворення. Python викликає помилку замість того, щоб вгадувати.
Це проявляється в трьох ситуаціях:
- stdout перенаправлено або передано через канал (
python app.,py > out. txt | another program), або скрипт запускається з планувальника, CI чи редактора, де stdout не є консоллю; - встановлено
PYTHONLEGACYWINDOWSSTDIO, або потік інакше отримує вузьке кодування; - ви записуєте відповідь у файл за допомогою
open(path, "w")безencoding=.
Який Python? Усе нижче стосується Python 3.7–3.14, де кодування потоків і файлів походить від системи. Згідно з PEP 686 (статус Final, https://peps.python.org/pep-0686/, перевірено 5 листопада 2026 року), режим UTF-8 увімкнено за замовчуванням з Python 3.15, тому open() і stdio там уже використовують UTF-8, якщо хтось не вимкнув його за допомогою PYTHONUTF8=0 або -X utf8=0. Перевірте за допомогою python --version.
Перевірте, яке кодування у вас насправді#
Перш ніж щось змінювати, подивіться, що вибрав Python. Це займе десять секунд.
Спробуйте саміСпробуйте: що Python вважає кодуванням вашого stdout?Показати відповідь
Запустіть python - у тому самому вікні, де скрипт зазнає невдачі. В інтерактивній консолі він зазвичай виводить utf-8, тож це саме по собі мало що доводить. Запустіть його знову з > check.txt в кінці та відкрийте файл: перенаправлений вивід частіше дає назву cp… або ascii, і це ваш винуватець. Якщо все каже utf-8, подивіться на файл, у який ви пишете.
Хочете побачити збій, не чекаючи поганого дня? На macOS або Linux примусово встановіть вузьке кодування для одного запуску:
PYTHONIOENCODING=ascii python -c "print('Привет')"Це завершується помилкою з повідомленням про кодек ascii, з тієї ж родини, що й помилка вище. У Windows змінна ігнорується для інтерактивної консолі, але працює, коли вивід перенаправлено: у cmd виконайте set PYTHONIOENCODING=ascii, потім python - (у PowerShell: $env:PYTHONIOENCODING = "ascii").
Виправлення 1: увімкніть режим UTF-8#
У Python є режим, який робить UTF-8 типовим для тексту. Згідно з документацією Python (сторінка командного рядка, перевірено 5 листопада 2026 року), PYTHONUTF8=1 вмикає його, а -X utf8 робить те саме; обидва існують з Python 3.7. Одна особливість із тієї ж сторінки: будь-яке інше непорожнє значення PYTHONUTF8 спричиняє помилку під час запуску, тому використовуйте саме 1 (або 0, щоб вимкнути його). У 3.15 це потрібно лише для явного ввімкнення режиму на старіших інтерпретаторах; якщо там він уже ввімкнений, шукайте PYTHONUTF8=0 у вашому середовищі.
Увімкніть режим UTF-8 для одного запуску
cmd
set PYTHONUTF8=1
python app.py
PowerShell
$env:PYTHONUTF8 = "1"
python app.py
macOS / Linux
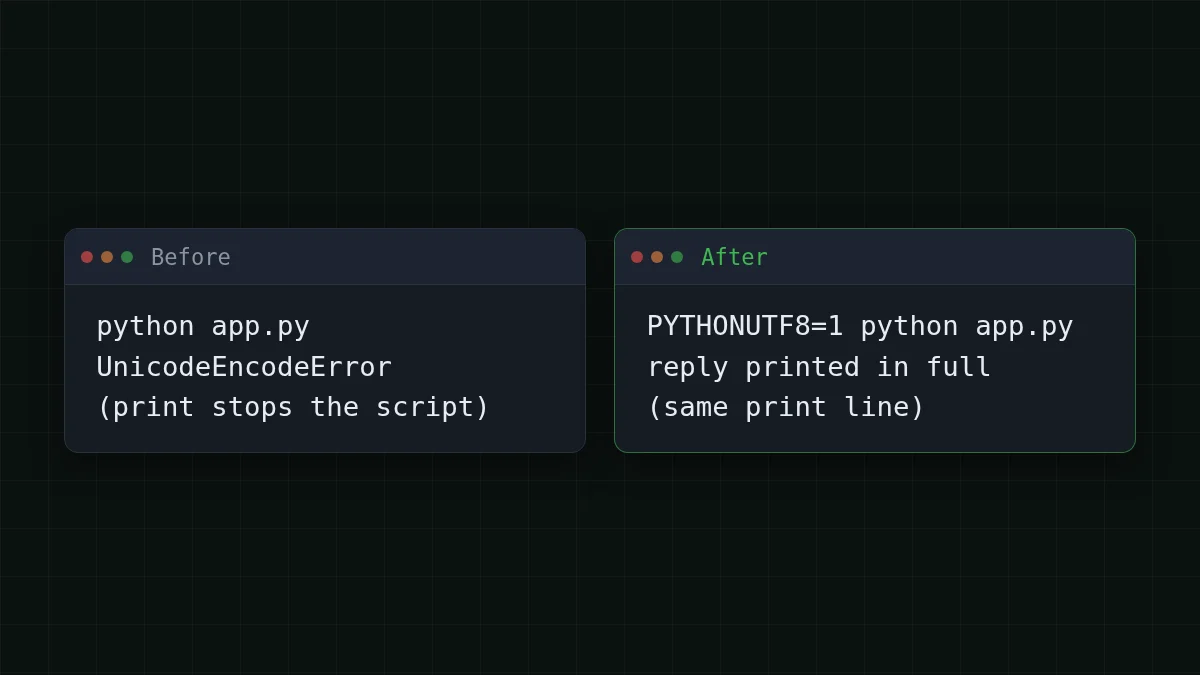
PYTHONUTF8=1 python app.pyБез змін у коді, і це охоплює консоль, перенаправлення та файли в цьому запуску. Якщо ви не хочете встановлювати змінну щоразу, python - дає той самий результат з командного рядка.
Також є PYTHONIOENCODING=utf-, який перевизначає кодування лише stdin, stdout і stderr. Прочитайте його запис у документації, перш ніж покладатися на нього в Windows: починаючи з Python 3.6, він ігнорується для інтерактивного буфера консолі, якщо не встановлено PYTHONLEGACYWINDOWSSTDIO. Перенаправлені файли та канали не підпадають під цей виняток. Тож він може виправити python app. і все одно нічого не робити у вікні консолі. Для stderr обробник помилок завжди backslashreplace.
Виправлення 2: переналаштуйте stdout всередині скрипта#
Якщо ви не можете контролювати, як люди запускають скрипт, змініть сам потік на самому початку:
import sys

sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")

print(reply)
reconfigure задокументовано для io.TextIOWrapper (додано в 3.7). Коли ви передаєте encoding і не вказуєте errors, обробником є strict, тому символ, який не підходить, все одно спричиняє помилку; для поширеного випадку UTF-8 нічого не залишається. Дві деталі з документації: кодування не можна змінити після того, як з потоку прочитано дані (можна після запису), а encoding="locale" підтримується з 3.11.
Потрібно, щоб скрипт ніколи не падав, навіть на терміналі, який справді не може показати текст? Додайте errors="replace". Невідомі символи тоді з'являться як ? замість зупинки запуску. Це приховує проблему, а не виправляє її, тому залиште це для журналів.
Виправлення 3: задайте файлам явне кодування#
Збереження відповіді — це та сама помилка, лише тихіша в коді:
# before: on Python up to 3.14 this uses the system's default encoding
with open("reply.txt", "w") as f:
    f.write(reply)

# after: the file is UTF-8 on every machine
with open("reply.txt", "w", encoding="utf-8") as f:
    f.write(reply)
Використовуйте той самий encoding="utf-8", коли читаєте файл назад, інакше текст може зламатися на вході.
Яке виправлення використовувати?#
Оберіть свій випадок
Виберіть свій випадок
Виберіть варіант, щоб побачити відповідь
Я запускаю свій скрипт у терміналі
Встановіть PYTHONUTF8=1 один раз у своєму середовищі або запускайте з python -. У коді нічого не змінюється.
Я передаю скрипт іншим людям
Помістіть sys. на початок, щоб він працював незалежно від того, як вони його запускають.
Збій у файлі, а не на екрані
Додайте encoding="utf-8" до open(), для запису та читання.
Ви можете комбінувати їх. Скрипт, який друкує та зберігає відповіді, потребує Виправлення 2 або Виправлення 1 для екрана та Виправлення 3 для файлу.
Якщо все ще не працює#
- Помилка перемістилася на інший рядок. Тоді виклик, що зазнає невдачі, — це інший
printабоwrite; виправлення має застосовуватися до його запуску, тому помістітьreconfigureна самому початку. - Помилка згадує
PYTHONUTF8. Змінна має значення, відмінне від1або0. Видаліть її та встановіть знову. - Немає збою, але ви бачите квадратики або
?у консолі. Python записав коректний UTF-8; шрифт консолі або кодова сторінка не можуть його відобразити. Перенаправте у файл і відкрийте файл у редакторі, щоб переконатися, що відповідь ціла. - Помилка — це
JSONDecodeError, а неUnicodeEncodeError. Інша проблема: дивіться як витягти JSON з відповіді моделі.
Код запиту вище — це звичайний виклик requests; документація CheapTokens показує той самий виклик для OpenAI SDK. Інша модель працює з тим самим виправленням: замініть поле model на zai- (до 8 192 вихідних токенів на відповідь, контекст 390K). Помилка кодування не має нічого спільного з моделлю, лише з тим, куди йде текст.


