Optymalizacja kosztówPrzewodnik
Ogranicz tokeny wyjściowe: długość odpowiedzi, max_tokens, sekwencje stop
Skróć odpowiedzi AI z założenia: poproś o ograniczony format, traktuj max_tokens jako limit, używaj sekwencji stop, a potem zobacz koszt 1000 żądań.
Na tej stronie
Twój bot odpowiada w 400 tokenach, gdy wystarczyłoby 100, a Ty płacisz za każdy z nich. Rozwiązanie tkwi głównie w prompcie: poproś o ograniczony format, traktuj max_tokens jako bezpiecznik, a nie pokrętło długości, i sprawdzaj usage., aby zobaczyć, co faktycznie wróciło.
Ma to znaczenie, ponieważ wyjście jest droższą stroną w każdym modelu, który oferujemy: zobacz aktualne ceny na stronie cennika. To samo pytanie, krótsza odpowiedź, mniejszy rachunek.
Zacznij od promptu, nie od limitu#
Załóżmy, że prowadzisz bota wsparcia z 2000 zgłoszeń dziennie. Każde zgłoszenie wymaga kategorii i jednego zdania uzasadnienia. Model pozostawiony sam sobie pisze przyjazny akapit, listę zastrzeżeń i ofertę dalszej pomocy. To tam trafia 400 tokenów.
Porównaj
To samo zgłoszenie, dwa prompty
Otwarty
System: Jesteś pomocnym asystentem wsparcia. User: Powiedz mi, jakiego rodzaju to zgłoszenie: "Moja karta została obciążona dwukrotnie za zamówienie 1182." Odpowiedź: akapit z powitaniem, wyjaśnieniem i ofertą pomocy (około 400 tokenów).
Ograniczony
System: Odpowiedz dokładnie dwiema liniami. Linia 1: kategoria, jedna z: billing, bug, other. Linia 2: uzasadnienie w maksymalnie 15 słowach. Bez powitania.
User: to samo zgłoszenie.
Odpowiedź: billing i jedno krótkie uzasadnienie (około 100 tokenów lub mniej).
Sztuczka polega na tym, że opisujesz kształt odpowiedzi: liczbę linii, zamkniętą listę etykiet, limit słów. "Bądź zwięzły" działa gorzej niż "dwie linie, 15 słów", ponieważ model ma coś konkretnego do policzenia. Jeśli potrzebujesz tylko etykiety, poproś o etykietę i nic więcej. Klasyfikator, który musi zwrócić billing, nie powinien mieć możliwości się tłumaczyć.
To samo dotyczy ekstrakcji JSON. Gdy model opakowuje Twój JSON w prozę, proza jest wyjściem, za które płacisz, a potem wyrzucasz. Umieść "Zwróć tylko obiekt JSON, bez tekstu przed nim ani po nim" w wiadomości systemowej. Aby sparsować to, co wraca, zobacz jak wyodrębnić JSON z odpowiedzi LLM.
max_tokens to pas bezpieczeństwa#
Kusi, aby ustawić max_tokens: 100 i uznać sprawę za załatwioną. Nie oczekuj od tego krótkich odpowiedzi. Dokumentacja API DeepSeek (sprawdzona 2 listopada 2026) opisuje max_tokens jako maksymalną liczbę tokenów, które mogą zostać wygenerowane w uzupełnieniu, przy czym wejście plus wyjście są ograniczone długością kontekstu modelu. To zatrzymuje generowanie. Nie sprawia, że model planuje krótszą odpowiedź.
Więc model, który chciał napisać 400 tokenów, a dostał 100, wręcza Ci zdanie, które kończy się w połowie, finish_reason ustawione na length, i rachunek za wszystkie 100 tokenów. Zapłaciłeś za odpowiedź, której nie możesz użyć. Dlaczego tak się dzieje i jak to naprawić, opisano w dlaczego odpowiedź AI urywa się w połowie zdania i poprawka finish_reason "length". Nie będę tego tutaj powtarzać.
Działający podział jest prosty:
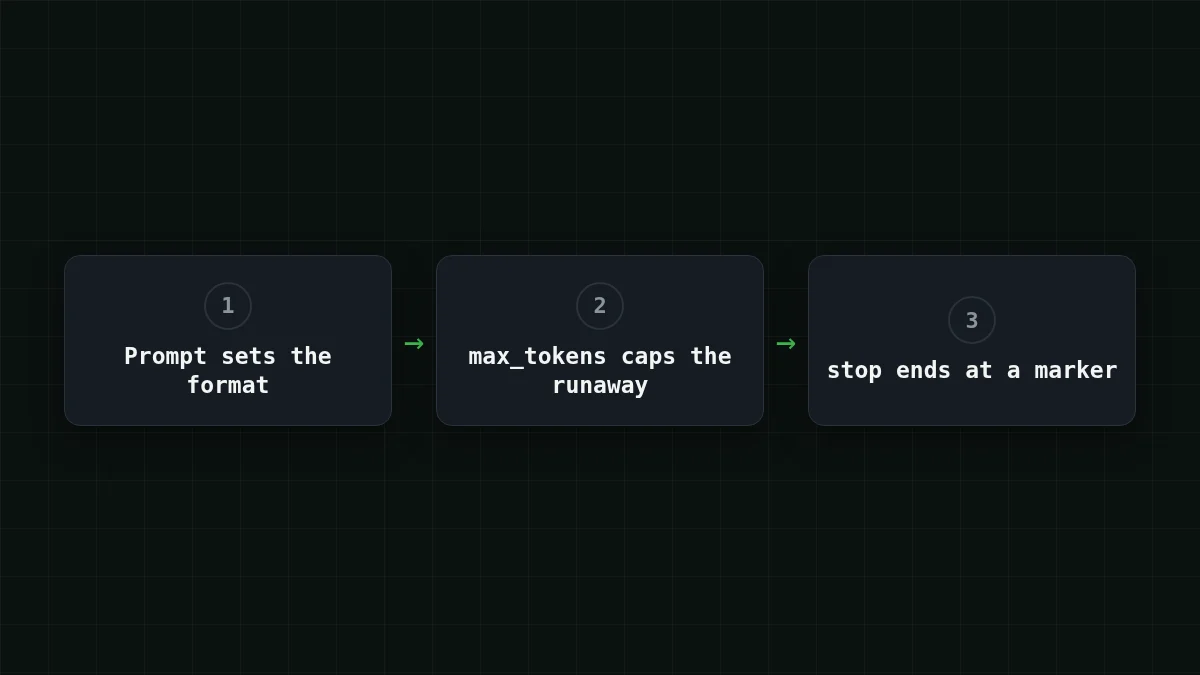
- prompt decyduje, jak długa jest dobra odpowiedź;
max_tokensznajduje się nieco powyżej najdłuższej dobrej odpowiedzi, więc wymykająca się odpowiedź zostanie ucięta, zamiast rosnąć do limitu wyjścia modelu (do 32 768 tokenów w DeepSeek-V4-Flash).
Dla dwuliniowej odpowiedzi na zgłoszenie 150 to aż nadto. Dla jedno słownej etykiety 20.
Sekwencje stop kończą odpowiedź na znaczniku#
W dokumentacji DeepSeek stop przyjmuje do 16 sekwencji, a generowanie zatrzymuje się, gdy model miałby wyprodukować jedną z nich. Gdy to nastąpi, finish_reason wynosi stop, tak samo jak przy naturalnym zakończeniu. Jest to przydatne, gdy Twój format ma znacznik końca. Poproś o odpowiedź, potem linię z END, i umieść END w stop. Przetestuj to raz na własnej konfiguracji: wykonaj jedno wywołanie i sprawdź, że finish_reason to stop, a tekst kończy się przed znacznikiem.
Jedna zasada: tekst stop musi być czymś, co nie może pojawić się wewnątrz dobrej odpowiedzi. Stop na \n\n ucina dwuakapitową odpowiedź po pierwszym akapicie.
Żądanie, które możesz uruchomić i zmierzyć#
Oto ograniczone wywołanie zgłoszenia. Identyfikator modelu to pełny gateway_id z dokumentacji CheapTokens, a bazowy URL to https:/. Dokumentacja pokazuje, jak utworzyć klucz; umieść go w zmiennej środowiskowej.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
W odpowiedzi liczą się dwie rzeczy: choices[0]. oraz obiekt usage z prompt_tokens i completion_. W Pythonie z pakietem openai wygląda to tak:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Uruchom to na dziesięciu prawdziwych zgłoszeniach, zanim zaufasz formatowi. Jeśli completion_ pozostaje małe, a finish_reason zawsze wynosi stop, to prompt wykonuje robotę. Jeśli widzisz length, Twój limit jest poniżej tego, czego potrzebuje dobra odpowiedź: podnieś go lub zaostrz prompt, ale nie oba na ślepo.
Dopasuj pary
Co mówią pola
Dotknij element po lewej, a następnie jego parę
- lengthOsiągnięto limit max_tokens
- stopNaturalny punkt zatrzymania lub sekwencja stop
- usage.completion_tokensTokeny w odpowiedzi, wyjściowa strona Twojego rachunku
Jeśli finish_reason nie jest stop, najpierw spójrz na limit.
Ile to oszczędza na 1000 żądań#
Teraz rachunek. Załóżmy, że zgłoszenie plus instrukcje to 300 tokenów wejściowych, otwarta odpowiedź to 400 tokenów wyjściowych, a ograniczona to 100. To założenia do przykładu; podmień liczby z własnego usage. Na 1000 żądań to 300 × 1000 = 300 000 tokenów wejściowych w obu przypadkach oraz 400 × 1000 = 400 000 tokenów wyjściowych w porównaniu do 100 × 1000 = 100 000.
Otwarte odpowiedzi, 1000 żądań:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 tokenów wejściowych i 400 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Ograniczone odpowiedzi, 1000 żądań:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 tokenów wejściowych i 100 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Strona wejściowa się nie zmienia i to jest sedno: tylko część, którą skróciłeś, staje się tańsza, a to ta część z wyższą ceną. Na model, te same 1000 zgłoszeń kosztuje $0.0445 w wersji otwartej i $0.0145 w wersji ograniczonej na DeepSeek-V4-Flash. W sumie, licząc wejście i wyjście razem, wszystkie trzy modele z tabel wychodzą taniej niż cena referencyjna OpenRouter. Dla krótkich odpowiedzi wybierz model z powyższych tabel: porównaj wiersze dla własnego wejścia i wyjścia. GLM-5.3-Flash ($0.04 za 1 mln tokenów wyjściowych) pasuje tam, gdzie odpowiedzi pozostają dłuższe, do 8192 tokenów; strona DeepSeek ma resztę.
Kolejność, w jakiej bym to zastosował#
Ustaw w kolejności
Ułóż kroki w sensownej kolejności
Przeciągnij elementy lub użyj strzałek
- Zapisz format odpowiedzi w prompcie
- Ustaw max_tokens nieco powyżej najdłuższej dobrej odpowiedzi
- Jeśli API akceptuje stop, a format ma znacznik końca, dodaj sekwencję stop
- Loguj completion_tokens i finish_reason dla każdego wywołania
- Porównaj koszt partii 1000 żądań przed i po
Krok 4 to ten, który ludzie pomijają. Bez niego nie wiesz, czy zmiana promptu zadziałała, czy kilka długich odpowiedzi zawyża średnią. Jeśli już śledzisz wydatki, podejście do liczenia tokenów w Pythonie i tokeny wejściowe vs wyjściowe to dobry punkt do kontynuacji.


