Maliyet optimizasyonuKılavuz
Çıktı tokenlarını azaltın: yanıt uzunluğu, max_tokens, durdurma dizileri
AI yanıtlarını tasarım gereği kısaltın: sınırlı bir format isteyin, max_tokens değerini sınır olarak tutun, durdurma dizileri kullanın, ardından 1.000 isteğin maliyetini görün.
Bu sayfada
Botunuz 100 token yeterliyken 400 token ile yanıt veriyor ve her biri için ödeme yapıyorsunuz. Çözüm büyük ölçüde prompt'ta: sınırlı bir format isteyin, max_tokens değerini uzunluk ayarı değil güvenlik sınırı olarak tutun ve gerçekte ne döndüğünü görmek için usage. değerini kontrol edin.
Bu önemli çünkü sunduğumuz her modelde çıktı daha pahalı taraftır: canlı fiyatlar için fiyatlandırma sayfasına bakın. Aynı soru, daha kısa yanıt, daha küçük fatura.
Sınırla değil, prompt'la başlayın#
Günde 2.000 bilet işleyen bir destek botu çalıştırdığınızı varsayalım. Her bilet bir kategori ve tek cümlelik bir gerekçe gerektiriyor. Kendi haline bırakılan model dostane bir paragraf, bir dizi uyarı ve daha fazla yardım teklifi yazıyor. 400 token buraya gidiyor.
Karşılaştır
Aynı bilet, iki prompt
Serbest
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: bir selamlama, bir açıklama ve yardım teklifi içeren bir paragraf (yaklaşık 400 token).
Sınırlı
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: aynı bilet.
Answer: billing ve kısa bir gerekçe (yaklaşık 100 token veya daha az).
İşin püf noktası, yanıtın şeklini tanımlamanızdır: satır sayısı, kapalı bir etiket listesi, kelime sınırı. "Kısa ol" ifadesi "iki satır, 15 kelime"den daha kötü çalışır çünkü modelin sayabileceği somut bir şey olur. Yalnızca bir etiket gerekiyorsa etiketi isteyin, başka bir şey istemeyin. billing döndürmesi gereken bir sınıflandırıcının kendini açıklamasına izin verilmemelidir.
Aynısı JSON çıkarımı için de geçerli. Model JSON'unuzu düz metin içine sardığında, bu metin ödediğiniz ve sonra attığınız çıktıdır. Sistem mesajına "Return only the JSON object, no text before or after it" yazın. Döneni ayrıştırmak için bir LLM yanıtından JSON nasıl çıkarılır yazısına bakın.
max_tokens bir emniyet kemeridir#
max_tokens: 100 değerini ayarlayıp işi bitmiş saymak cazip gelir. Ondan kısa yanıtlar beklemeyin. DeepSeek'in API referansı (2 Kasım 2026'da kontrol edildi) max_tokens değerini tamamlamada üretilebilecek maksimum token sayısı olarak tanımlıyor; girdi artı çıktı modelin bağlam uzunluğuyla sınırlanıyor. Üretimi durdurur. Modelin daha kısa bir yanıt planlamasını sağlamaz.
Yani 400 token yazmak isteyen ve 100 alan bir model size ortasından kesilen bir cümle, length olarak ayarlanmış finish_reason ve 100 tokenın tamamı için bir fatura verir. Kullanamadığınız bir yanıt için ödeme yaptınız. Bunun neden olduğu ve nasıl düzeltileceği bir AI yanıtı neden cümle ortasında durur ve finish_reason "length" düzeltmesi yazılarında ele alınıyor. Burada tekrarlamayacağım.
İşleyen ayrım basittir:
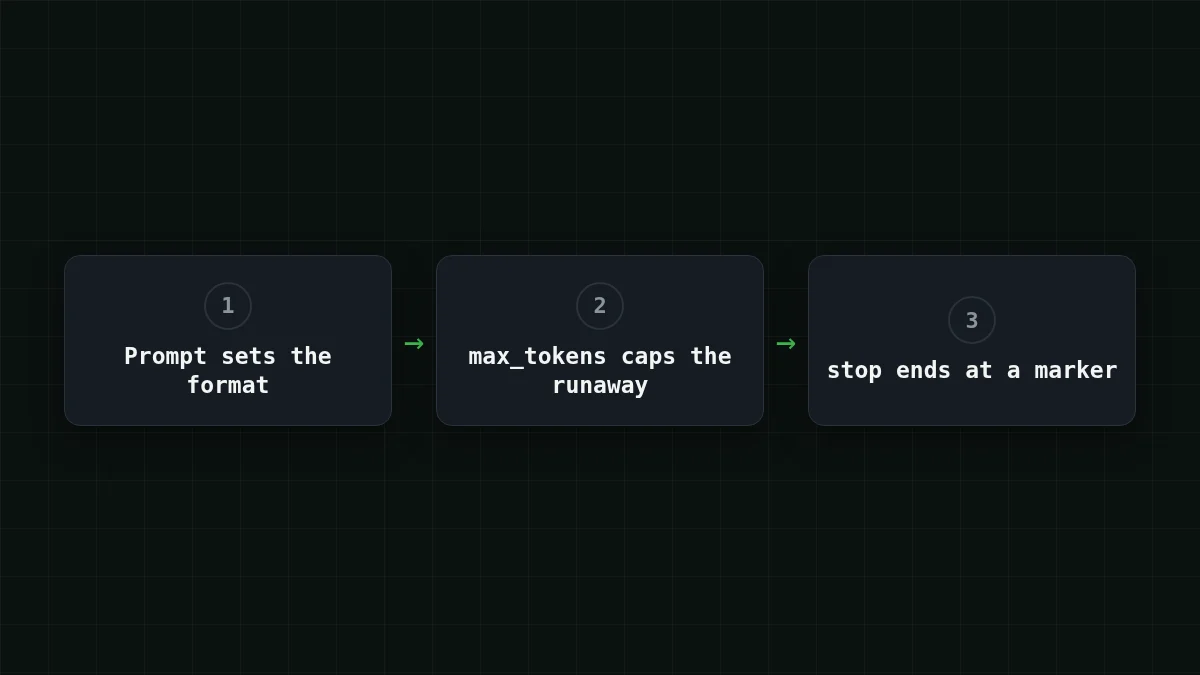
- prompt iyi bir yanıtın ne kadar uzun olacağına karar verir;
max_tokensen uzun iyi yanıtın biraz üzerinde durur, böylece kontrolden çıkan bir yanıt modelin çıktı sınırına kadar büyümek yerine kesilir (DeepSeek-V4-Flash'te 32.768 token'a kadar).
İki satırlık bilet yanıtı için 150 fazlasıyla yeterli. Tek kelimelik bir etiket için 20.
Durdurma dizileri bir yanıtı işaretçide bitirir#
DeepSeek'in referansında stop en fazla 16 dizi alır ve model bunlardan birini üretecek olduğunda üretim durur. Bu olduğunda finish_reason, doğal bir bitişteki gibi stop olur. Bu, formatınızda bir bitiş işaretçisi olduğunda kullanışlıdır. Yanıtı isteyin, ardından END içeren bir satır isteyin ve END değerini stop içine koyun. Kendi kurulumunuzda bir kez test edin: bir çağrı yapın ve finish_reason değerinin stop olduğunu ve metnin işaretçiden önce bittiğini kontrol edin.
Bir kural: durdurma metni iyi bir yanıtın içinde görünemeyecek bir şey olmalıdır. \n\n üzerinde bir durdurma, iki paragraflık bir yanıtı ilk paragraftan sonra keser.
Çalıştırıp ölçebileceğiniz bir istek#
İşte sınırlı bilet çağrısı. Model kimliği CheapTokens belgelerindeki tam gateway_id ve temel URL https:/. Belgeler bir anahtarın nasıl oluşturulacağını gösteriyor; onu bir ortam değişkenine koyun.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
Yanıtta iki şey önemlidir: choices[0]. ve prompt_tokens ile completion_ içeren usage nesnesi. Python'da openai paketiyle şöyle görünür:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Formata güvenmeden önce on gerçek bilet üzerinde çalıştırın. completion_ küçük kalıyorsa ve finish_reason her zaman stop ise, işi prompt yapıyor demektir. length görüyorsanız, sınırınız iyi bir yanıtın ihtiyaç duyduğunun altındadır: sınırı yükseltin veya prompt'u sıkılaştırın, ikisini birden körlemesine yapmayın.
Eşleştir
Alanların size ne söylediği
Soldaki bir öğeye, ardından eşine dokun
- lengthmax_tokens sınırına ulaşıldı
- stopDoğal bir durma noktası veya bir durdurma dizisi
- usage.completion_tokensYanıttaki tokenlar, faturanızın çıktı tarafı
finish_reason, stop değilse önce sınıra bakın.
1.000 istekte ne tasarruf sağlar#
Şimdi fatura. Bir bilet artı talimatların 300 girdi tokenı olduğunu, serbest yanıtın 400 çıktı tokenı ve sınırlı olanın 100 olduğunu varsayalım. Bunlar örnek için varsayımlardır; kendi usage değerlerinizdeki sayıları koyun. 1.000 istekte bu, her iki durumda da 300 × 1.000 = 300.000 girdi tokenı ve 400 × 1.000 = 400.000 çıktı tokenına karşı 100 × 1.000 = 100.000 demektir.
Serbest yanıtlar, 1.000 istek:
| Model | Giriş $/1M | Çıkış $/1M | İstek başına | 1.000 istek | OpenRouter, 1.000 istek |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
İstek başına 300 giriş ve 400 çıkış token'ı. 1M token başına fiyatlar günceldir ve tarifelerimizle birlikte değişir; OpenRouter sütunu aynı iş yükü için referans fiyatları gösterir.
Sınırlı yanıtlar, 1.000 istek:
| Model | Giriş $/1M | Çıkış $/1M | İstek başına | 1.000 istek | OpenRouter, 1.000 istek |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
İstek başına 300 giriş ve 100 çıkış token'ı. 1M token başına fiyatlar günceldir ve tarifelerimizle birlikte değişir; OpenRouter sütunu aynı iş yükü için referans fiyatları gösterir.
Girdi tarafı değişmiyor ve asıl mesele de bu: yalnızca kısalttığınız kısım ucuzluyor ve bu, fiyatı daha yüksek olan kısım. Model başına aynı 1.000 bilet DeepSeek-V4-Flash'te serbest olarak $0.0445 ve sınırlı olarak $0.0145 tutuyor. Toplamda, girdi ve çıktı birlikte sayıldığında, tablolardaki üç modelin tamamı OpenRouter'ın referans fiyatından daha ucuza geliyor. Kısa yanıtlar için yukarıdaki tablolardan modeli seçin: kendi girdi ve çıktınız için satırları karşılaştırın. GLM-5.3-Flash (1M çıktı tokenı başına $0.04) yanıtların daha uzun kaldığı, 8.192 token'a kadar olan yerler için uygundur; geri kalanı DeepSeek sayfasında var.
Bunu uygulayacağım sıra#
Sıraya koy
Adımları mantıklı bir sıraya koyun
Öğeleri sürükle veya okları kullan
- Yanıt formatını prompt'a yazın
- max_tokens değerini en uzun iyi yanıtın biraz üzerine ayarlayın
- API stop kabul ediyorsa ve formatta bir bitiş işaretçisi varsa bir durdurma dizisi ekleyin
- Her çağrı için completion_tokens ve finish_reason değerlerini günlüğe kaydedin
- 1.000 isteklik bir partinin maliyetini öncesi ve sonrasıyla karşılaştırın
İnsanların atladığı adım 4'tür. O olmadan prompt değişikliğinin işe yarayıp yaramadığını veya birkaç uzun yanıtın ortalamayı yukarı çekip çekmediğini bilemezsiniz. Harcamayı zaten takip ediyorsanız, Python'da token sayma yaklaşımı ve girdi ile çıktı tokenları devam etmek için iyi bir yerdir.


