Optimasi biayaPanduan
Estimasi biaya API turnamen model sebelum Anda menjalankannya
Hitung token per kursi, kalikan dengan permainan dan tukar sisi, dan pasang batas keras di Python: estimasi terperinci untuk turnamen model 6 kursi, 60 permainan.
Di halaman ini
Anda bisa mengetahui tagihan sebuah turnamen model sebelum permintaan pertama: hitung token yang dikirim satu kursi selama satu permainan penuh, kalikan dengan jumlah kursi dan permainan, lalu pasang batas keras di kode. Bagian yang sering terlewat adalah riwayat. Setiap giliran mengirim ulang semua yang sudah dikatakan, jadi input tumbuh jauh lebih cepat daripada jumlah giliran.
Apa yang bisa dan tidak bisa diberitahu oleh angka $20.000#
Pada 5 November 2026, podcaster Dwarkesh Patel menerbitkan Clocktower Bench, sebuah benchmark di mana model memainkan permainan deduksi sosial Blood on the Clocktower satu sama lain. Ia mengatakan menghabiskan sekitar $20.000 kredit API untuk membangun harness, dan sebagian besar habis untuk iterasi desain lingkungan, lebih banyak daripada token yang ia rencanakan.
README proyek (diperiksa 8 November 2026) menjelaskan pengaturannya: 11 model, 386 permainan untuk peringkat utama, satu model memainkan setiap kursi baik dan model lain setiap kursi jahat, 10–12 pemain, permainan yang berlangsung beberapa jam. Setiap pembagian dimainkan ulang dengan sisi ditukar, sehingga tidak ada model yang mendapat peran lebih mudah. Proyek ini juga menyertakan dry run gratis (--model random), menulis pengeluaran ke games/, dan memiliki batas --budget yang default-nya $1.000.
Yang tidak diberikan adalah token per permainan. Jadi tidak ada yang bisa disalin; Anda membangun estimasinya sendiri. Itulah yang dilakukan sisa artikel ini, dengan asumsi yang dinyatakan dan bisa Anda ganti dengan milik Anda sendiri.
Satu kursi: mengapa input terus tumbuh#
Katakan Anda menjalankan permainan lebih kecil: 6 kursi, setiap kursi adalah model dengan percakapannya sendiri, 20 giliran per kursi. Asumsikan system prompt 2.000 token (aturan dan peran kursi), 600 token baru obrolan meja yang datang sebelum setiap giliran, dan balasan 300 token. API tidak punya memori, jadi setiap permintaan membawa seluruh percakapan lagi (mengapa obrolan panjang lebih mahal).
Giliran 1 mengirim 2.000 + 600 = 2.600 token. Giliran 20 mengirim 2.000 + 600 × 20 + 300 × 19 = 19.700. Coba angka terakhir sendiri:
Tebak angkanya
Berapa token input yang dikirim satu kursi pada giliran ke-20?
Tebakan Anda
040.000
Tampilkan jawaban
Jawaban: 19.700
19.700: system prompt 2.000 token, 20 × 600 obrolan baru, dan 19 balasan sebelumnya masing-masing 300. Setiap balasan lama dan setiap pesan lama dikirim kembali.
Jumlahkan semua 20 giliran untuk satu kursi: 2.000 × 20 + 600 × 210 + 300 × 190 = 40.000 + 126.000 + 57.000 = 223.000 token input. Outputnya hanya 20 × 300 = 6.000. Jika Anda menghitung setiap pesan sekali, Anda akan mendapat 2.000 + 20 × 600 = 14.000 dan meleset enam belas kali lipat.
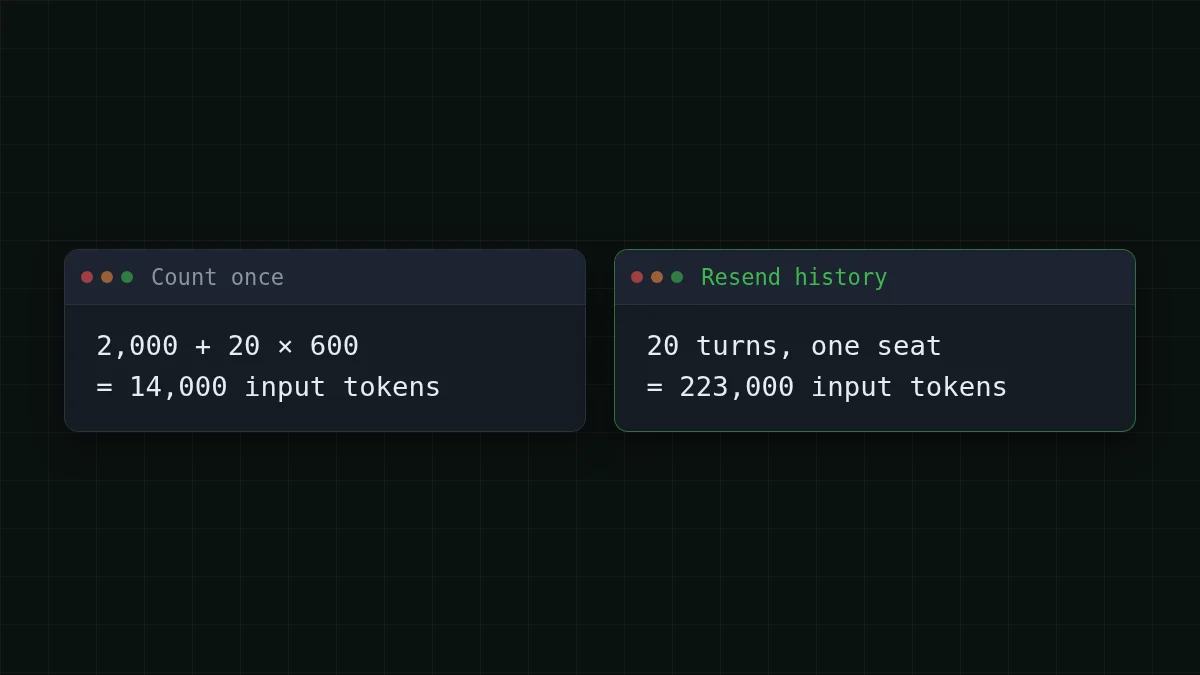
Sisi output hampir tidak bergerak. Input adalah tempat uang pergi, dan itulah sisi yang memburuk seiring permainan menjadi lebih panjang.
Dari satu kursi ke seluruh turnamen#
Sekarang skalakan dengan tiga pengali.
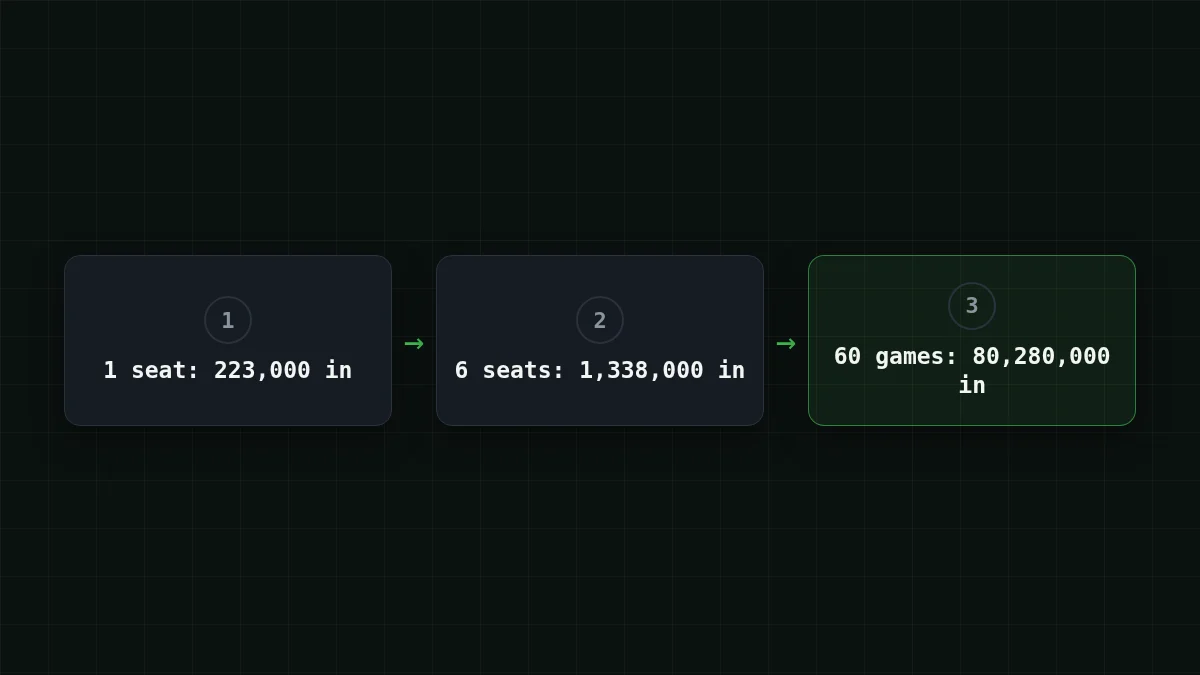
- Kursi. 6 kursi × 223.000 = 1.338.000 token input dan 6 × 6.000 = 36.000 token output per permainan.
- Tukar sisi. Ambil 3 model dalam round robin: 3 pasangan. Mainkan 10 pembagian per pasangan, masing-masing dua kali dengan sisi ditukar: 3 × 10 × 2 = 60 permainan.
- Permainan. 60 × 1.338.000 = 80.280.000 input dan 60 × 36.000 = 2.160.000 token output untuk turnamen.
Satu permainan pada DeepSeek-V4-Flash menjadi $0.0237. Tabel di bawah memberi harga seluruh turnamen 60 permainan seolah-olah model itu memainkan setiap kursi, sehingga Anda bisa membandingkan tiga model yang ditawarkan CheapTokens untuk pekerjaan percakapan panjang seperti ini. Secara total, dengan input dan output dihitung bersama, masing-masing lebih murah daripada referensi OpenRouter di kolom terakhir.
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 60 permintaan | OpenRouter, 60 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
1.338.000 token input dan 36.000 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Dari sisi anggaran inilah seluruh triknya: Anda tidak perlu pos anggaran $20.000 untuk mengetahui model mana dari tiga yang lebih baik memainkan permainan negosiasi. Anda perlu estimasi di atas, lalu pilot sungguhan untuk memeriksanya.
Cek cepat
Permainan 6 kursi Anda naik dari 20 ke 40 giliran per kursi. Apa yang terjadi pada tagihan input?
Tampilkan jawaban
Jawaban: Tumbuh sekitar 3,6 kali
Untuk 40 giliran rumus yang sama memberi 2.000 × 40 + 600 × 820 + 300 × 780 = 806.000 token input, dibandingkan 223.000 untuk 20 giliran. Suku riwayat tumbuh sebanding kuadrat jumlah giliran.
Dua pemeriksaan sebelum Anda mempercayai angka semacam itu. Pertama, permintaan terbesar harus muat di jendela model. Pada 20 giliran permintaan terbesar adalah 19.700 token, tidak masalah. Permainan berjam-jam dengan 200 giliran per kursi mencapai 2.000 + 600 × 200 + 300 × 199 = 181.700, sekitar 182K, jadi baca ukuran konteks di halaman model sebelum Anda merancang permainan. DeepSeek-V4-Flash memiliki jendela 380K dan hingga 32.768 token output; lihat halaman model. Kedua, jika model mengeluarkan penalaran panjang, 300 token output Anda menjadi lebih banyak (token berpikir dalam pekerjaan massal).
Pasang batas keras di kode#
Flag --budget di README adalah ide yang tepat, dan butuh sepuluh baris untuk disalin ke harness Anda sendiri. Skrip di bawah mengestimasi sebelum berjalan, menolak mengirim permintaan yang bisa mendorong total melewati batas, dan mencatat setiap panggilan ke file ledger. Harga di dalamnya adalah contoh: ganti dengan yang terkini dari tabel harga.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) mencetak (1338000, 36000), angka per permainan yang sama seperti di atas, sehingga kode dan aritmetika saling memeriksa. usage. dan usage. berasal dari respons dan itulah yang Anda ditagih; pra-pemeriksaan menggunakan hitungan karakter yang pesimistis karena hitungan sebenarnya baru diketahui setelah panggilan. Lebih lanjut tentang ledger per proyek di melacak biaya token agen di Python.
Urutan aman untuk eksekusi pertama#
Urutan dari repo itu sendiri adalah model yang baik: gratis dulu, murah kedua, mahal terakhir. Susun langkah-langkah ini dalam urutan:
Urutkan
Susun langkah-langkah eksekusi pertama yang aman dalam urutan
Seret item atau gunakan panah
- Dry run dengan pemain acak, tanpa panggilan API
- Jalankan
estimate()dan bandingkan dengan batas Anda - Mainkan satu permainan sungguhan dan baca ledger
- Koreksi asumsi dengan hitungan token sebenarnya
- Luncurkan turnamen penuh dengan batas aktif
README mengatakan permainan demo pada model murah berbiaya sekitar $2–5. Itu pernyataan penulis dan modelnya tidak disebutkan, jadi perlakukan sebagai rentang kewajaran, bukan kutipan untuk pengaturan Anda. Permainan pilot Anda sendiri memberi angka yang penting: jika ledger-nya menunjukkan 1.500.000 token input padahal Anda mengasumsikan 1.338.000, Anda sudah belajar sesuatu dengan biaya beberapa sen alih-alih pada permainan ke-40.
Untuk eksperimen lebih panjang, tuas yang biasa ada di memangkas riwayat obrolan: potong apa yang harus dibaca ulang setiap kursi, dan suku kuadratik menyusut bersamanya. Saat siap menjalankannya, dokumentasi memiliki endpoint dan id model.


